数据库的用户换了:Agent 时代的记录系统与上下文层
数据库的头号用户从人变成 Agent,它因此裂成两条腿:一条存状态,一条供上下文。而检索本身也从召回算法问题,变成了编排与编译问题。这篇把两篇文章、四篇论文和六家厂商的公开资料摆在一起,看这条演进走到哪一步。
一句话 数据库的头号用户从人换成了 Agent,于是它裂成两条腿:一条存状态、按需供给,一条供上下文、提前编译。真正变的不只是形态,是"检索"这件事的定义——从召回算法,变成编排框架加编译供给。
一、问题:报错是写给人看的#
先看一个不起眼的改动。Supabase 把自己全部报错信息翻出来重做了一遍:不再是 500 Internal Server Error,而是在返回文本里直接写明——你为什么触发这个错误、现在该执行哪条命令修、或者去读哪个 URL 的文档。
这个改动的动机是留存。人类程序员看到天书般的报错,会自己去 Google;Agent 看到同样的报错,会放弃并切到竞品。两家公司争的是"卡住之后它还愿不愿意再试一次"。
它暴露的是更底层的事:数据库的设计假设全部建立在"用户是人"之上。Dashboard 给人点,API 给人调,报错给人读,实例给人规划。把这些假设逐条拿掉,剩下的才是 Agent 需要的东西。
三个已经量化的断裂:
| 断裂 | 事实 | 来源 |
|---|---|---|
| 供给颗粒度 | Supabase 周新建数据库 >100 万个,托管库从 800 万涨到近 5000 万(一年) | 官网公布(YC 播客) |
| 使用者身份 | 约 70% 的新增活动来自 Agent;72.1% 的组织已有 Agent 在生产运行 | 官网公布 / IDC FERS n=903 |
| 上下文成本 | Agent 约 85% 的计算精力消耗在"重新发现"循环上,而非任务本身 | Pinecone 估算 |
第三条最难缠。如果每次提问都要从零开始探索一遍语料,那么数据规模每涨一个量级,成本和延迟就跟着涨一个量级。
二、业界已经解决到什么程度#
过去 18 个月,这条线上发生的事可以压缩成五条可核对的主张,每条都带着后果。
| 主张 | 出处 | 后果 |
|---|---|---|
| 工具结果的交付方式比检索算法更能决定准确率;inline 交付下 grep 在每一个 Harness×模型组合上都胜过向量检索 | PwC《Is Grep All You Need?》,arXiv:2605.15184 | 检索从"设计更强的召回"变成"设计更好的编排" |
| 只靠字符串匹配的 Agentic RAG,质量已接近 LLM 编译的 Wiki | arXiv:2605.18490(预注册对比) | “编译派"相对"编排派"的超额收益边界收窄 |
| 把工具拆成 SEARCH / FIND / OPEN 三种,消融显示最大增益来自"单次检索 → Agentic 工具使用” | 微软 AgenticRAG,arXiv:2605.05538 | 工具体系的分工设计成为工程核心 |
| 到 2031 年,“Agentic 统一决策引擎"将占 DBMS 市场 60% | Gartner(2026-03) | 数据库厂商的演进路线被写进采购语言 |
| 独立向量数据库的采用份额在下降,混合检索意向翻了约三倍到 33.3% | VentureBeat Q1 2026 Pulse | 纯向量检索作为独立品类的窗口在关闭 |
这五条合起来说明一件事:这一轮的胜负手是"谁能把上下文以更低的成本送到模型面前”。存储已经商品化,上下文还没有。
三、设计:把"给 Agent 用的数据库"拆成四条要件#
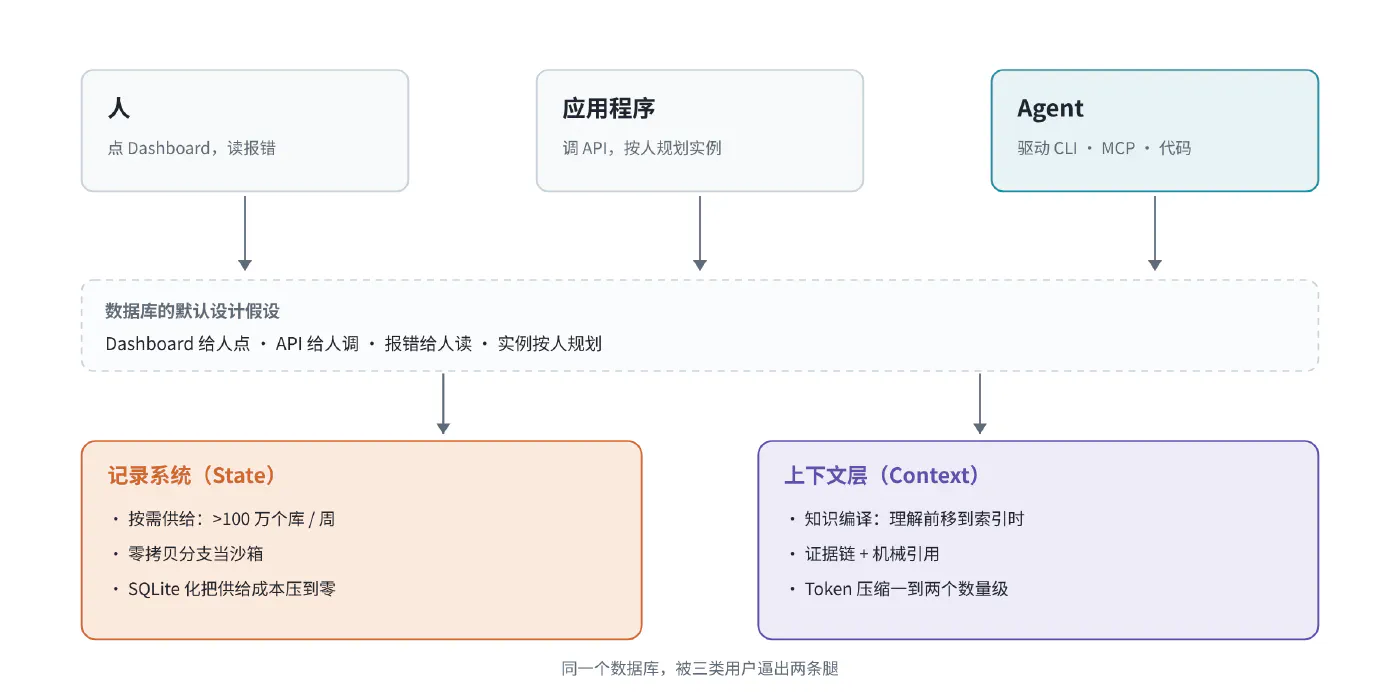
把各家做法摊开看,能收敛成四条要件,缺一条就会在某个场景里断。
- 供给颗粒度能缩到零。Agent 会为一次任务建一个库,用完就扔。售价必须随之趋零,否则商业模型不成立——SQLite 一台服务器管数百万个库,Postgres 实例做不到。
- 接口必须是代码与协议。Agent 不看 Dashboard,它看 CLI、看代码、看 MCP 的 tool 描述。Dashboard 上有的能力,代码里必须同步有。
- 失败必须能自愈。报错信息是新的文档,也是新的 UI。
- 上下文必须可编译、可追溯。答案要能指回确切的那一段原文,而不是靠相似度反推。
在此之上有两条原则,决定了架构长什么样:
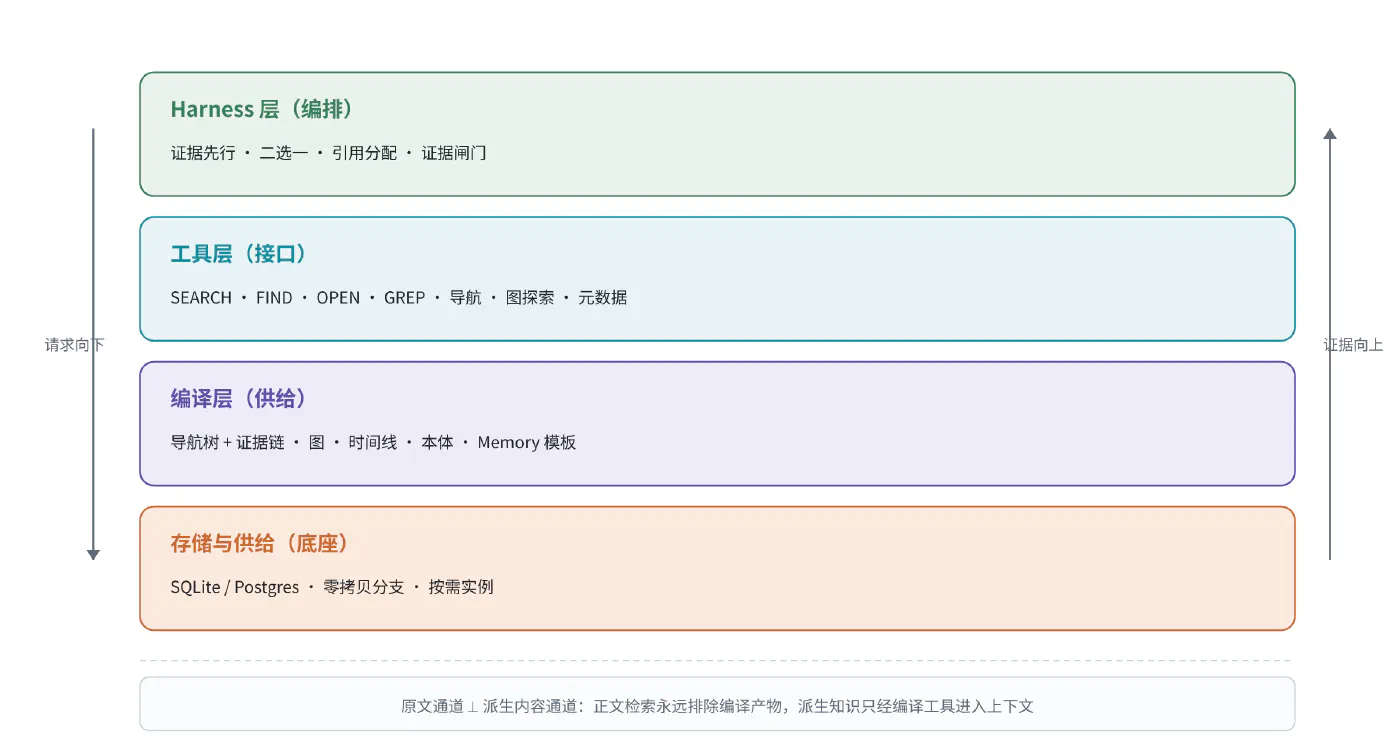
原则一:记录系统与上下文层分离。 原文通道与派生内容通道严格隔离——面向模型阅读的正文检索,永远排除编译产物;编译结构只通过编译工具进入上下文。派生知识不冒充原文,原文也不被结构淹没。
原则二:决定权分层。 框架负责不能被委托的事(证据够不够、要不要发、引用编号),模型只做它真正擅长的(用什么词搜、先读哪篇、这段是否相关),检索引擎只做机械执行(匹配、排序、过滤)。三者混在一起的系统,最后都会退化成"反复改同一组关键词"的盲目循环。
四、实现:从上到下四层#
4.1 供给层:把数据库做成一次性文件#
最激进的一支是 AgentDB 的思路:数据库不是持久基础设施,而是一个轻量、可弃置的工件,创建它应该和生成一个唯一 ID 一样简单。嵌入式引擎(SQLite、DuckDB)承担实际存储。
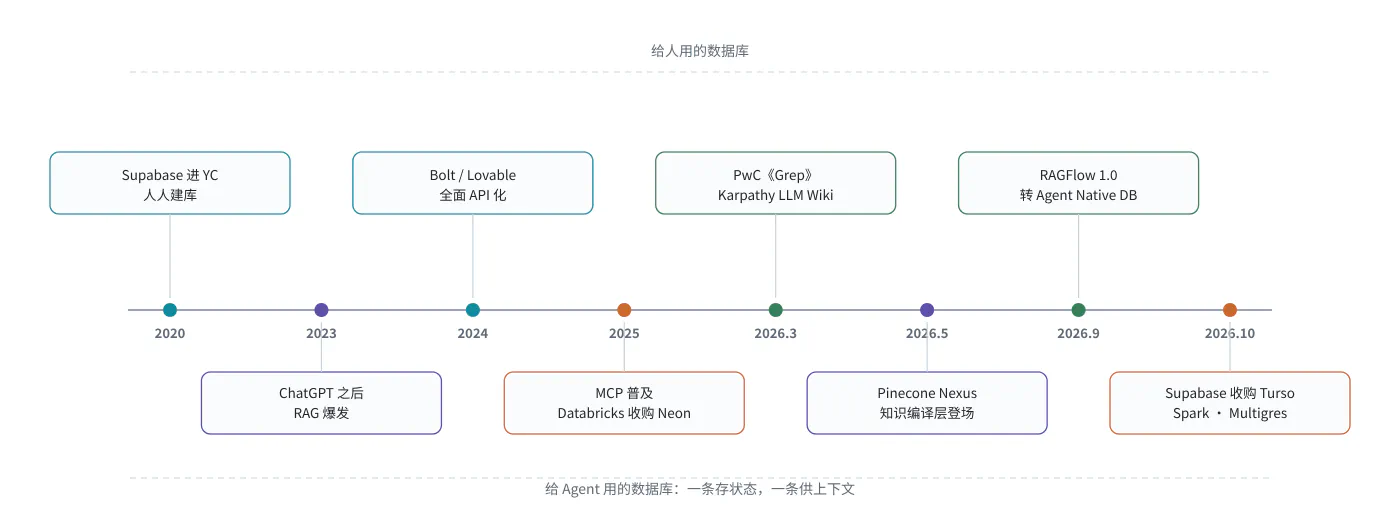
演化派的答案在另一端:Tiger Data 给 Postgres 加了零拷贝 fork 的存储层,让 Agent 可以在生产库的瞬时分支上试 schema、跑实验、验证代码;Neon 的 copy-on-write 分支随 Databricks 收购成为 Lakebase 的底座;OceanBase 的 seekdb 把 FORK/MERGE 沙箱直接写进卖点。
Supabase 的选择最直白:一手留住 Postgres 往上做到 PB 级(Multigres 做连接池与多节点故障转移,OrioleDB 做存储引擎),一手收购 Turso 把门槛压到最低——SQLite 系、Rust 重写、一台服务器管数百万库;中间再补一个轻量的 Spark(Rust 实现,SQLite 引擎加 Postgres 兼容 SQL 层,PostgREST 与 Auth 兼容 API)。它自己的说法是"从原型到 PB"。
值得记一笔的是商业逻辑:AWS 约 40% 的营收来自 Day 1 就长在上面的客户。说服任何人迁移数据库几乎不可能,所以策略只能是——永远出现在起步的那一天。
4.2 接口层:MCP 与 Code-First#
Agent 的交互模态已经收敛:CLI、代码、MCP。2026 年,主流数据库平台基本都有了官方 MCP Server,第三方也长出了十几款(Google MCP Toolbox、DBHub、Postgres MCP Pro 等)。
值得注意的是 Google MCP Toolbox 的形状:它是一个控制平面——用 tools.yaml 把允许的操作预先定义好并参数化,Agent 只能按名字调,不能自由拼 SQL。这个方向对企业合规是好消息:“Agent 直连数据库"会很快被"Agent 经治理层访问数据库"取代。
Supabase 的三阶段自述值得抄下来当坐标:最早是 Dashboard 公司,后来是 API 公司,现在是 Code-First 公司。每一阶段都是被上一阶段的用户抛弃后被迫转身。
4.3 编译层:把"理解"从查询时前移到索引时#
朴素 RAG 的致命处不是"搜不准”,而是每一次查询都是一次冷启动:系统不记得上次理解了什么、文档之间是什么关系、哪些来源更权威。Karpathy 的 LLM Wiki 把这个痛点说透了——“知识被编译一次,然后保持更新,而不是在每个查询上重新推导”。
Pinecone Nexus 把它产品化:Context Compiler 把原始数据加工成持久的知识工件,配一个带字段级引用和确定性冲突消解的检索器,再加一门声明式查询语言 KnowQL。它给自己的定位很明确——知识引擎,不是检索系统。
RAGFlow 的做法更工程化,编译产物是六种形态,共用一套血缘:
| 形态 | 服务什么提问 | 关键设计 |
|---|---|---|
| 树状导航 + 证据链叶节点 | 知道主题,不知读哪篇 | 证据链挂在叶节点上,命中即省 Token |
| 图状关联探索 | 关系型问题(谁和谁相连) | 实体与边由用户定义,非 GraphRAG 式碎片图 |
| 时间线 | “上个月改了什么” | 持续更新文档集的时间维索引 |
| LLM Wiki | 需要综述式答案 | 可选合成层,不是替代品 |
| 本体(TBox→ABox) | 需要语义骨架约束召回 | 编译期的先验知识,不取代 Search/Grep |
| Memory 模板 | 回忆历史会话 | 按 session 聚合,与文档证据同构 |
一个反直觉的工程发现值得单独说:把文档组织成树状结构,本身并不会给 Agentic Search 带来增益。在设计良好的 Harness 里,传统章节树甚至可能是负资产——Agent 依然主要靠 Search 和 Grep。真正产生价值的是挂在叶节点上的证据链:Agent 沿树导航到叶节点后,拿到的不是整段原文,而是 Claim 加逐字 Evidence。
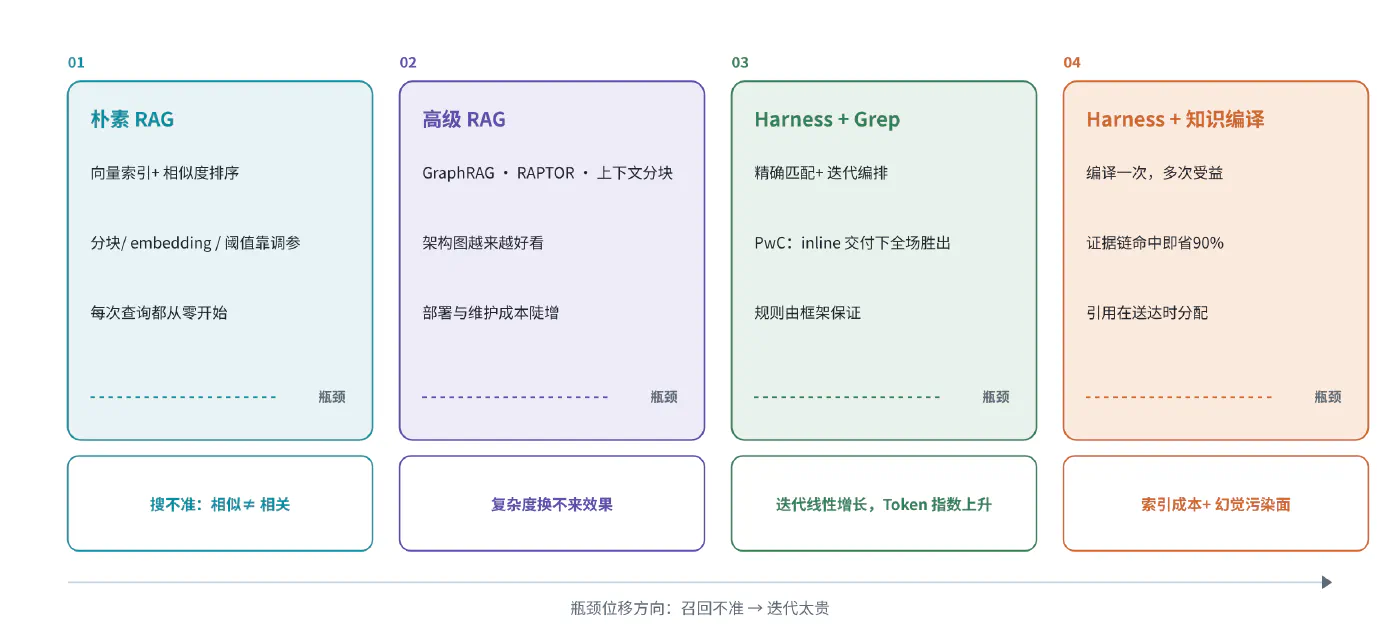
4.4 编排层:Harness 是引擎,编译是供给#
把两部分对齐,分工就清楚了:Search Harness 负责找到,知识编译负责省着用。
RAGFlow 1.0 的 Harness 做了一次减法——去掉按延迟、新鲜度、查询类型分流的多个路由器,只留一条循环,但把"谁来决定"重新划分。它给这条循环立了几条纪律,每条都对应一个具体的失效模式:
- 证据先行:在模型思考怎么搜之前,框架先做一次跨全库的证据召回,取回编译好的原子命题。
- 二选一:证据够(数量够、来源够分散),一次模型调用直接成文,整轮不读原文;不够,整块丢弃——不写进系统提示(会被循环里每次调用重复计费),也不分配引用编号(模型没见过它)。默认做法是"检索到什么先塞进上下文",这里反其道而行。
- 引用是机械的:证据在送达的那一刻获得编号,同一片段在整个会话里始终同一个号。模型不可能引用它没读过的内容——编号是服务时分配的,不是事后用相似度反推的。
- 证据闸门:它不做 rerank,回答一个更靠前的问题——这批证据,现在有必要发给大模型吗?它的价值在决定"不发"。
这套东西立住的地方是三件事:决定权分层、证据最小充分集、引用与成本的机械性。
4.5 另一条腿:把状态留在自己手里#
上面的四层解决"知识从哪来",Personal Database 那一支解决"状态存哪"。
它的论证是主权问题:如果工作习惯、日常流程、CRM 全锁在某一个 Agent 里,那么更聪明的 Agent 出现时你换不了;把数据抽出来放进独立的个人库,上层 Agent 和模型就可以自由插拔。
负载特征决定了架构:数量极大、单体极小、生命周期要么极短(原型)要么极长(一辈子)。这两种极端都不适合"一台虚拟机跑一个 Postgres"。
五、取舍与代价#
| 决策 | 备选 | 理由 | 代价 |
|---|---|---|---|
| 用 SQLite 承接轻负载 | Postgres 实例 | 供给成本降一到两个数量级 | 跨库事务、生态兼容、运维模型都要重建 |
| 知识编译 | 每次查询现算 | Token 降幅是数量级的 | 索引期成本 + 模板维护 + 幻觉污染面扩大 |
| 证据链绑定逐字引用 | 纯摘要 | 可审计、可追溯、命中省钱 | 抽取要做对,错了就是带着引用的错 |
| MCP 白名单 | 自由 SQL | 安全边界清晰、可审计 | Agent 的表达力被限制,复杂查询要预先建模 |
| 零拷贝分支做沙箱 | 独立测试库 | 分支秒级、数据同构 | 存储层改造,且分支本身就是新的成本项 |
有一条对照实验必须摆出来,因为它让"编译派"的说法打了折:arXiv:2605.18490 的预注册对比显示,仅用字符串匹配实现的 Agentic RAG,质量已经接近 LLM 编译的 Wiki。编译的收益在"更省"和"更可追溯"。
对"编译派"的批评也成立:LLM 写 Wiki 时每个编辑决策都是幻觉入口,一旦写进去,它就不再被标记为幻觉,而是被标记为一行笔记。RAGFlow 用"Claim 必须绑定原文连续子串作为 Evidence"来对冲,这是工程回应,不是理论解决。
六、现在到哪一步#
诚实的判断:两条腿都还在早期,而且都靠厂商自报的数字支撑。
Supabase 的近 5000 万个库里,绝大多数是免费原型库——“70% 新增来自 Agent"说的是活动量,不是收入。AWS 那条"Day 1 锁定"的规律成立的前提,是这些库里有一部分真的长大,转化率目前没有公开数据。
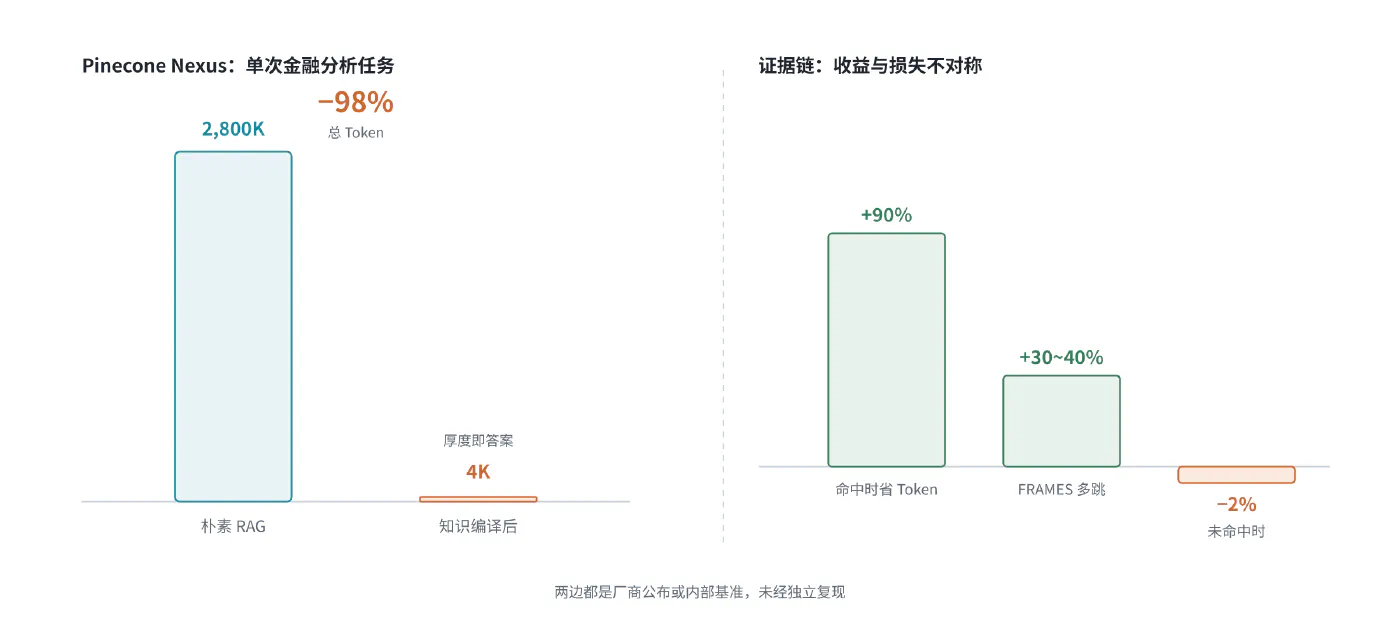
知识编译这一侧的账本同样要打折。Pinecone 的内部基准说一个 280 万 Token 的金融分析任务降到 4000 Token,降幅 98%;RAGFlow 说证据链命中时单问题省 90% 以上、未命中只损失约 2%,FRAMES 多跳基准上平均省 30–40%。这些数字未经独立复现,但方向与 PwC 的实验结论一致。
真正已经落地、可以当既有事实用的只有三件:MCP 成为事实标准;分支/沙箱成为 Agent 负载的默认姿势;报错信息被当作产品界面重写。
七、数据(分清来源)#
| 指标 | 值 | 来源 |
|---|---|---|
| Supabase 注册用户 | 300 万 → 1300 万(一年) | 官网公布(YC 播客) |
| Supabase 托管数据库 | 800 万 → 近 5000 万 | 官网公布 |
| 周新建数据库 | >100 万 | 官网公布 |
| 新增活动中 Agent 占比 | 约 70% | 官网公布 |
| Supabase 融资 | 5 亿美元 F 轮后 4 个月再获 1.5 亿美元(GIC 领投) | 新闻稿 |
| 已有 Agent 在生产运行的组织 | 72.1%(n=903) | IDC FERS,2026-02 |
| 向量数据库市场 | 26.5 亿美元(2025)→ 89.5 亿美元(2030),CAGR 27.5% | MarketsandMarkets |
| Agentic 统一决策引擎占 DBMS 市场 | 60%(2031) | Gartner 预测 |
| Nexus 金融分析任务 Token | 280 万 → 4000(-98%) | 厂商内部基准,未独立复现 |
| 证据链命中时省 Token | >90%;未命中损失约 2% | 厂商公布,未独立复现 |
| FRAMES 多跳基准平均省 Token | 30–40% | 厂商公布,未独立复现 |
八、读者能自己验证什么#
不需要换数据库,一个下午能做完:
- 从你的 RAG 管线里挑 20 个真实问题,构建一个只带 grep/BM25 + 简单循环的 Agent Harness 作为基线,与现有向量检索管线同题对比。PwC 的结论如果在你的语料上不成立,你的数据分布就是那个例外,值得记下来。
- 量三个数:平均迭代轮数、每轮进入上下文的 token、最终答案的引用能否回到原文确切片段。第二个数决定成本,第三个数决定能不能过审计。
- 如果你的语料是长文档或政策集,再试一次"证据链作为 chunk 前过滤”:命中就直接答,不读原文。用省下的 token 除以索引成本,看多久回本。
这三步做完,你会知道自己需不需要一个"Agent 数据库",还是只需要一个好的 Harness。
九、路线图与开放问题#
两个我答不出来的问题,留在这里:
第一,付费结构成立吗? 海量小库的供给成本可以压到接近零,但收入从哪来——是长尾里的少数长大后付费,还是按 Agent 调用量计费?前者赌转化率,后者赌用量,两条路的单位经济学完全不同。
第二,编译产物能搬走吗? 证据链、本体、导航树、Memory 模板,各家格式互不兼容。Personal Database 让用户免于被 Agent 厂商锁定,却可能转而被数据库厂商锁定。这是这个品类目前最大的未解问题,也是企业采购时唯一该写进合同的事。