把聊天框当 Agent OS,三十人的公司几周就碎:拆 Ankole 的五处断裂点
一句话主张——单机 harness 加聊天框不是 Agent OS——听起来像口号。把它拆开,是五处具体的断裂点:谁在说话、它记得什么、崩了之后活儿还在不在、在哪台机器上动手、回复到底送没送到。这篇按 Apache-2.0 的仓库逐层核了一遍,也把价格摆出来。
一句话 把单机 harness 套上聊天框,只搬走了界面那一层;真正的差别在五件事——谁在说话、它记得什么、崩了之后活儿还在不在、它在哪台机器上动手、回复到底送没送到。
先说清楚这篇的材料边界:那篇文章的正文在 X 上要登录才能读,我拿到的只有它自己给出的主张和开头一段。所以下面不复述文章结构,而是把这个主张当成一道题来做——技术细节核对的是 Apache-2.0 的仓库(浅克隆,5,890 个文件)和它随仓库发的文档,包括一份 170 行的《取舍与已知限制》。数字分两类:官方文档写的,和我自己在克隆里数出来的,各自标注。
一、主张先摆出来#
原文的说法是:把聊天界面架在一个单用户 harness 上,或者往群里扔一个 bot,都不叫 Agent OS;把它放进三十人的公司,横跨运营、财务、法务,几周就会碎。
这句话方向是对的。把它拆成五处,每一处都有具体的失效方式。
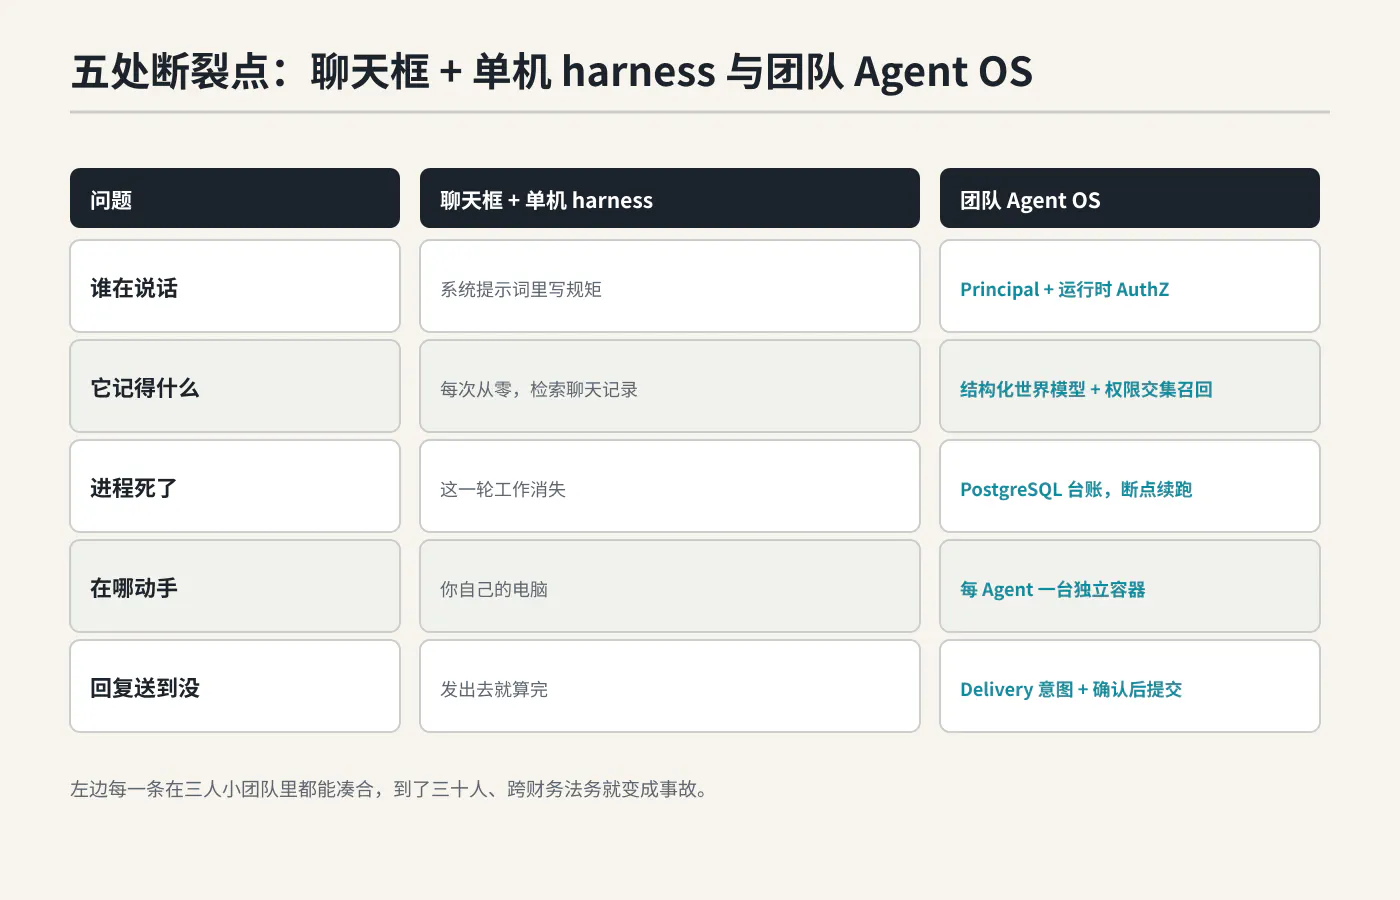
| 问题 | 聊天框 + 单机 harness | 团队 Agent OS 的答案 |
|---|---|---|
| 谁在说话 | 规矩写在系统提示词里 | Principal + 运行时 AuthZ |
| 它记得什么 | 每次从零,检索聊天记录 | 结构化世界模型,按权限交集召回 |
| 进程死了 | 这一轮工作消失 | PostgreSQL 台账,从已提交处续跑 |
| 在哪动手 | 你自己的电脑 | 每 Agent 一台独立容器 |
| 回复送到没 | 发出去就算完 | Delivery 意图,平台确认后再提交 |
二、谁在说话:权限不是提示词#
Ankole 把所有人、Agent、内部服务统一成 (tenant_id, uid) 的 Principal,权限在控制面运行时求值:主体、权限组、Drive 的 ACL 锚点、动作,加上 CEL 条件,一起算。文档里有一句话值得抄下来——访问控制「永远不由提示词约定来执行」。
这条区分落到两种 Agent 上,差别很具体。Personal Assistant 与人一对一绑定,借所有者的共享权限,但保留自己的运行时身份,审计线上看得见是谁做的手脚。AI Colleague 用自己的授权,当它要做超出自身写权限的事(改一个受保护的知识对象),必须发一张 propose_action_card 等人批。群聊里 Agent 的广播回复不会唤醒其他 Agent,要协作就走 send_to_agent 开一条隔离的 peer 会话。
三、它记得什么:不是向量库,是带边的关系网#
公司知识那层(他们叫 Brain)不是把聊天记录切片塞进向量库。它维护 :knowledge 页面,加上原子事实、观点(Takes)、时间线,和带类型的 brain_links 边;检索是 BM25 与向量混合,召回时取请求者与 Agent 可达权限的交集,撤销某个源页面的访问权,由它派生的说法在下一次读时立刻被过滤掉。新证据与旧说法冲突时,离线的 Dreaming 记录这个矛盾等人看,而不是悄悄覆盖。
这套东西的维护成本,从仓库能看出一些:
| 指标 | 值 | 来源 |
|---|---|---|
| 仓库文件数 | 5,890 | 克隆里数的 |
| Elixir 代码 | 651,660 行 | 克隆里数的 |
| TypeScript / TSX | 339,391 行 | 克隆里数的 |
| Rust | 49,048 行 | 克隆里数的 |
| Lean(形式化验证) | 63,587 字节 | GitHub languages API |
| 测试文件 | 977 个 | 克隆里数的 |
| 插件 | 15 个(10 个渠道适配器、3 个企业连接器、2 个 provider 包) | plugins/ 目录 |
| 文档 | 42 篇页面 + 27 篇设计文档 | docs/ 目录 |
| 许可证 / star / fork | Apache-2.0 / 174 / 27 | GitHub API,写这篇时 |
四、它死了之后:数据库是唯一的事实来源#
一条消息进来,先变成 Signal:记下来源、来源事件 ID、目标、归属和授权,按 (目标, 来源, ID) 去重,然后才唤醒 Session 或排一个自动化任务。Session 每次只跑一个 Run,Admission 在开跑时再查一遍租户、Agent 状态、人的访问权、授权和 token 配额。
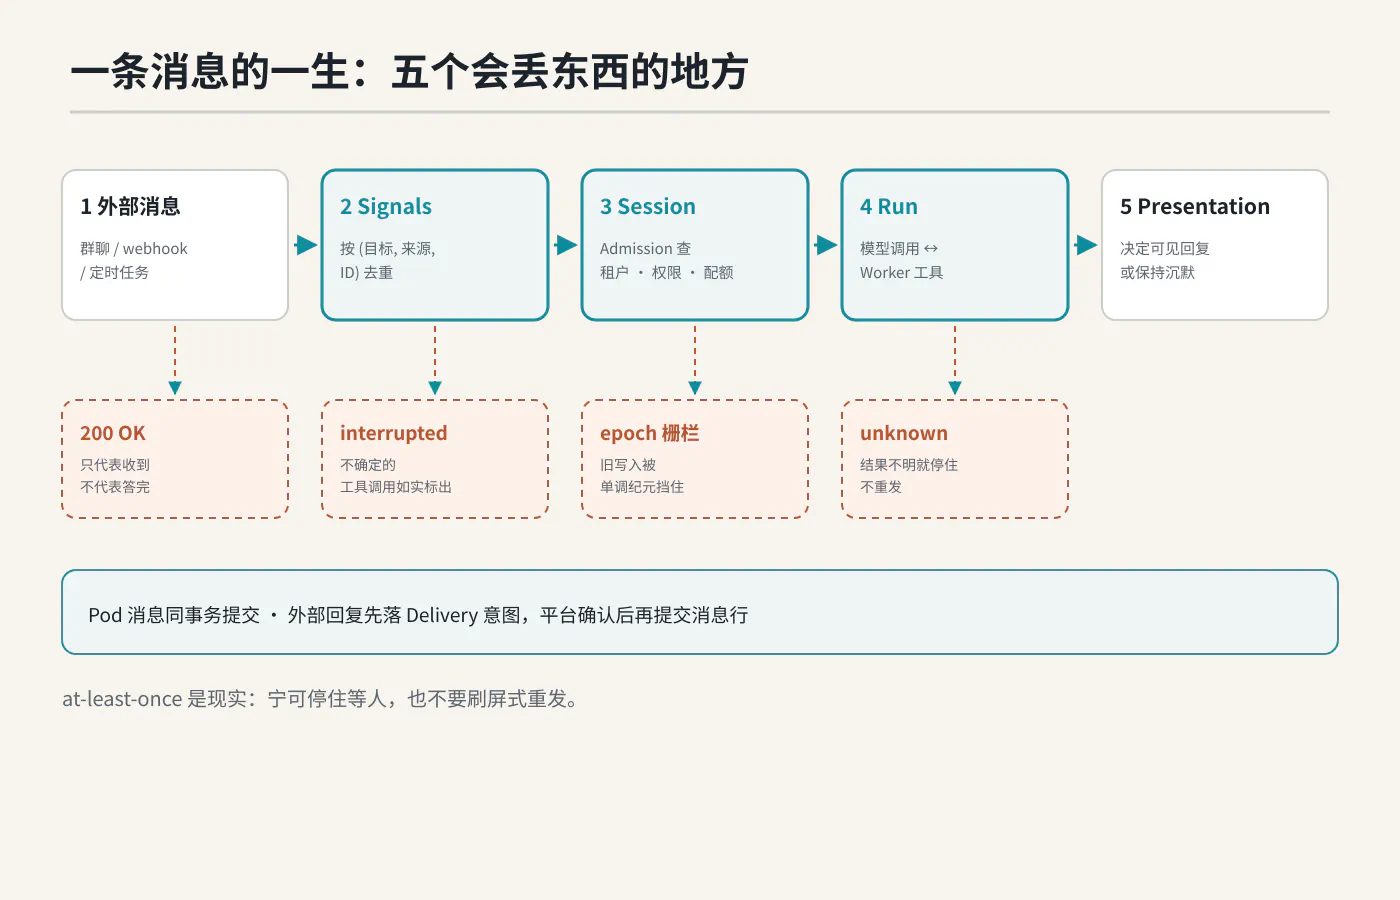
恢复语义写得很直白,也很少见:驱动进程用单调递增的 epoch 挡住旧写入;被打断的模型调用可以重跑,已提交的工具结果直接复用,状态不明的 Worker 工具调用标成 interrupted 让人看见。RuntimeFabric(每个 Worker 一条 Phoenix Channel)只做传输,不做队列——断线之后一切以 PostgreSQL 里的已提交状态为准。
这也解释了为什么控制面是 Elixir:Actor 模型给每个 Session 一个地址、一个信箱、生命周期和恢复检查点,OTP 监督树把单个 Agent、单个连接器流、单个任务放进独立的故障域。
五、它在哪动手:每 Agent 一台电脑#
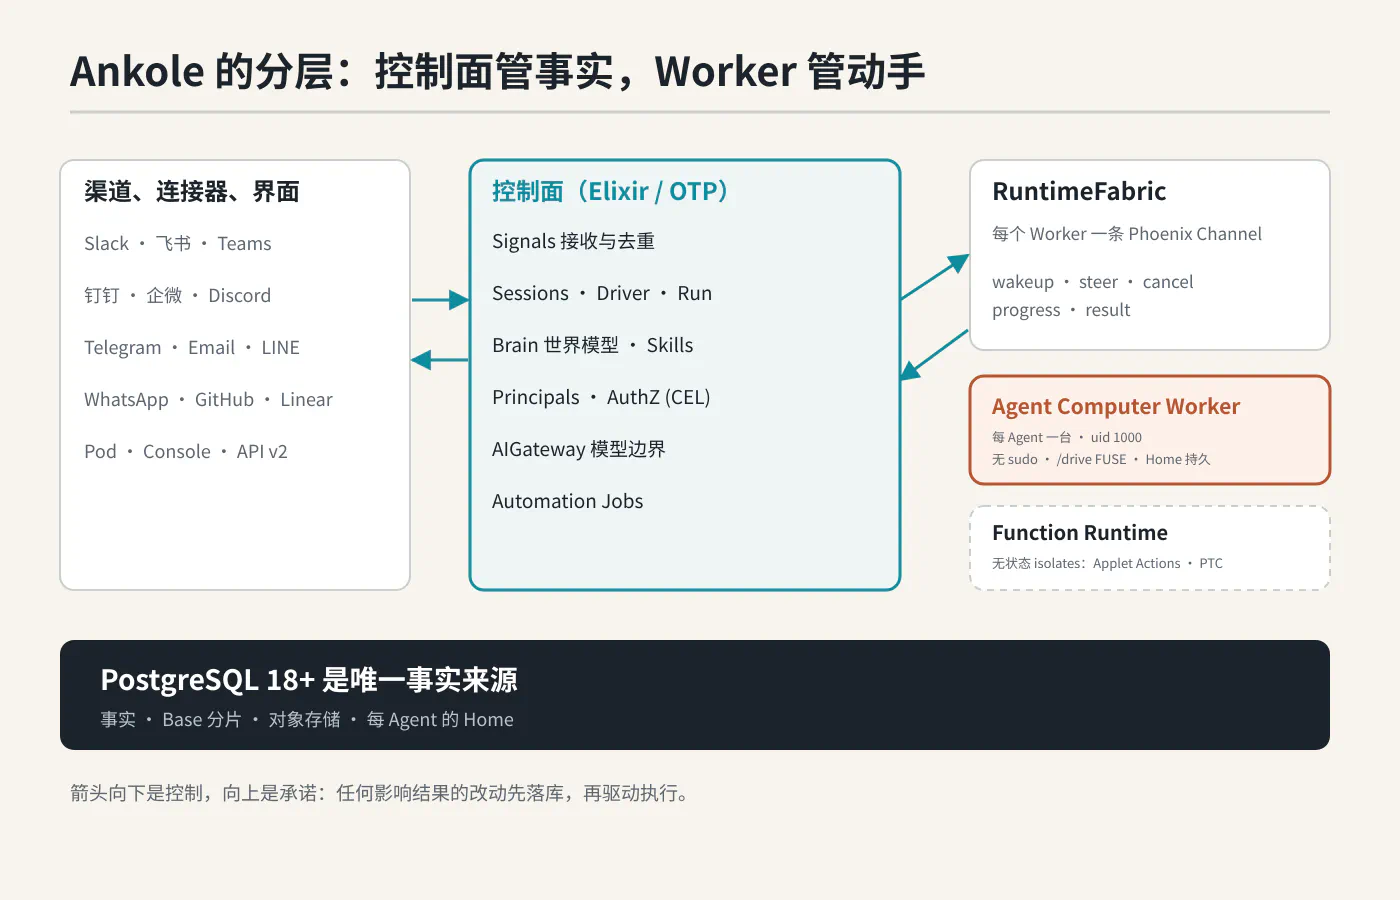
每个 Agent 一台 Agent Computer Worker,不共享容器、不共享持久卷、不共享缓存盘、不共享凭据。容器里 shell、Codex、无头浏览器都以 uid 1000 跑,没有 sudo,也不设内层沙箱。文档把这件事说得毫不含糊:容器边界就是唯一的安全边界,系统不打算防御 Agent 自己——因为那台机器的凭据本来就只代表这一个 Agent。
目录分两种命运:/workspace 持久(Agent 的家,跨实例替换保留),/var/cache/ankole 可重建(换实例就丢,重建即可)。/drive 通过 FUSE 挂载 Unified Drive 的四个视图,Brain、Skills、AGENTS.md 只读。实例起不来(超过 agent_workers.ready_timeout_seconds),控制面直接换一个新的容器和干净的缓存盘。
平台不止一种:核心内置四种 Worker provider(Docker、Kubernetes、Cloudflare、Lambda),文档矩阵里还有 Vercel 与阿里云函数计算。同一个机制在 Kubernetes 上可以给 Worker 挂 gVisor 的 RuntimeClass。
六、回复送没送到:at-least-once 是现实#
外部平台的投递语义,文档承认得比大多数产品都诚实:webhook 返回 200 只代表「收到了这个事件」,不代表 Agent 答完了;流式预览是 best-effort,进程中途挂掉,外部聊天里可能残留半句预览;结果不明的发送标成 unknown 并停止自动重试,等人从 Console 手工重排一次,而不是无限重发刷屏。
还有两条平台级的硬约束:WhatsApp 的 24 小时客服窗口,过期就直接判失败、不调用 API(除非用付费模板消息,那在适配器范围之外);用户中途发 /steer 插话,一次 Turn 会跨两条 Signal,事后追一条回复要看 Delivery 行的 ai_message_id。
七、价格:这套设计要付什么#
| 决策 | 换来的东西 | 代价 |
|---|---|---|
| 控制面挂 Docker socket / K8s Role 起 Worker | 每 Agent 一台真正隔离的电脑 | 控制面等于 root 级基础设施,必须按最高等级保护 |
| PostgreSQL 18+ 做唯一台账,Base 另走物理分片 | 结果可恢复、可审计 | 备份要连对象存储和每个 Agent 的 Home 一起做,且分片恢复目标必须不早于控制面 |
| 一台可换、一台必须留住 | 换实例不丢工作 | 持久层质量取决于 provider:Docker 本地卷不抗盘损,Cloudflare 计划外 kill 会丢最后一次快照后的写,阿里云 OSS 不是完整 POSIX |
| 三套运行时(Elixir 控制面、Bun Worker、Rust 内核) | 各自做最擅长的部分 | 运维面变宽,团队要会三种语言 |
| 只做自托管、Apache-2.0 | 数据和凭据不出门 | 起步要 DNS、四组随机密钥、SMTP 或 SSO,还得有人管升级 |
再补一条不属于上表的:这是个很新的项目(2026 年 4 月建仓),0.x 阶段的 API 还会动。
八、读者能自己验证什么#
想判断一个「Agent OS」是不是真的,四件事可以自己跑:
- 装一遍 Docker Compose 版,看它有没有一个一次性的激活码流程(
SETUP ACTIVATION CODE),而不是默认口令直接进后台。 - 把权限从提示词里删掉,看越权操作是不是还被拦住——拦不住的那个,权限还活在提示词里。
- 跑到一半 kill 掉 Worker,看任务是不是从
/workspace接着跑,而不是从头再来一遍。 - 断网时发一条群消息,看那条回复是标成「不确定、等人处理」,还是默默消失或者重发三遍。
九、开放问题#
- 控制面既然等于 root 级基础设施,一个三十人的公司要把它托管在哪儿、由谁维护,才既不违反这条信任假设,又不至于每周出一次事故?
- Brain 遇到证据冲突时选择记下来等人裁决。这个「等人」的部分,在知识量涨到几千页之后还撑得住吗,还是要变成一套自动的裁决政策?
参考#
- 原文:AgentBull 的帖子与文章 (正文需登录)
- 仓库:AgentBull/ankole ,Apache-2.0
- 文档:架构 、Agent Computer Worker
- 取舍与已知限制:docs/TradeoffsAndKnownLimits.md