自动本体工程:英伟达 Auto-Ontology 的源码级拆解
Auto-Ontology 用四个阶段从元数据与查询历史编译出一张业务本体,再以 9 个只读 MCP 工具交给 agent。读完 1.1.0 的源码后,我认为它把「第一个月」自动化了,但认证是徽章、不是闸门。
一句话:Auto-Ontology 把本体工程里最贵的那一个月自动化了——它读你的元数据和查询历史,编译出一张业务本体,再用 9 个只读工具交给 agent。但它交出来的是草稿:认证在这套代码里是展示用的徽章,不是查询路径上的闸门。
中文配音版(男声),2 分 04 秒。中英两版内容一致,另有英文配音版。
NVIDIA 在 2026 年 10 月 21 日的 GTC Berlin 上把它作为 Agent Knowledge Foundation 的一部分宣布,11 月 1 日以 Apache-2.0 开源。我读的是 caced11 这个提交(11 月 4 日克隆)的完整后端源码,下面是能逐条对回代码的判断。
一、一次不会报错的错#
一个 agent 能写出跑得通的 SQL,这件事又容易又危险:一条跑通、返回一个「看似合理却错误」数字的查询,不会报错。
最典型的现场是这张表。
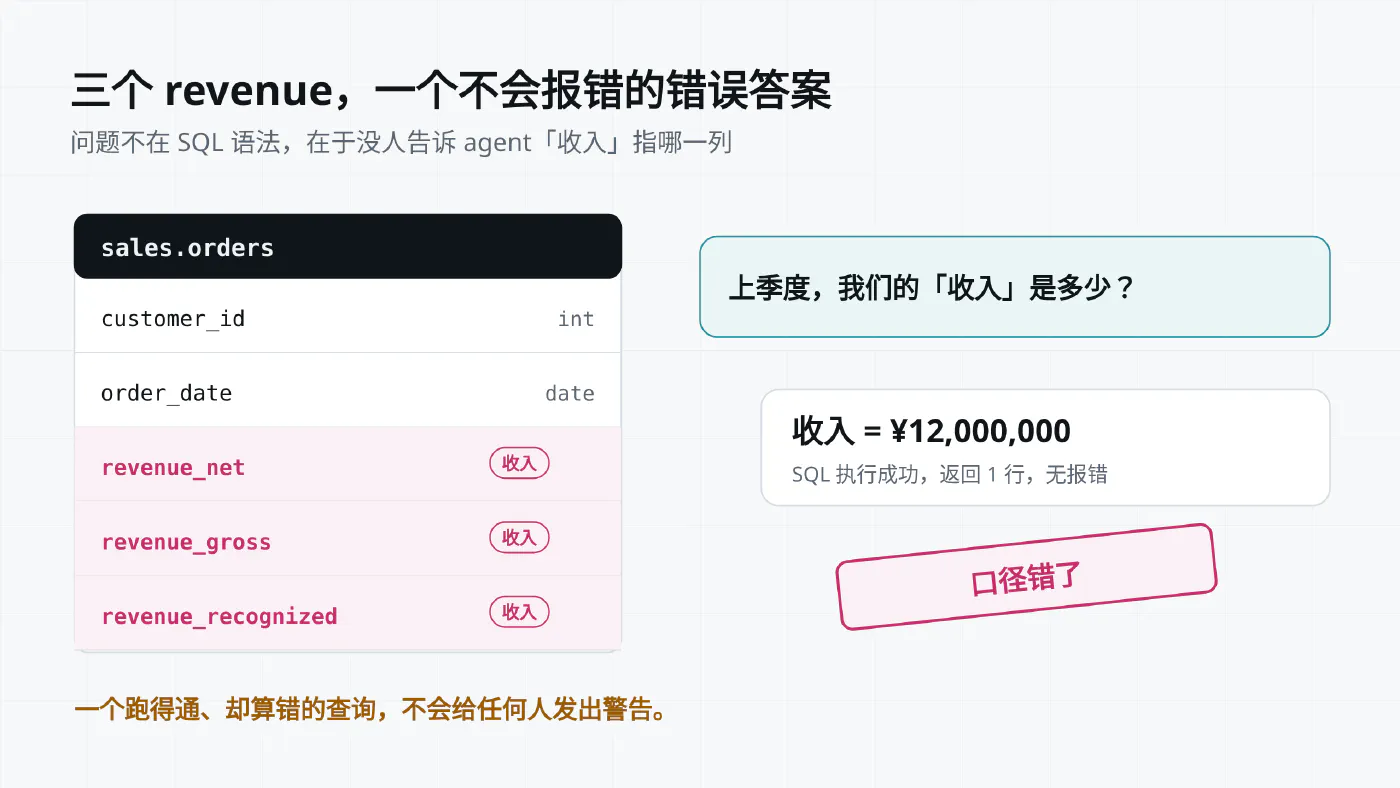
财务有三个列都能叫 revenue;销售说的 bookings 和财务说的 revenue 是两回事;一个一对多 join 会让总数静默翻倍,而 SQL 完全合法。传统 text-to-SQL 研究默认难题是「生成语法正确的 SQL」,于是堆模型能力。Auto-Ontology 的判断相反:语法正确不等于语义正确,真正缺的是那层告诉 agent「数据在哪、什么意思、能不能用、怎么用、从哪来、什么相似」的上下文。
这层东西过去只活在数据工程师和业务人员脑子里。它的工作量集中在第一次交付——梳理来源表、定义对象关联、审核指标口径。这也是为什么大部分语义层项目死在第一周:平台装好了,然后没人能说清六个 revenue 定义里哪个是真的。
二、它站在哪条脉络上#
「用本体给数据加一层语义,再把查询翻译回去」不是新想法,但谁来写这层本体变过两次。
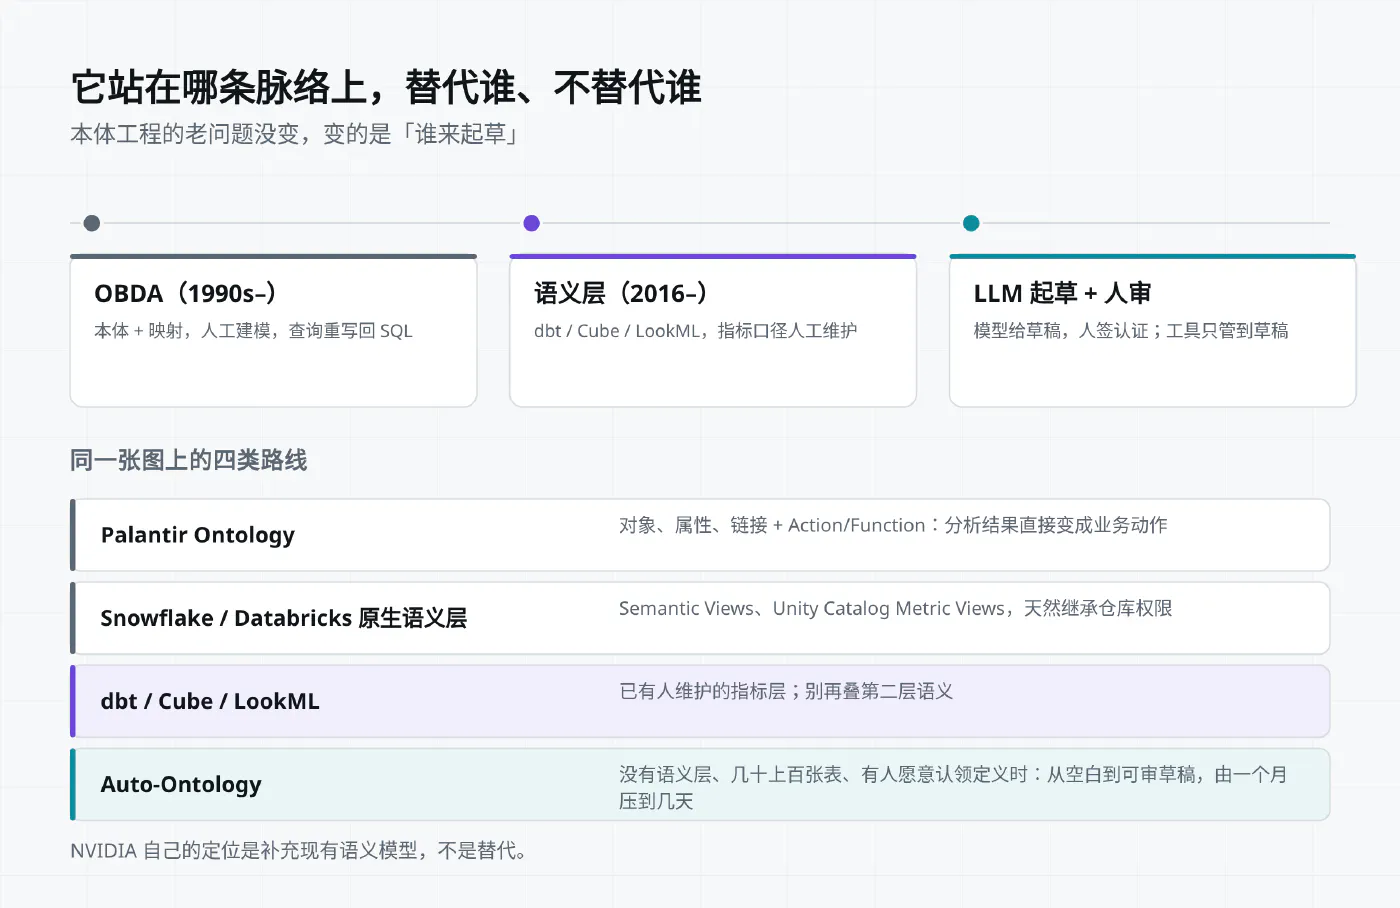
| 路线 | 本体/口径由谁写 | 后果 |
|---|---|---|
| OBDA(本体驱动数据访问) | 知识工程师人工建模,一条条映射 | 表达力强、推理可证;成本让它在企业里长期停在 PoC |
| 语义层(dbt / Cube / LookML) | 分析工程师写 YAML,人审 | 口径可信;从空白页到第一版仍要几周到几个月 |
| LLM 起草 + 人审 | 模型给草稿,人签认证 | 第一天就有可审的东西;草稿与权威的界线必须由使用方自己划 |
学术上这两条线都有三十年积累。OBDA 的三层结构(数据源 / 映射 / 本体)与 Auto-Ontology 的 catalog / semantic FK / terms 几乎同构,区别只在于本体不再是人工建的。近三年这条线被 LLM 重写了一遍:《Towards Agentic Schema Refinement》(arXiv 2412.07786)、《Knowledge Base Construction for Knowledge-Augmented Text-to-SQL》(ACL 2025 Findings)、《A Multi-Agent System for Semantic Mapping of Relational Data to Knowledge Graphs》(arXiv 2511.06455)走的是同一个方向——把「给模型更对的上下文」当成主问题,而不是「让模型更会写 SQL」。
查询历史挖掘则是工业界正在形成的共识。Snowflake 的工程博客写过用查询历史建语义模型,开源侧有把历史 SQL 聚类成 dbt YAML 的项目。它的立论很硬:查询历史是企业到底怎么度量自己的唯一行为证据,比文档真实。Auto-Ontology 的第四步就踩在这条线上。
三、设计:四个要件,两条原则#
它不是「又一个 text-to-SQL 引擎」。要成立,这四个要件缺一不可。
- 本体必须是可检索的图,不是塞进 prompt 的一段 schema。否则 token 随表数线性膨胀,且无法表达关系。
- 术语必须落到列与 SQL 表达式上。只说「收入是个业务概念」没用;要说清它映射到哪几列、用什么表达式算。
- 关系必须比列名更强。
customer_id在两张表里都出现,不构成能 join 的证据。 - 答不了要能说答不了。这是唯一能拦住「自信地答错」的机制。
两条工程原则决定了它的形状:
- 工具面是设计出来的,不是从 OpenAPI 自动生成的。默认暴露越多,agent 选错工具的概率越高。
- 认证由人签,签完要能被检查。这条原则它只做到了一半,第六节展开。
四、实现:一层一层拆#
4.1 部署形状#
它不是库,是跑在数据库旁边的完整栈。读 README 的组件表比读代码更快理解它的边界。
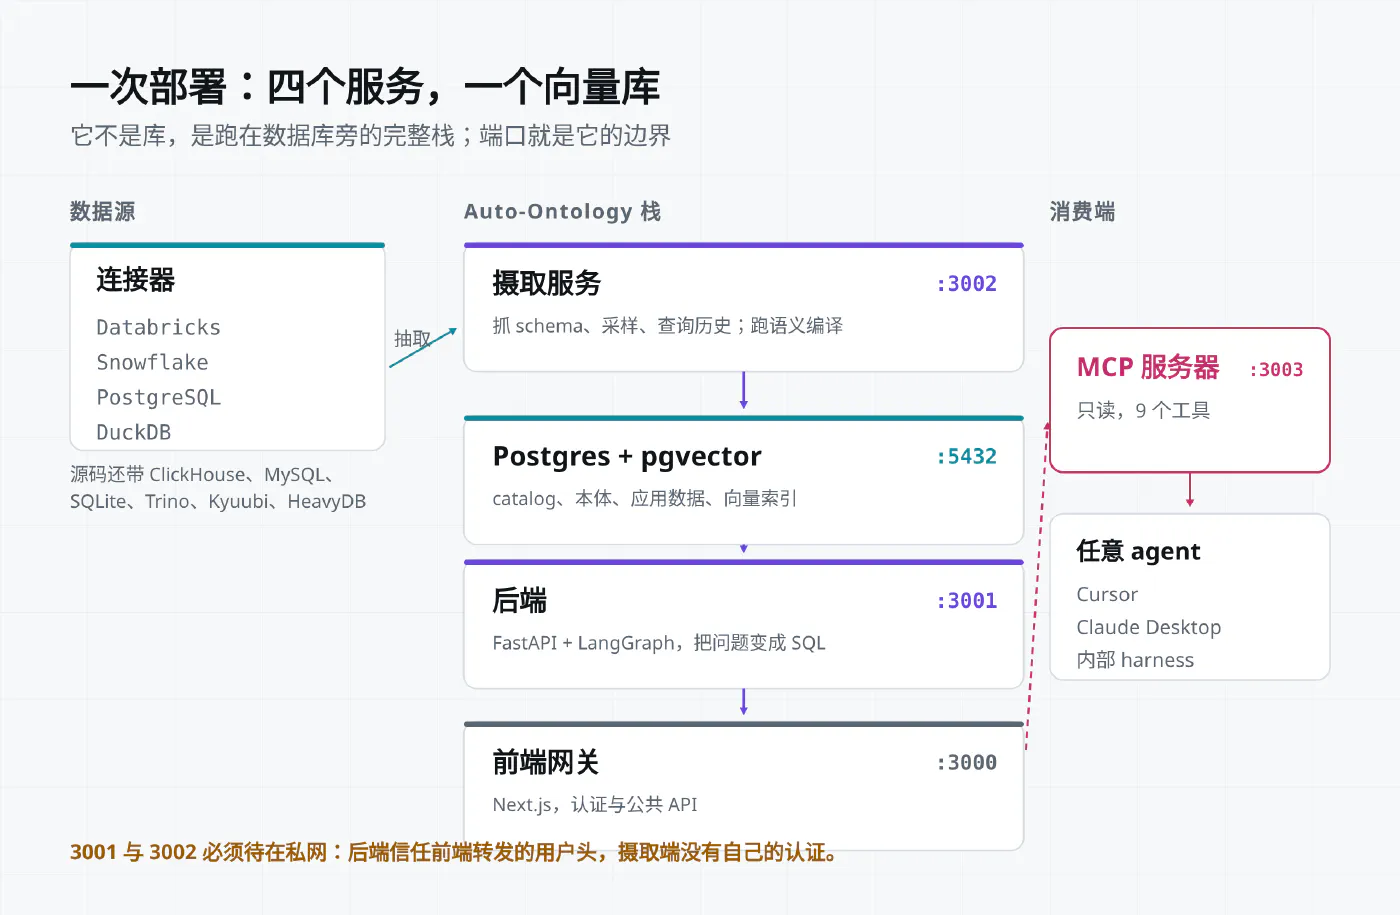
默认模型走 NVIDIA NIM(推理 nvidia/nemotron-3-nano-30b-a3b,加 Nemotron 的 embedding 与 rerank),但每个模型角色都能指向任意 OpenAI 兼容端点。数据源官方列出 Databricks、Postgres、Snowflake、DuckDB;源码里还带着 ClickHouse、MySQL、SQLite、Trino、Kyuubi、HeavyDB 的连接器。
有一个安全事实必须在部署前读:Next.js 网关把用户解析成 x-auto-ontology-user-id 转发给 FastAPI,后端不独立校验;摄取服务的 ingest / delete / reset / compile 端点没有自己的认证。README 写得很直白——3001 与 3002 不得公网暴露。在 K8s 里这意味着一条 NetworkPolicy,而不是一句提醒。
4.2 语义编译的四个阶段#
这是整个项目的核心,入口在 auto_ontology/semantic/compile.py,四段严格串行:
# auto_ontology/semantic/compile.py
count      = compile_semantic_layer(...)          # ① 逐表 taxonomy
fk_count   = resolve_semantic_fks(...)            # ② 语义外键 / 桥表
attr_count = suggest_sql_attributes(...)          # ③ 从查询历史挖指标定义
bridge     = build_bridge_tables_sql_attributes(...)  # ④ 桥表
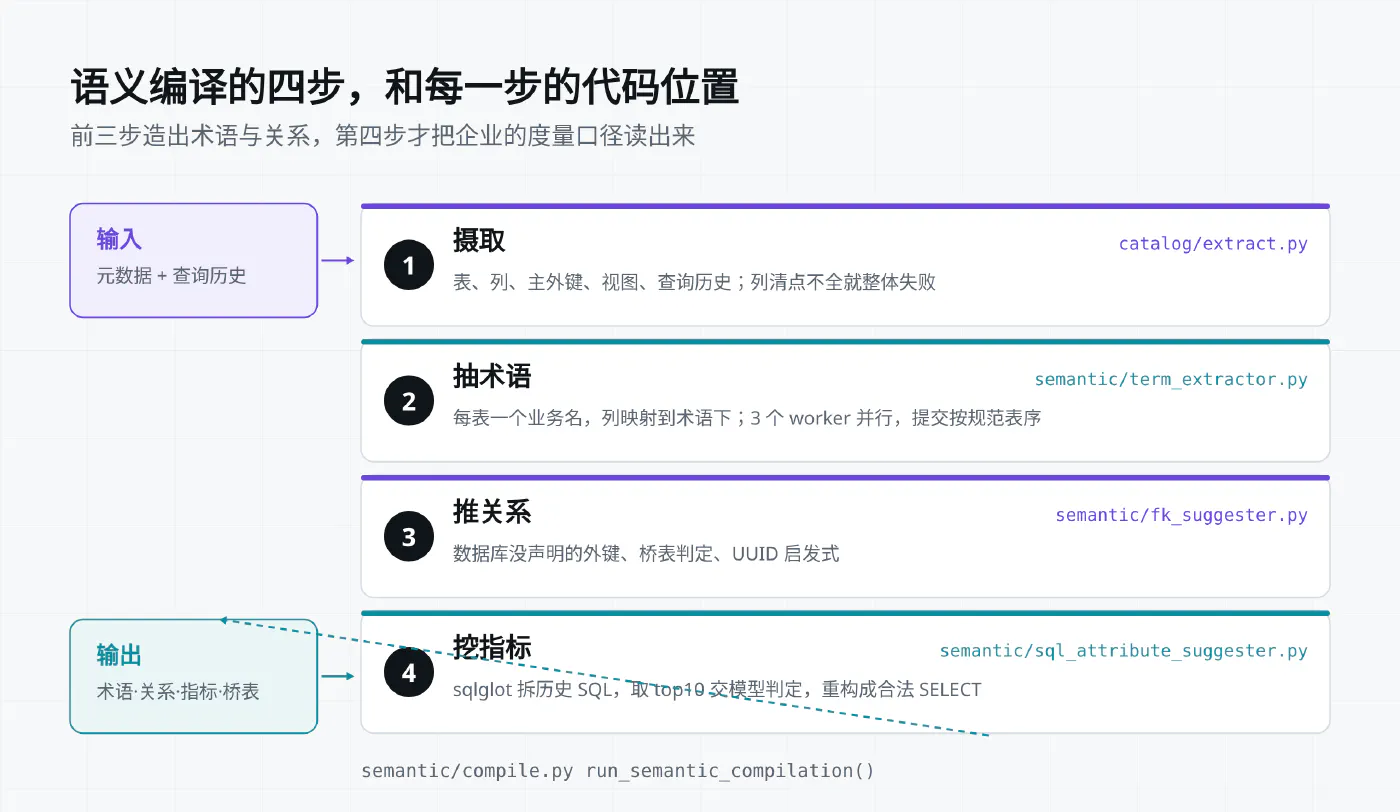
第一步摄取(catalog/extract.py)拉六类实体:tables、columns、views、pks、fks、queries。这里有个值得抄的工程细节——_validate_relation_column_coverage 是 fail-closed 的:只要某张表出现在 get_tables() 却在 get_columns() 里没有列,就整体报错。否则会出现最难查的一类故障:catalog 落库了、检索也返回了这张表、每条生成的查询都失败。
第二步抽术语(semantic/term_extractor.py + pipeline.py)。每张表一个业务名,每列映射到某个术语下并给一个用户友好的显示名。prompt 写得很克制:「强烈偏好一张表一个术语」,只有真 junction 表才允许多个。
工程细节比 prompt 更值得看。pipeline.py 用 3 个 worker 并行处理表,每张表内部又并发发 LLM 请求;compile.py 因此设了一个 SEMANTIC_LLM_MAX_INFLIGHT=6 的全局上限——「表级并行 × 表内并发」的速率是乘积,源码注释写着它曾把端点打到 HTTP 503。同时术语提交走一个 _OrderedCommitQueue,按「规范表序」放行:这样当两张表都想用一个无限定名时,谁拿到这个名字是确定性的。昂贵的 LLM 工作保持并行,写库变成顺序。
第三步推关系(semantic/fk_suggester.py)。数据库没声明的外键靠模型从列名(_id 后缀)、类型、描述、采样值(is_unique)推断,还包括桥表判定和一个 UUID 启发式。
第四步挖指标(semantic/sql_attribute_suggester.py)是整套里最聪明的一步:
- 对每个术语,取它关联表的历史 SQL;
- 用 sqlglot 解析,抽出表达式——WHERE / JOIN ON 谓词、聚合、CASE、UNION 分支,同时显式排除「纯 FK 相等」和裸列引用;
- 按使用频率打分,取 top 10 交给模型判定哪些值得变成命名的
SqlAttribute; - 把判定通过的表达式重构成合法
SELECT落库并嵌向量。
设计意图很清楚:让 agent 复用「活跃客户」「毛利率」这类已经有人算过的口径,而不是每次自己临时拼算术。但第三步的打分目前是空转的,第六节讲。
4.3 一条问题怎么变成 SQL#
问答侧是一个 LangGraph 状态机,在 retrieval/text_to_sql/text_to_sql_graph.py 里,20 多个节点、一张显式的边表。
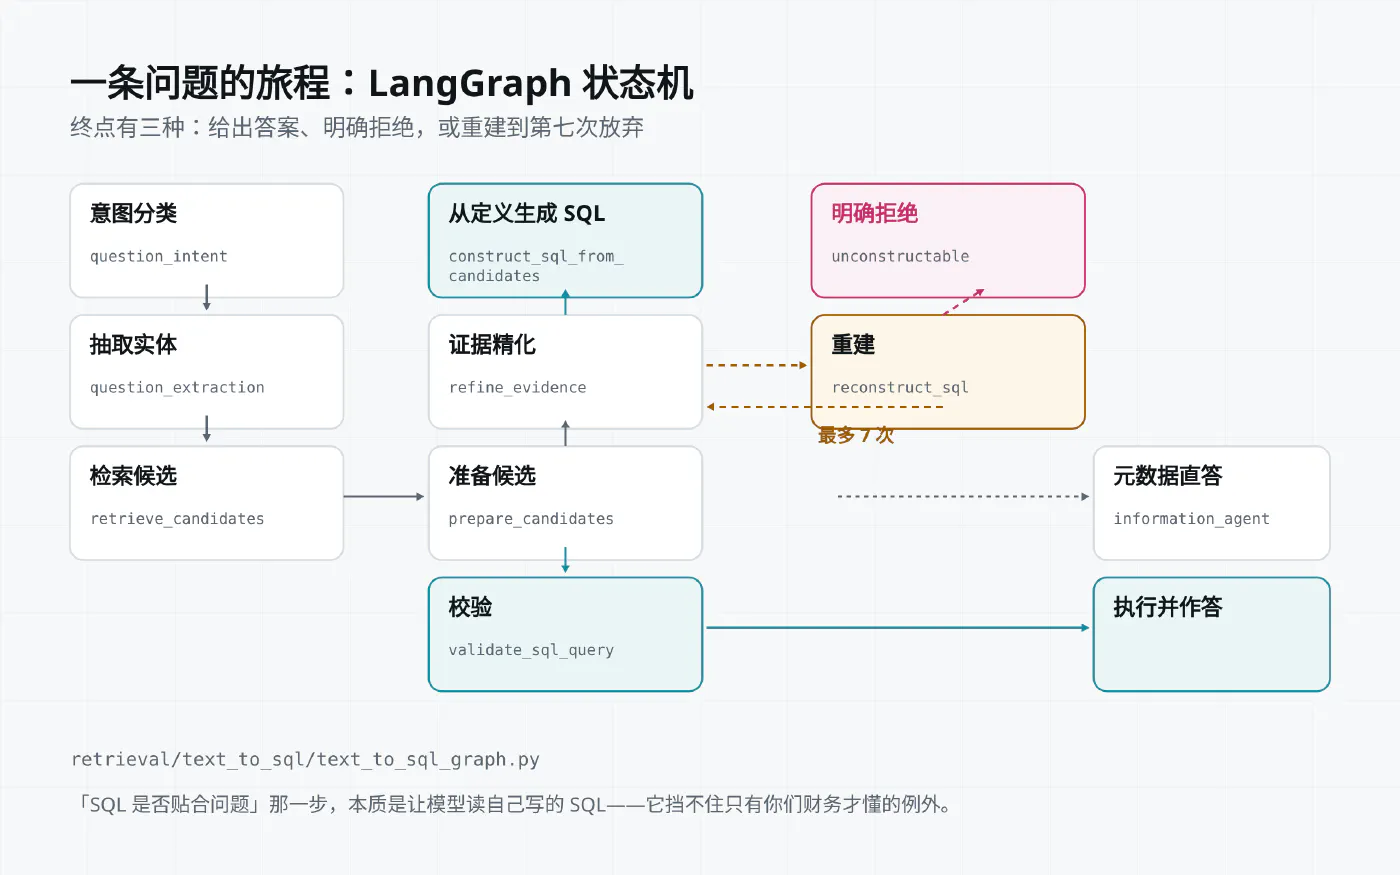
三个设计值得直接抄进任何自建系统:
- SQL 从「检索到的定义」构建,而不是从裸列构建。
agents/sql_from_semantic.py把primary_attribute、attribute_join_paths、sql_attributes(审核过的公式)、术语同义词、值锚点一起注入 prompt。 - join 在执行前对照本体已知关系检查。
db_probe/join_path_check.py是独立的探测节点,因为「列名都叫 customer_id」不能证明两张表能 join。 - 有一个明确的终态表示「这题从我所知的东西里答不了」,以解释收场,而不是硬猜。重建有硬上限
MAX_RECONSTRUCTION_ATTEMPTS = 7,超过就进unconstructable。
还有一处要诚实指出:所谓「SQL 是否贴合问题」的校验,本质是让模型读一遍自己生成的 SQL(agents/sql_parse_validation.py)。它能抓出自我比较、错误过滤这类错误,但它不知道你们财务要排除对子公司的销售。那是模型判 SQL,不是语义保证。
4.4 可回答性:一个确定性的 0–1 分#
retrieval/entity_coverage/agents/coverage.py 里没有模型判断,只有算数:
# auto_ontology/retrieval/entity_coverage/agents/coverage.py
def _compute_coverage(entities, col_attr_hits) -> float:
    if not entities:
        return 0.0
    return len(_covered_entities(entities, col_attr_hits)) / len(entities)
抽实体 → 向量检索候选 → 按距离过滤 → 覆盖度 = 被覆盖实体数 / 实体总数。于是 agent 能在花大钱跑 ask_question 之前先做一次廉价预检。README 里那个「广告支出 ROI」的例子就是靠它给出 coverage 0.5; no term covers "ad spend",然后反问澄清,而不是编一个数字。
4.5 工具面:87 个接口里挑 9 个#
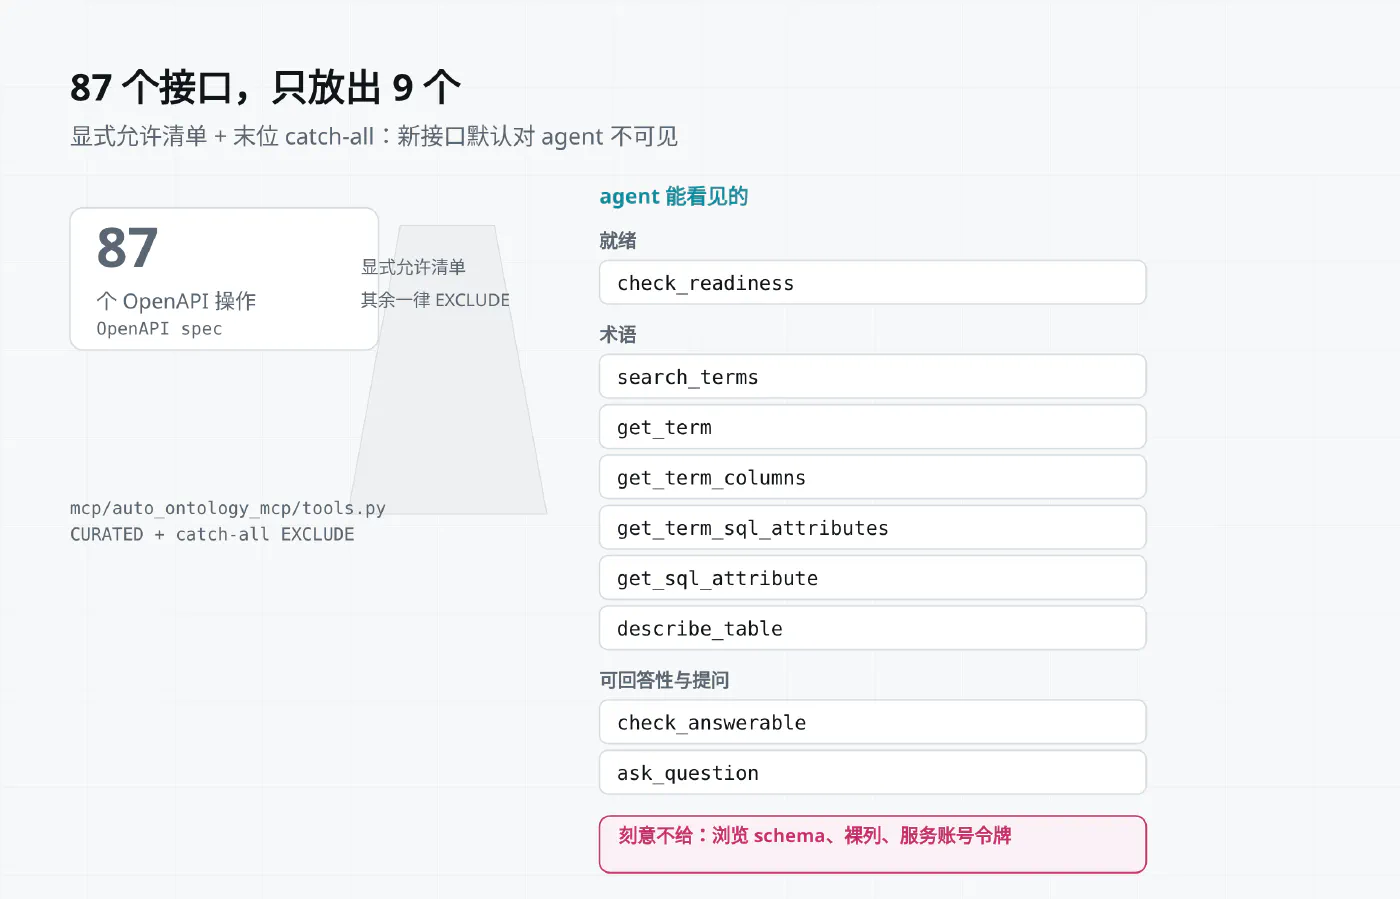
mcp/auto_ontology_mcp/tools.py 集中体现了设计哲学:后台 87 个 OpenAPI 操作,MCP 只放出 9 个,其余被一个 catch-all EXCLUDE 挡住。三个决定比工具本身更值钱:
- 故意没有浏览 schema / 裸列的工具。源码注释原话:列出 schema 或列的工具「invites an agent to bypass it and reason about raw tables instead」。
- 工具描述被重写成 prompt。生成的
operationId形如get_api_terms_term_id_,对模型毫无信息;每个工具的 description 都改成「什么时候该用、用调用者的词汇说」。 - 没有服务账号令牌。每个调用都以当前登录人的身份执行,viewer 得到 viewer 的答案。
五、取舍与代价#
| 决策 | 备选 | 理由 | 代价 |
|---|---|---|---|
| 四个服务 + Postgres 起步 | 一个进程 + SQLite | 编译、问答、网关的负载与权限边界不同 | 要跑要护的东西是五个,不是一 |
| 编译期就把语义落库(而非每次现算) | 运行时从 schema 现推 | 关系与指标只算一次,问答便宜 | 本体与源库会漂移,需要重编译策略 |
| 从查询历史挖指标 | 只信人工写的 dbt 模型 | 行为证据比文档真实 | 一条被错误口径刷了一年的看板,会是最「常用」的表达式 |
| 工具面 allow-list | 从 OpenAPI 全量生成 | 工具多了 agent 选错率上升 | 新接口要手动登记,否则 agent 永远看不见 |
| 认证是数据字段,不是运行时闸门 | 在查询路径上强制只读已认证定义 | 先把草稿跑通,再谈治理 | 见第六节;这是使用方必须自己补的一段 |
六、现在到哪一步:两处源码级落差#
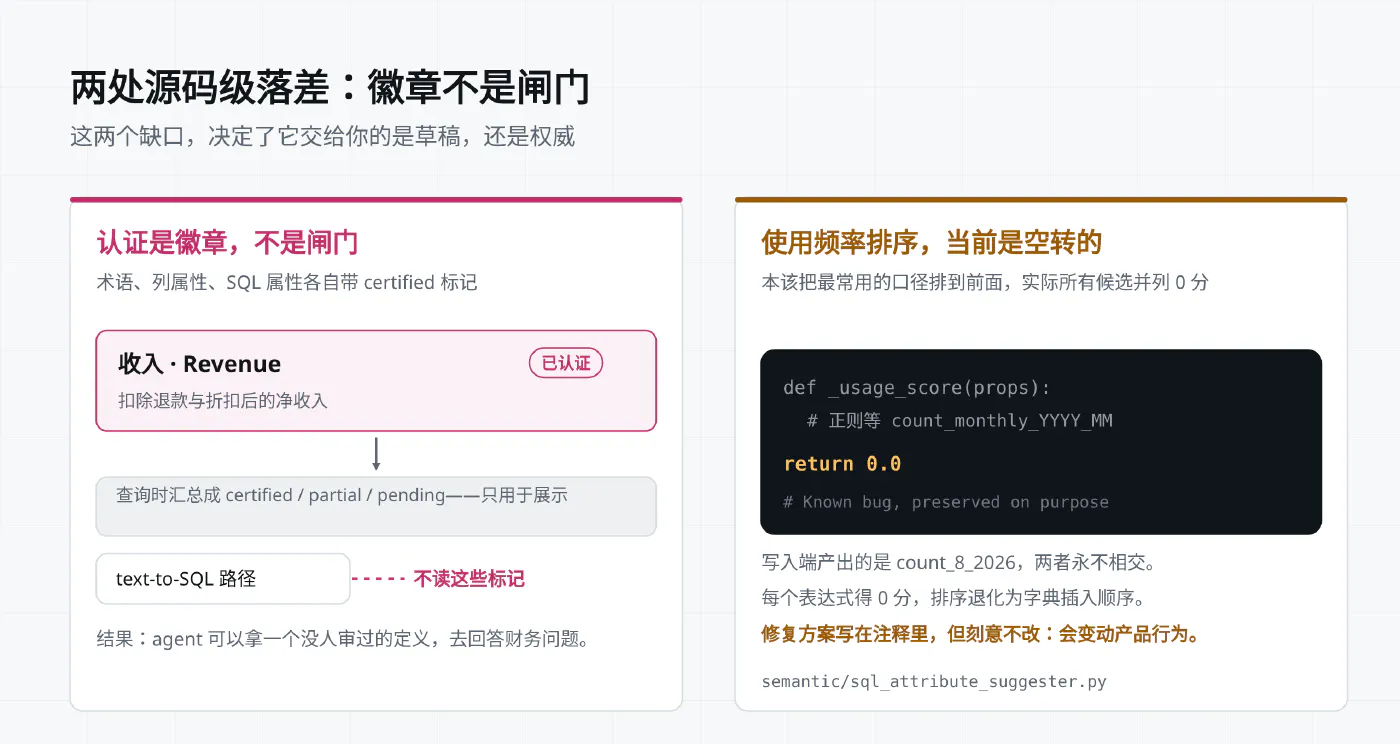
落差一:认证是徽章,不是闸门。 术语、列属性、SQL 属性各自带 certified 标志,查询时汇总成 certified / partial / pending 用于展示。我在 text-to-SQL 路径里找不到任何对这些标志的引用;NVIDIA 自己的管理 skill 也承认当前认证字段「不是原子评审/发布系统」。后果很直接:agent 可以拿一个没人审过的定义去回答财务问题。如果你的规矩是「只有审过的定义才能答财务题」,这段检查得你自己写。
落差二:使用频率排序目前是空转的。 semantic/sql_attribute_suggester.py 里那个打分函数永远返回 0.0,docstring 的原话是「Known bug, preserved on purpose. Do not “fix” this in passing.」原因是正则期望 count_monthly_YYYY_MM,而写入端产出的是 count_8_2026,两者永不相交;于是每个表达式并列 0 分,排序退化为字典插入顺序。修复方案(改用 total_counter)就写在注释里,但刻意不应用——因为一改就会改变「语义层建议哪些 SqlAttribute」这个产品行为。
这个细节是理解该项目工程态度的样本:它宁可让一段 inert 代码留在那里并写清楚为什么,也不做一个看起来在跑、实际不生效的打分器。但它也意味着**「按使用频率排序」这个本该是核心卖点的机制,现在没有生效**。
另外三件部署前该知道的事:凭据默认明文存 Postgres(除非配 HashiCorp Vault,且部分配置会回退明文);项目当前「不接受外部贡献」,MCP 包未上 PyPI,要从仓库或 NGC 容器装;以及它没有公布任何准确率数字。
七、数据(分清来源)#
| 指标 | 值 | 来源 |
|---|---|---|
| 许可证 | Apache-2.0 | 仓库 LICENSE |
| 开源时间 | 2026-11-01;10-21 GTC Berlin 随 Agent Knowledge Foundation 宣布 | 多方报道一致 |
| 默认推理模型 | nvidia/nemotron-3-nano-30b-a3b | 仓库 .env.example / 报道 |
| 编译并发上限 | SEMANTIC_LLM_MAX_INFLIGHT=6,表级 3 worker | 源码常量 |
| SQL 重建上限 | 7 次 | text_to_sql_graph.py |
| MCP 工具数 / 后台操作数 | 9 / 87 | mcp/.../tools.py 注释与 allow-list |
| 官方评测基准 | BIRD、BEAVER、FDABench-Lite、Wide World Importers、BIRD-Interact | auto-ontology-eval README |
| 评测准确率 | 未公布(仓库发布 harness 与对照设计,不含结果) | 官方仓库;流传的「快 90%」在任一仓库都不存在 |
| 一次编译产出的术语数(示例库 WWI) | 31 | README |
八、读者能自己验证什么#
不用装起整套栈就能验证本文的核心判断,两条 grep 即可:
git clone --depth 1 https://github.com/NVIDIA/auto-ontology && cd auto-ontology

# 落差一:认证标记在问答路径上无人读取
grep -rn "certified" auto_ontology/retrieval/ | grep -v test    # 期望:无输出

# 落差二:打分函数恒返回 0.0
sed -n '/def _usage_score/,/^    return/p' auto_ontology/semantic/sql_attribute_suggester.py
第一条命令没有输出,就是「徽章不是闸门」的全部证据。如果要验证端到端,Docker Compose 加一个 NVIDIA API key,对着 Wide World Importers 问 README 里那句「USB food flash drive - sushi roll 在宾州 2015 年 6 月的收入」,它应该返回 $588.80 并附上 SQL 与步骤。
九、路线图与开放问题#
它把「从空白页到可审草稿」这段从一个月压到几天,这一段是真实的价值。剩下的部分它没做完,也就成了每个使用方自己的活。
两个我现在答不上来的问题:
- 本体与源库的漂移怎么收敛? 编译是一次性的,
semantic_compilation_history只记开始、结束和粗粒度状态;当上游加了一列、改了一个枚举值,谁触发重编译、怎么保证不把人工认证过的定义覆盖掉——仓库里有一个 open issue(#268 结构化认证与原子发布)在讨论,但还没有答案。 - 查询历史既是证据也是污染源。 一条被错误口径刷了一年的看板查询,会成为最「常用」的表达式。按使用频率排序一旦真的生效,这个问题就会浮上来——也许这正是它被刻意留在 inert 状态的原因之一。
参考#
- NVIDIA/auto-ontology
(本文源码依据,提交
caced11) - auto-ontology-eval :控制组 / 处理组的对照设计与基准清单
- Xiao, Calvanese et al. Ontology-Based Data Access: A Survey, IJCAI 2018
- Towards Agentic Schema Refinement, arXiv 2412.07786
- Knowledge Base Construction for Knowledge-Augmented Text-to-SQL, ACL 2025 Findings
- A Multi-Agent System for Semantic Mapping of Relational Data to Knowledge Graphs, arXiv 2511.06455
- Snowflake Engineering: Mining Query History to Build Better Semantic Models
- Apache Ossie :Auto-Ontology 用它导入导出语义模型