一句话 把活交出去没问题,把判断权交出去是另一件事。这条下坡分成三档,每一档都像上一档的合理延伸。
中文配音版,2 分 33 秒。英文版 2 分 41 秒,同样的镜头、同样的数字。
Addy Osmani 十一月在 X 上发了一篇长文,讲 agent 时代怎么保住批判性思考。他先把立场摆清楚,自己每天都在用,一天并行开好几个会话,写这篇不是劝人少用工具。
文章的主线在另一件事上。工具越好用,人越容易停止判断,而这件事恰好没有声音。
下面把它拆成一条能画出来的斜坡,补两组可以查的数字,最后说清楚哪一步他自己也没说满。
一、判断原来长在留白里
过去的判断发生在提问和回答之间。你查资料、自己想一遍、再回来核对,中间这段时间里答案是你自己拼出来的。
现在这段时间按秒算。你读完一段写得很顺的回答,顺手就点了通过。
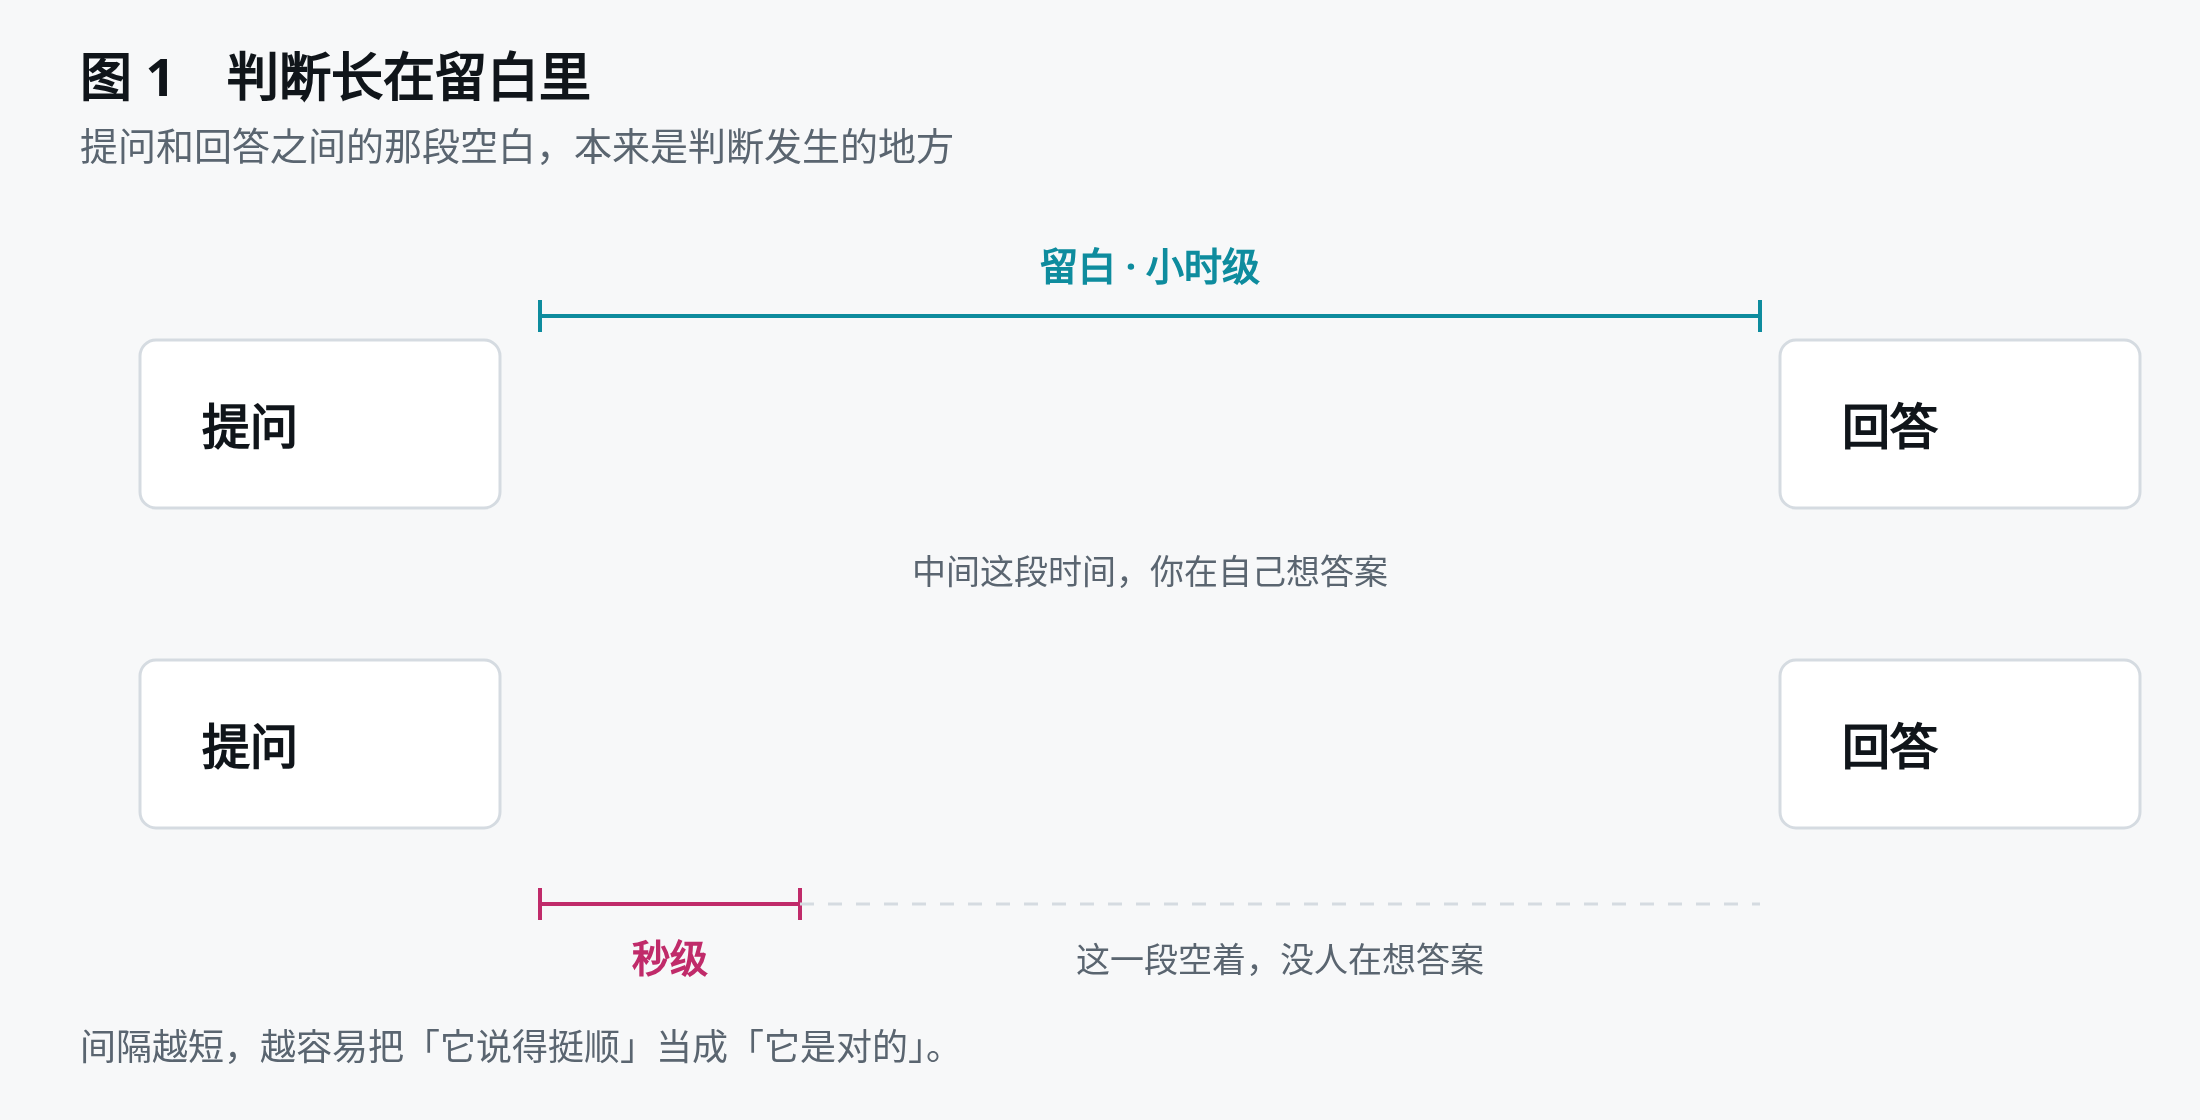
Osmani 用一句话点破这中间的差别。很多输出会写得不错,而且大体正确,但它们不要求你再看第二眼。
二、下坡分三档
他排出一条频谱,我更愿意画成一条斜坡。
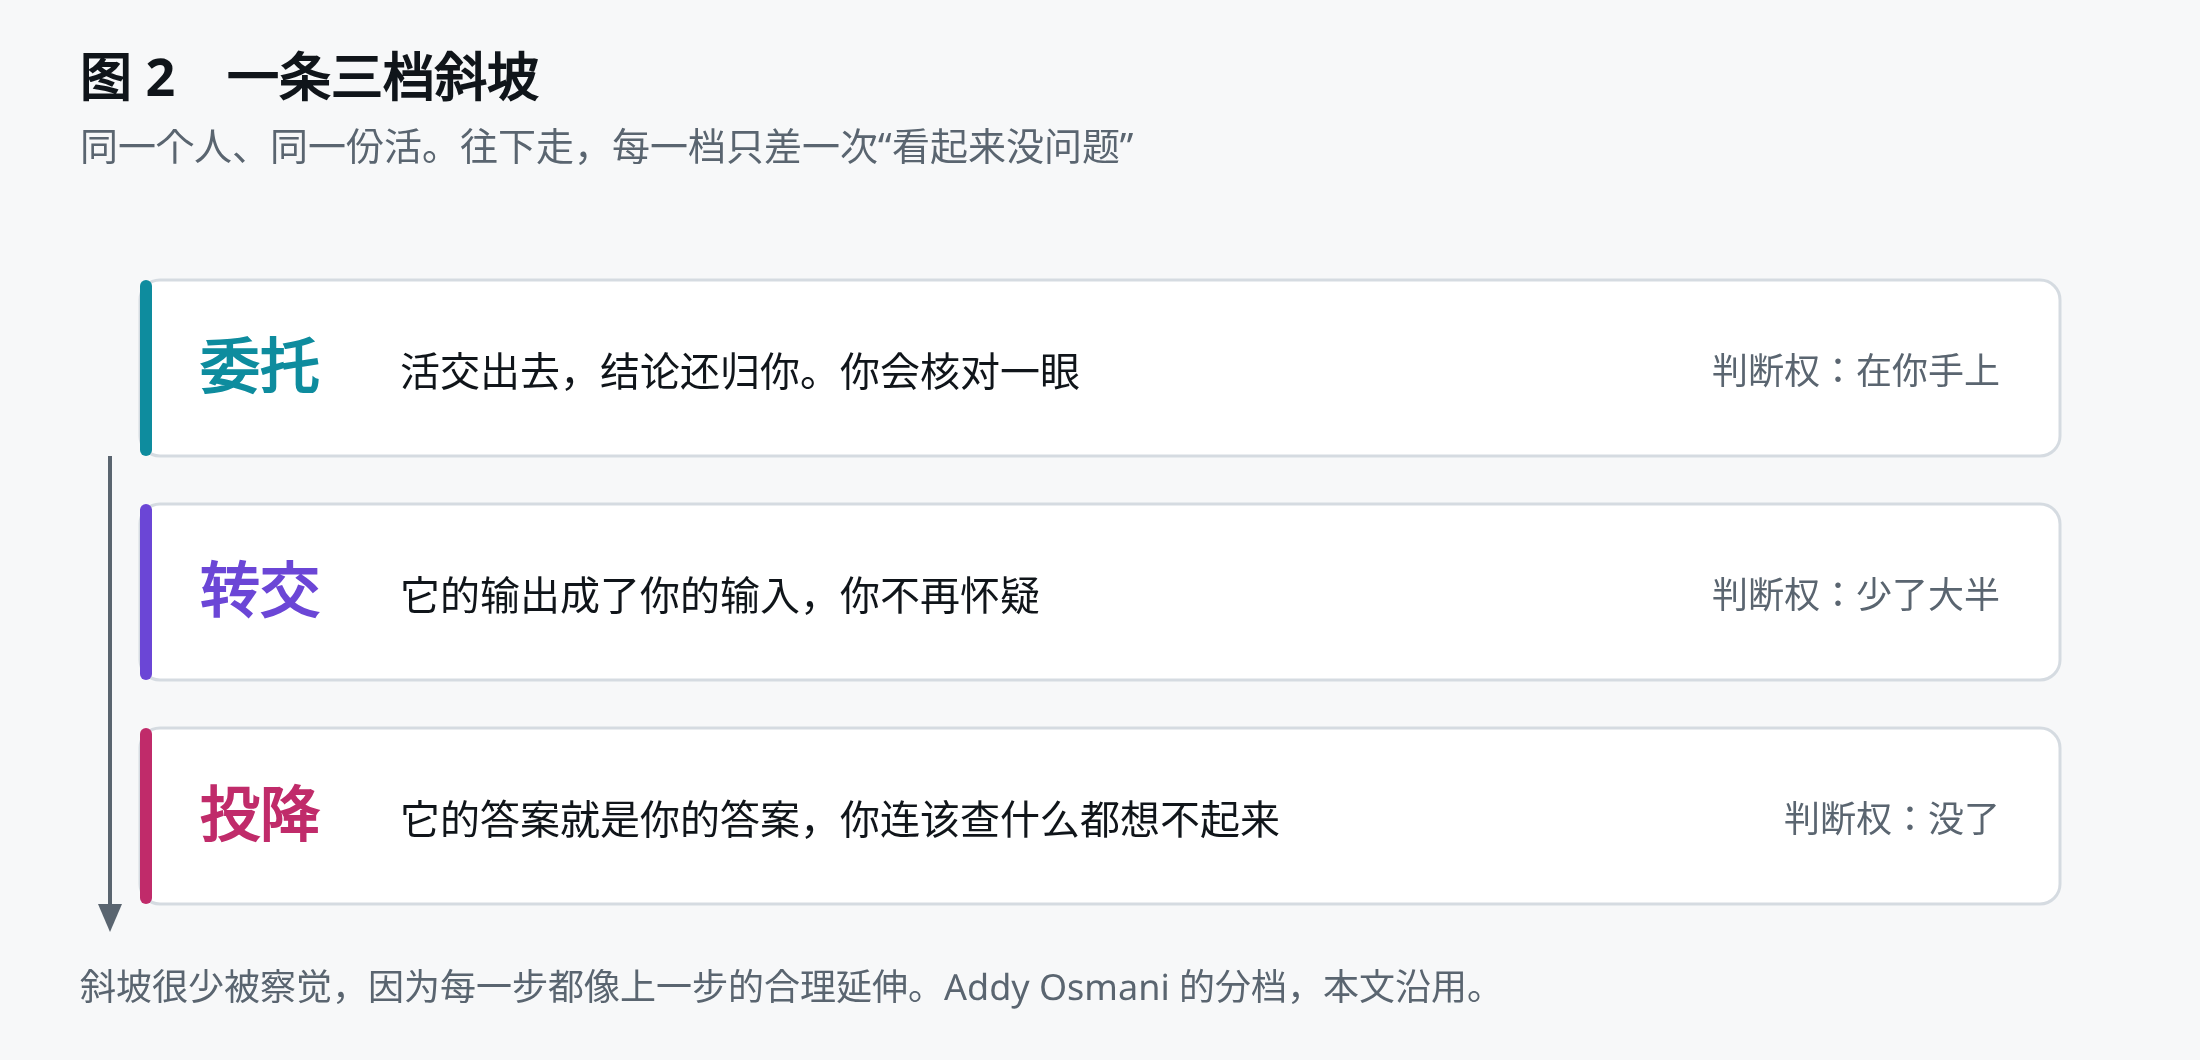
最上面一档叫委托,活递出去,结论还归你,你会核对一眼。中间一档叫转交,它的输出成了你的输入,你不再怀疑。最下面一档叫投降,它的答案就是你的答案,你连该查什么都想不起来。
认知投降这个词是沃顿的 Steven Shaw 和 Gideon Nave 在 2026 年 1 月提出的,出自他们那篇挂出来的预印本。两个人把双系统理论往下推了一层,加了 System 3,指的是发生在脑外的思考。
滑坡很少被人当场发现,因为每一步都是上一步的合理延伸。你上一份答案读完了,这一份就只扫骨架;再下一份,你连骨架都没看。等到有人在会上问起某一行,你发现自己讲不出来。
这份代价有个名字,叫认知债。代码看起来干净,测试是绿的,团队的心理模型在悄悄变薄。
三、两组实验,方向相反
Osmani 那篇偏经验,这里补两处可以查的数字。
第一组来自沃顿。三次预注册实验,一千三百七十二个人,九千五百九十三次 trial,被试在认知反射测验上作答,同时可以随时去问一个 AI。研究者用隐藏的种子提示随机决定模型答对还是答错。
结果是一个对称的摆动。往两边走。模型答对时,准确率比不用模型高二十五个百分点;模型答错时,低十五个百分点。
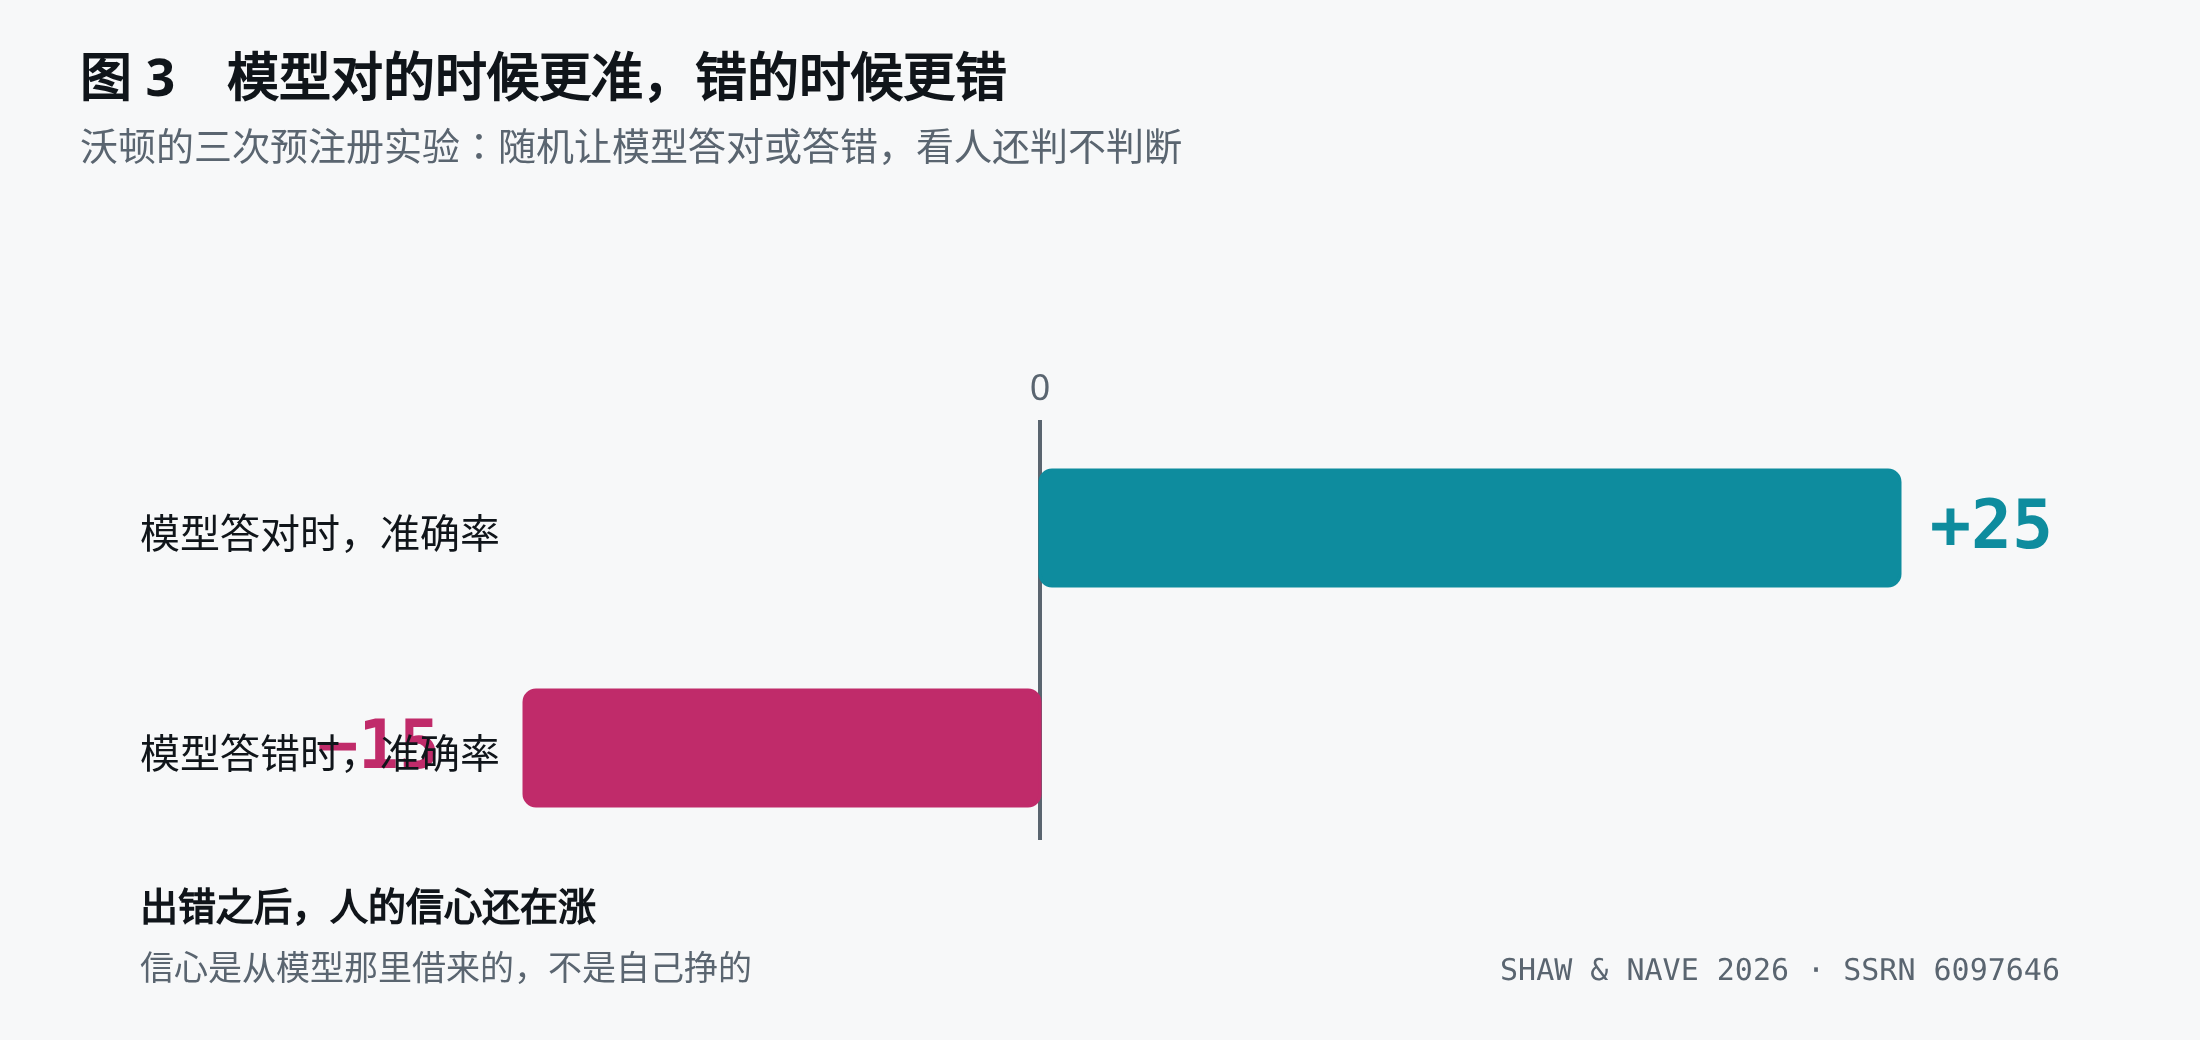
扎人的地方在信心。出错之后,被试的自信还在涨。这一条最反直觉。信心像是从模型那里借来的,而模型对什么事都很笃定。
第二组来自 Anthropic 自己对技能形成做的对照实验。研究者让工程师用 AI 辅助学一个陌生的 Python 库,再考一遍理解。
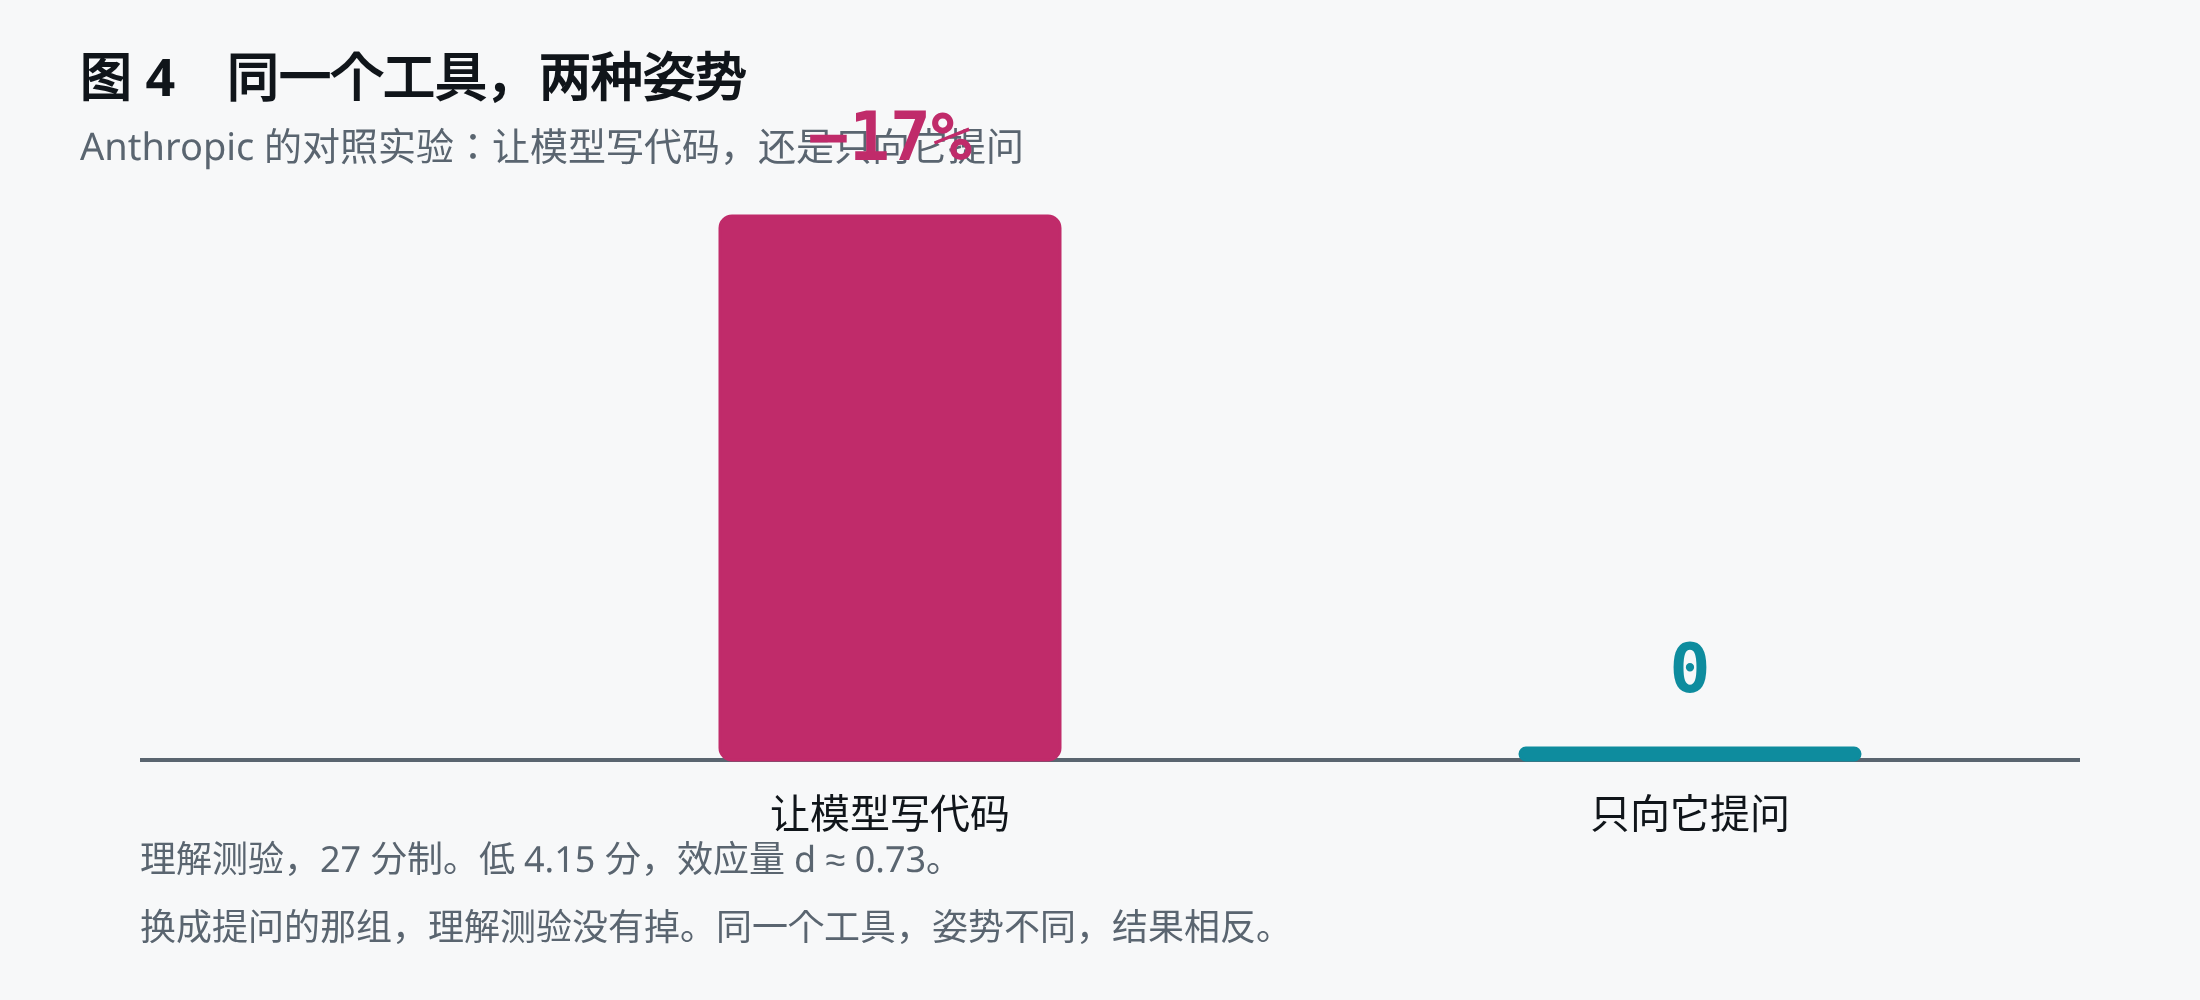
用 AI 写代码的那一组,理解测验比手写组低百分之十七,27 分制上低 4.15 分。把 AI 当作提问对象、追着问为什么要这么写的那一组,没有掉。
两条结论放在一起读,才站得住。工具本身不制造投降,姿势制造投降。
数字和它们的出处
| 指标 | 值 | 来源 |
|---|---|---|
| 沃顿实验规模 | 1,372 人 / 9,593 trials / 三次预注册 | 实测,PsyArXiv yk25n_v1 摘要 |
| 模型答对时准确率 | 比基线高 25 个百分点 | 实测,同上 Study 1 |
| 模型答错时准确率 | 比基线低 15 个百分点 | 实测,同上 Study 1 |
| 出错之后的信心 | 上升 | 实测,同上摘要 |
| 效应量 | Cohen’s h = 0.81 | 实测,同上 |
| AI 写代码组的理解测验 | 低 17%(27 分制低 4.15 分,d ≈ 0.73) | 实测,Anthropic 随机对照实验 |
| 只提问那一组 | 没有下降 | 实测,同上 |
四、动手之前,先问自己五句
Osmani 列出了他每天真在用的几个问题。我把它们压成五句,改成可以照着念的形式。
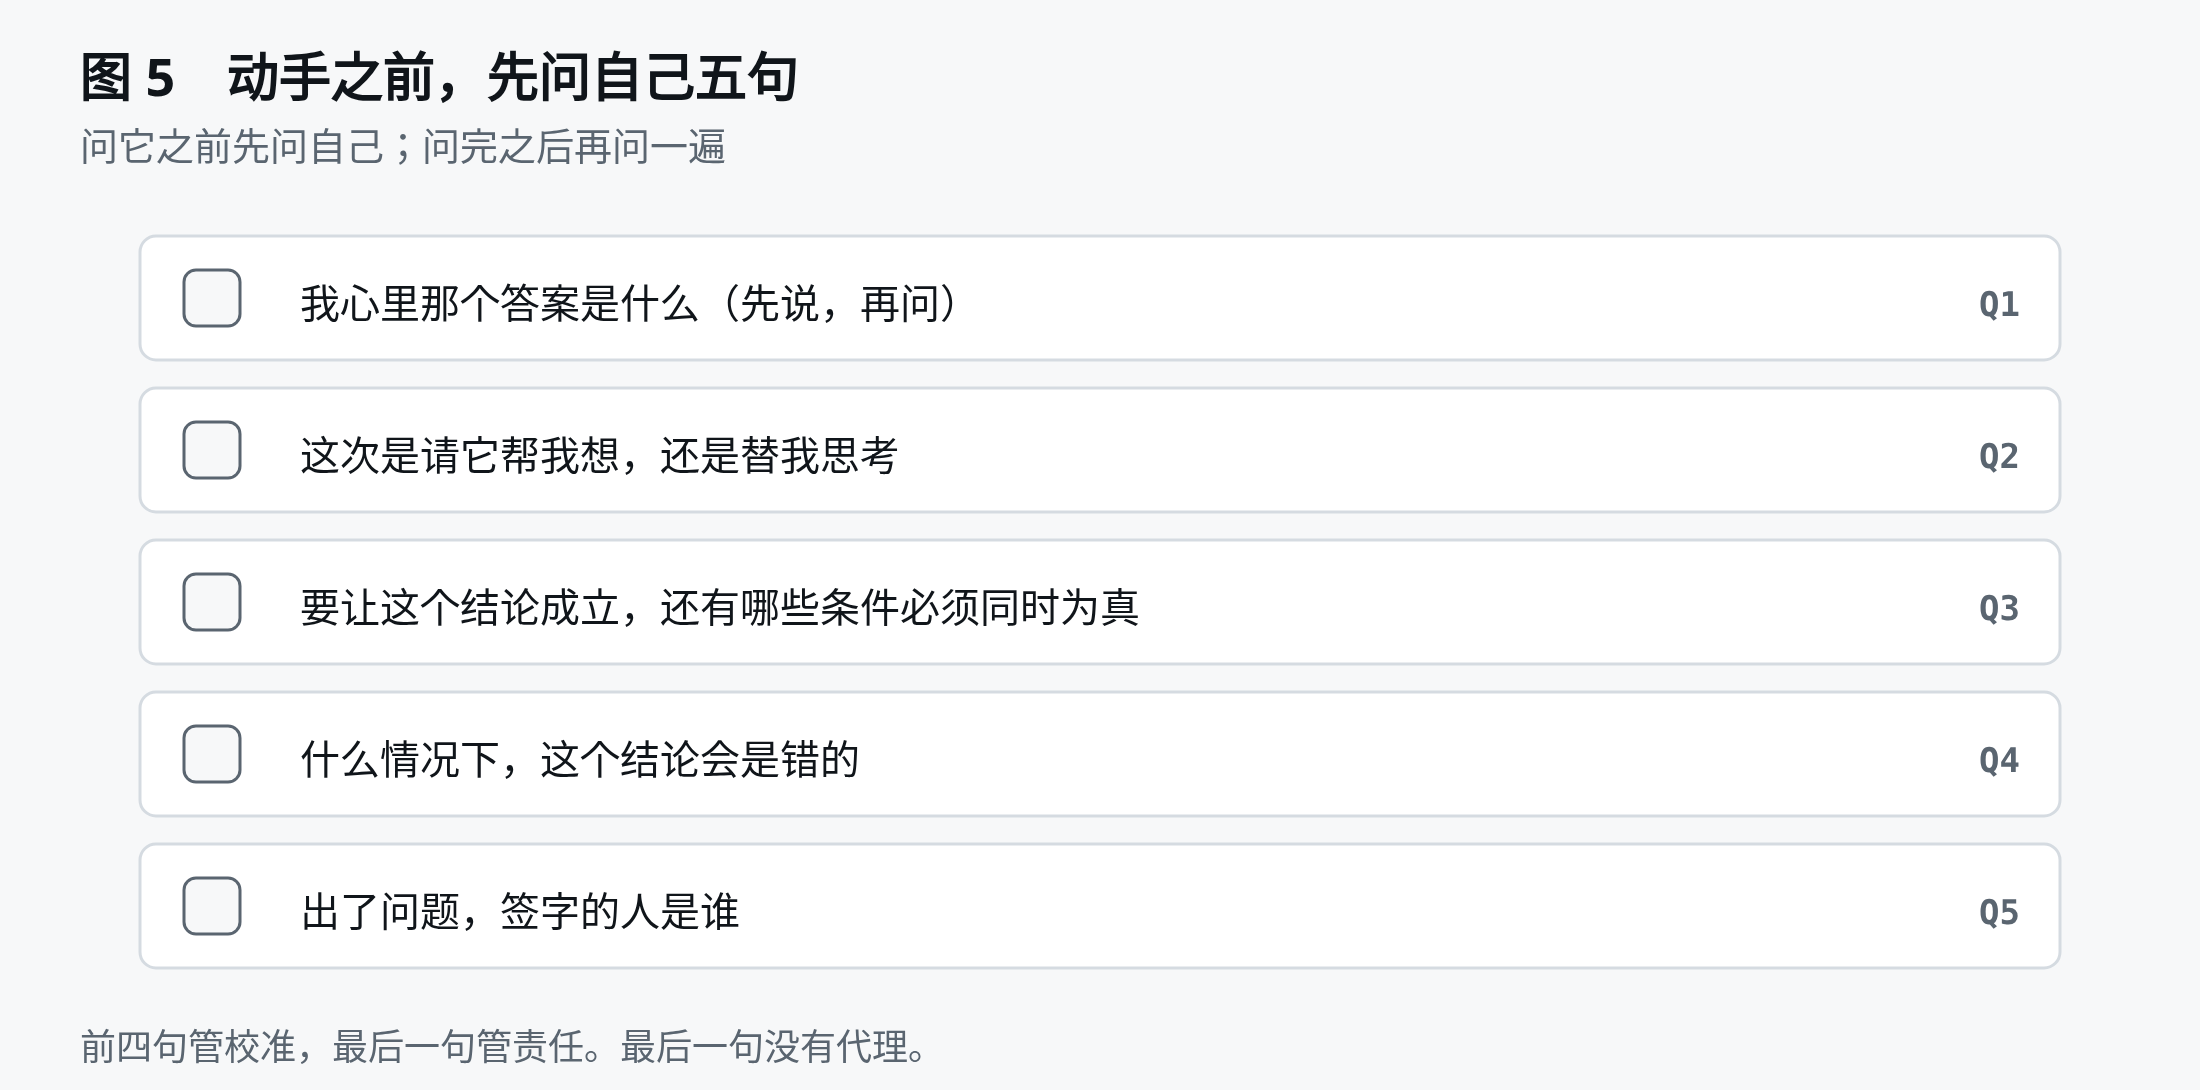
第一句是动手之前先给自己一个答案,哪怕猜错。他说得很直白。一个漂亮的回答出现之后,你很难再想象别的可能。
第二句是分清这次是请它帮我想,还是替我思考。两种用法都合法,前提是你知道自己正在用哪一种。
第三句问的是这个结论要成立,还得有哪些条件同时为真。第四句反过来问,什么情况下这个结论会是错的,然后去把它测出来。
第五句最难,也最不该外包。真出了问题,签字的人是谁。
最后这句在原文里排在很后面,我认为它应该排第一位。前四句管校准,最后一句管责任,而责任没有代理。
五、绿勾只证明一件事
关于验证,他有一段话说得比大多数工程文章都狠。把验证也交出去,问题就从「有没有证据支持我的结论」变成「检查是不是变绿了」。
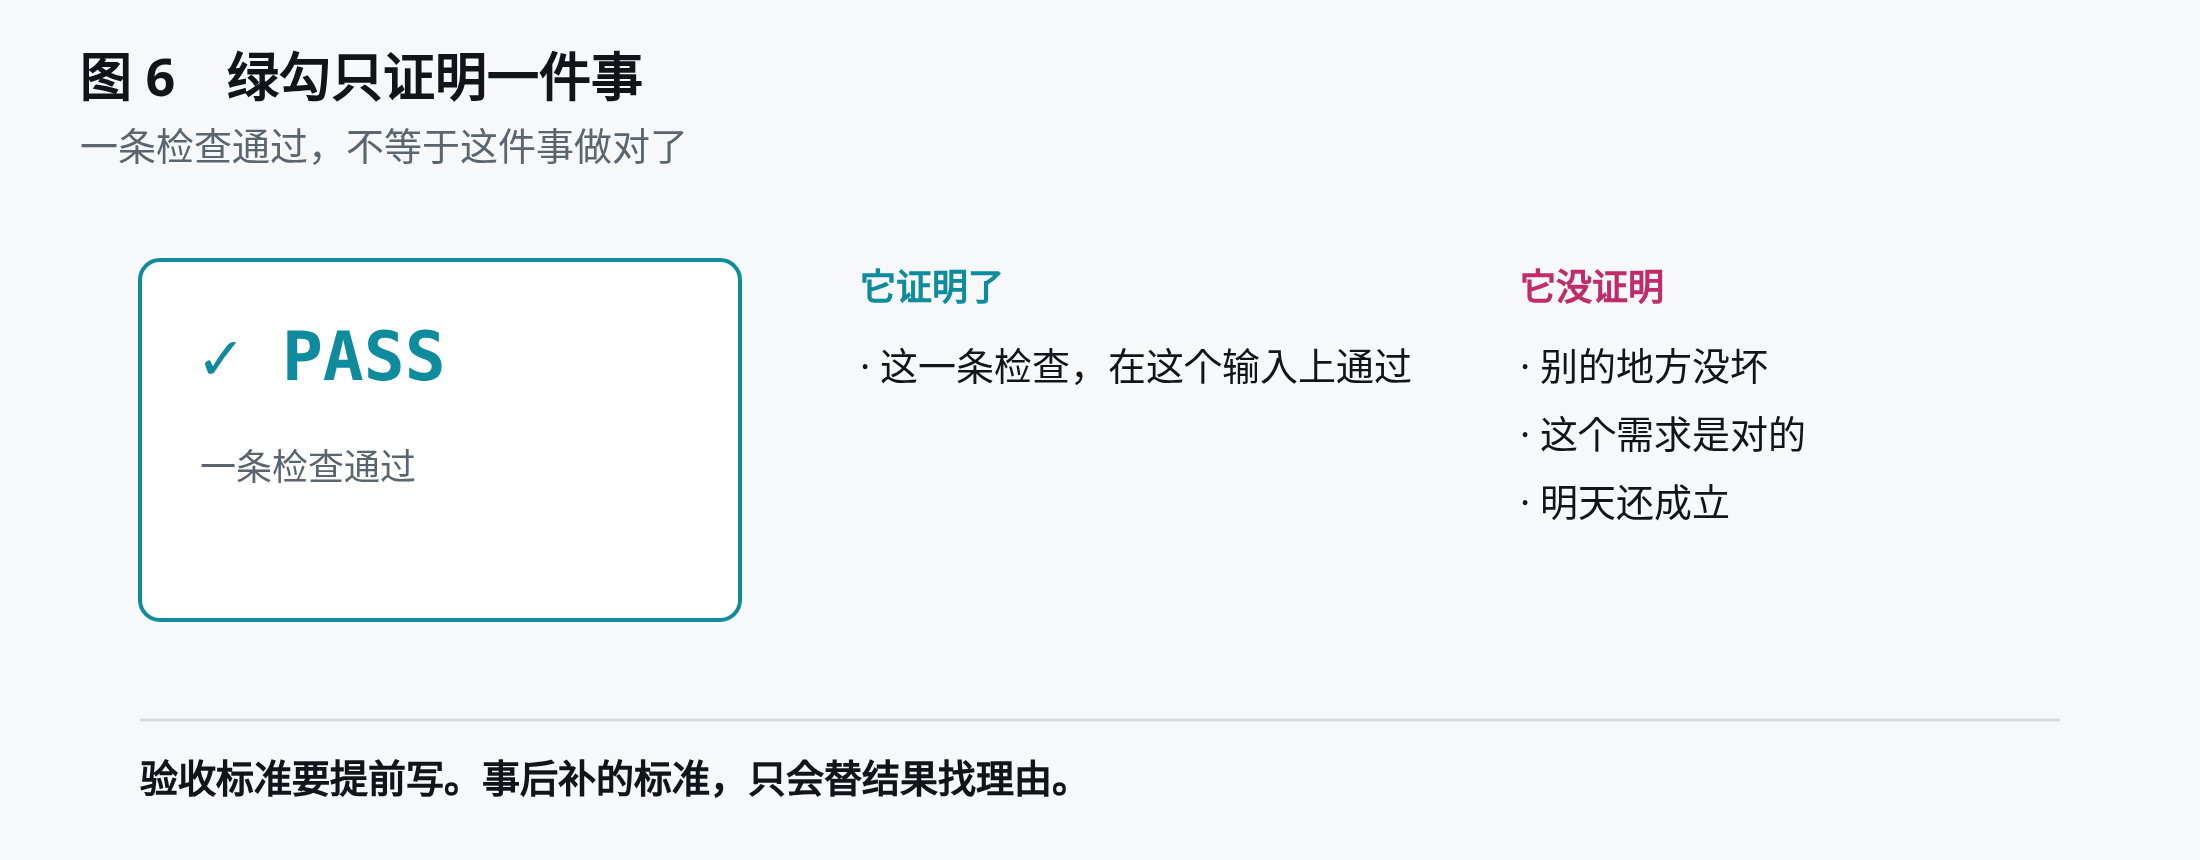
一个绿的检查只说明一件事,这一条检查在这个输入上通过了。它不说明别的地方没坏,也不说明这个需求本身是对的。测试如果和功能犯了同一个错,它会一起绿。
他的做法是把完成定义成看得见的东西,一条跑过的测试、一张截图、一段日志。验收标准要提前写,事后补的标准只会替已经发生的结果找理由。
这里还有一条容易漏的操作细节。收到 agent 的完成通知时,先看它执行了什么命令、输出了什么,再去看那段总结。总结按一切顺利的口吻写,命令和输出不会。
六、哪些地方站不住
这篇文章有几处我认为说得不够,也有几处容易被误读。
第一,委托本身不是问题。 Osmani 自己举了个例子,录课时要在三家评分相近的酒店里挑一个,他没时间读完评论,就整件交给了 AI。这类决定错了也不贵,交出去是对的。他自己划的线是,错了代价低的地方可以交,错了要别人替你承担的地方不能交。
第二,不必把整个系统装进脑子。 Claude Code 团队公开讲过他们的做法,需要理解哪一块就让模型讲哪一块,按需重建,不追求全量。所以认知债的门槛可以低一档,知道自己哪一块不懂就够了。
第三,沃顿那组数字不能直接搬到代码审查上。 他们用的是认知反射测验,题目短、有唯一答案,和你面对一个六百行的 PR 是两回事。二十五个百分点这个量级说明方向,不说明你在自己项目里能拿到同样的收益。
第四,Osmani 二月那篇里写的「73% 的时间接受了错误答案」,本文没有采用。 预印本摘要给的是正负百分点,73% 这个数我没法从公开材料里复现。同一支笔下出现这种落差,二手数字要用之前,还是得回到源头。
七、这周的三个动作
道理讲完,落到日程上才有用。
| 频率 | 动作 | 为什么是它 |
|---|---|---|
| 每周一次 | 不用 agent 写一段真代码 | 目的是校准,不在道德。手感没了,你不知道自己还剩多少 |
| 每月一次 | 写下这个月不再亲手做的事,决定哪些可以放手 | 技能荒废是渐进的,写下来才有得选 |
| 每次交付 | 把验收标准写进配置、钩子或测试 | 品味靠这个累积,下次它自己会拦住同一类问题 |
他在文末留了一句最像结论的话。能力可以外包,责任不行。
参考
- Addy Osmani, Critical thinking in the age of agents(X 长文,2026-11)
- Addy Osmani, Cognitive Surrender
- Steven D. Shaw & Gideon Nave,
Thinking—Fast, Slow, and Artificial(PsyArXiv / SSRN 6097646,2026-01),https://osf.io/preprints/psyarxiv/yk25n_v1 - Anthropic, How AI assistance impacts the formation of coding skills
- Anthropic, How AI Is Transforming Work at Anthropic