不再检索,改成问路:DecisionRAG 用决策模型在文档树上走
DecisionRAG 不做第一阶段检索,也不建向量索引:每层把候选标题放进同一个上下文,用一次前向的一批是非题决定走哪一支。四个基准九格指标赢六格,输的三格和它的代价都写在正文里。
检索的瓶颈不在候选池有多大,而在你让模型看见什么、以什么顺序看。DecisionRAG 把打分换成问路,2.68M 段的语料 1.7 秒给出 65.4 的首位命中;它同样清楚地输掉了三格。
中文配音版,2 分 53 秒。中文与英文两版内容一致。
原文是《Retriever-Free Retrieval: Navigating Documents with Decision Models》,Cornell 与 ASAPP,arXiv 编号 2610.35868,全文 21 页(arXiv 页面 ,PDF )。下面每个数字都能回到原文的表号或附录号,凡是我自己算出来的都标了「我算」两个字。
一、错的那一条,排在第一#
论文开篇是一个具体的查询。诺兰在 2000 年拍的那部电影,主角是谁。BM25 和稠密检索都会把《角斗士》排到前面去。它也是 2000 年的电影,词像,向量也像。真正能回答问题的《记忆碎片》排在后面,甚至不在前几名。
检索器的接口只有一种比法,把查询和每个候选单独比一次。生成器已经换了两代,检索器还在做词频和余弦。
| 环节 | 现状 | 后果 |
|---|---|---|
| 词频 | BM25 在 MultiDoc2Dial 上 R@1 20.6 | 词重合不等于可答 |
| 稠密 | Qwen3-Embedding-8B 27.9 | 召回上限由一阶段定死 |
| 重排 | 8B 重排器把 27.9 抬到 33.6 | 只能重排已经给它的候选 |
| 生成式重排 | GPT-5 重排 dense top-20 到 47.5 | 贵、慢,仍是两段式 |
论文把这件事叫作能力不对称。检索器漏掉的证据,生成器再强也捞不回来。这个判断没什么新意,有意思的是它选了哪条路来修。
二、之前到哪一步了#
修这条路有三族做法。
| 一族 | 代表 | 天花板在哪 |
|---|---|---|
| 一阶段 + 重排 | BM25、SPLADE++、Qwen3-Embedding、BGE、Qwen3-Reranker-8B | 重排的输入永远是一阶段给的 100 条 |
| 生成式 listwise | RankGPT 一路,GPT-5 重排 | 一次只能看 20 条,成本按 token 走 |
| 让 LLM 走层级 | MemWalker、PageIndex、LATTICE | 每层都要生成一串编号,慢 |
第三族离这篇最近。它们已经有层级,也已经在每一层做选择,只是选择的方式是「生成」。同一套层级、同一套预算,换成 GPT-5 逐字写出要保留谁,在 ConditionalQA 上要 28.2 秒,在 Natural Questions 上要 250.8 秒(论文表 6)。
论文换掉的就是这一步。把生成一串编号,换成一次前向里的一批是非题。决策模型(Jev 1.13、OpenAI 的 gpt-6-luna-decisions)本来就干这个,给定上下文和一批问题,返回每道题的选项概率,不生成 token。
三、三个约束#
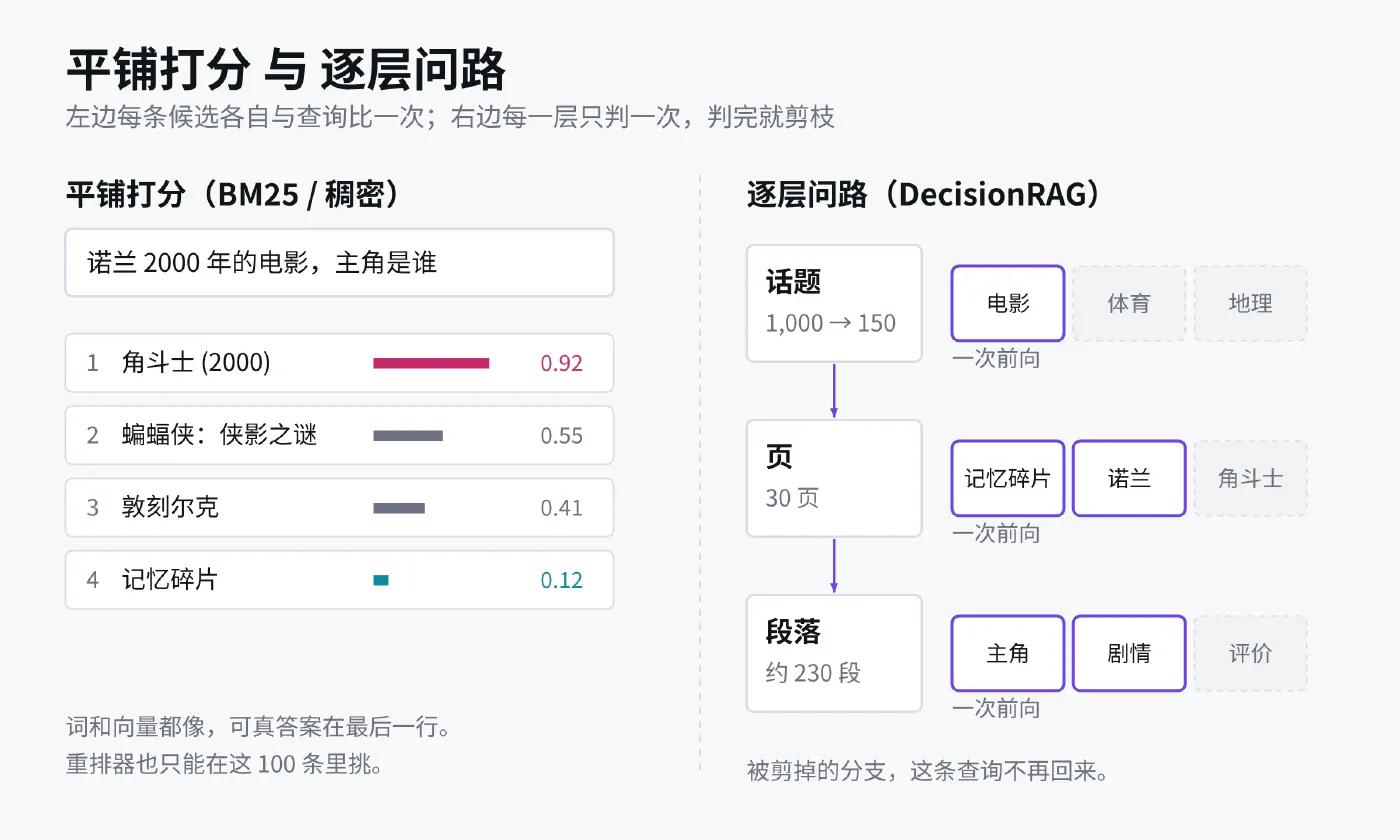
图 1 挖掉的是「所有段必须各自和一个查询比一次」这个前提,不是把段落换成标题。
每层一次前向。 一层里所有候选的标题放进同一个上下文,每道题问一次「这一支值不值得走」。自然问题的顶层是 1,000 个簇描述,一次请求装不下,就拆成 8 个并行请求;页标题约 17,500 个,按 20k token 一批切开。剪枝不可逆,某一层丢掉的支,这条查询里不会再回来。
分数在有人陪着的条件下形成。 二元题的概率只在「是」和「否」之间归一,不在候选之间归一,所以不同请求的分数不可比。论文的办法是把候选放在一起判,让每个概率在「旁边有更好的」这个条件下形成。它不承诺概率本身准,只保证同一批候选之间的相对位置。
没有索引,也没有任务训练。 查询时不跑第一阶段检索,不加载向量索引;预算和路由规则只在设计集上选过(MultiDoc2Dial 训练集样本、ConditionalQA 300 道训练题、MTRAG 50 条合成对话加 131 条 MTRAG-UN 轮次),不更新任何权重。
两个判定模式对应两种需求。内层要召回,用并行二元题,候选数只受上下文长度限制,概率加起来不等于一。最后一层要第一名,用多选题,二十个候选互相当竞争者,概率加起来等于一。Jev 的选项上限是 255,所以多选只用在二元筛过之后的前 20 名(自然问题前 5 名)。
四、跑起来是什么样#
以自然问题为例,一条查询经过的是一个三层树。
| 层 | 候选 | 判定 | 留下 |
|---|---|---|---|
| 簇 | 1,000 个描述(Qwen3-8B 从页标题写的一句话) | 8 个并行请求的是非题 | 150 个簇 |
| 页 | 约 17,500 个标题,按 20k token 分批 | 并行请求,分数 pooled | 30 页 |
| 段 | 前 3 页全部,第 4 至 10 页各前 10 段,第 11 至 30 页各前 3 段,约 230 段 | 一次共享上下文的是非题 | 前 5 段交给多选 |
| 多选 | 前 5 段 | 多选题,Σp = 1 | 最终排序 |
两个补丁值得单拎出来,代价就在这里。
- 段落分要乘上页的概率。 两层的二元分不在同一把尺子上,只能靠乘法硬凑。
- 页标题的分数来自不同请求。 1,000 个簇切成 8 个请求、17,500 个页标题切成若干批,然后直接混在一起排序。按论文自己在 §3.2 的说法,跨请求的分数本不可比;只有 MTRAG 对 top-50 做了二次 rescore。这是这套方法里最不干净的一处,论文没有回避,但也没有量化它的代价。
四个数据集的预算各不相同,因为层级不同。MultiDoc2Dial 是 4 个帮助中心 → 413 页 → 4,110 段,ConditionalQA 是 652 页 → 58,483 段,MTRAG 是 172 个产品 → 8,578 页 → 72,442 段,自然问题是 1,000 簇 → 108,626 页 → 2,682,017 段。
五、九个指标,赢六格#
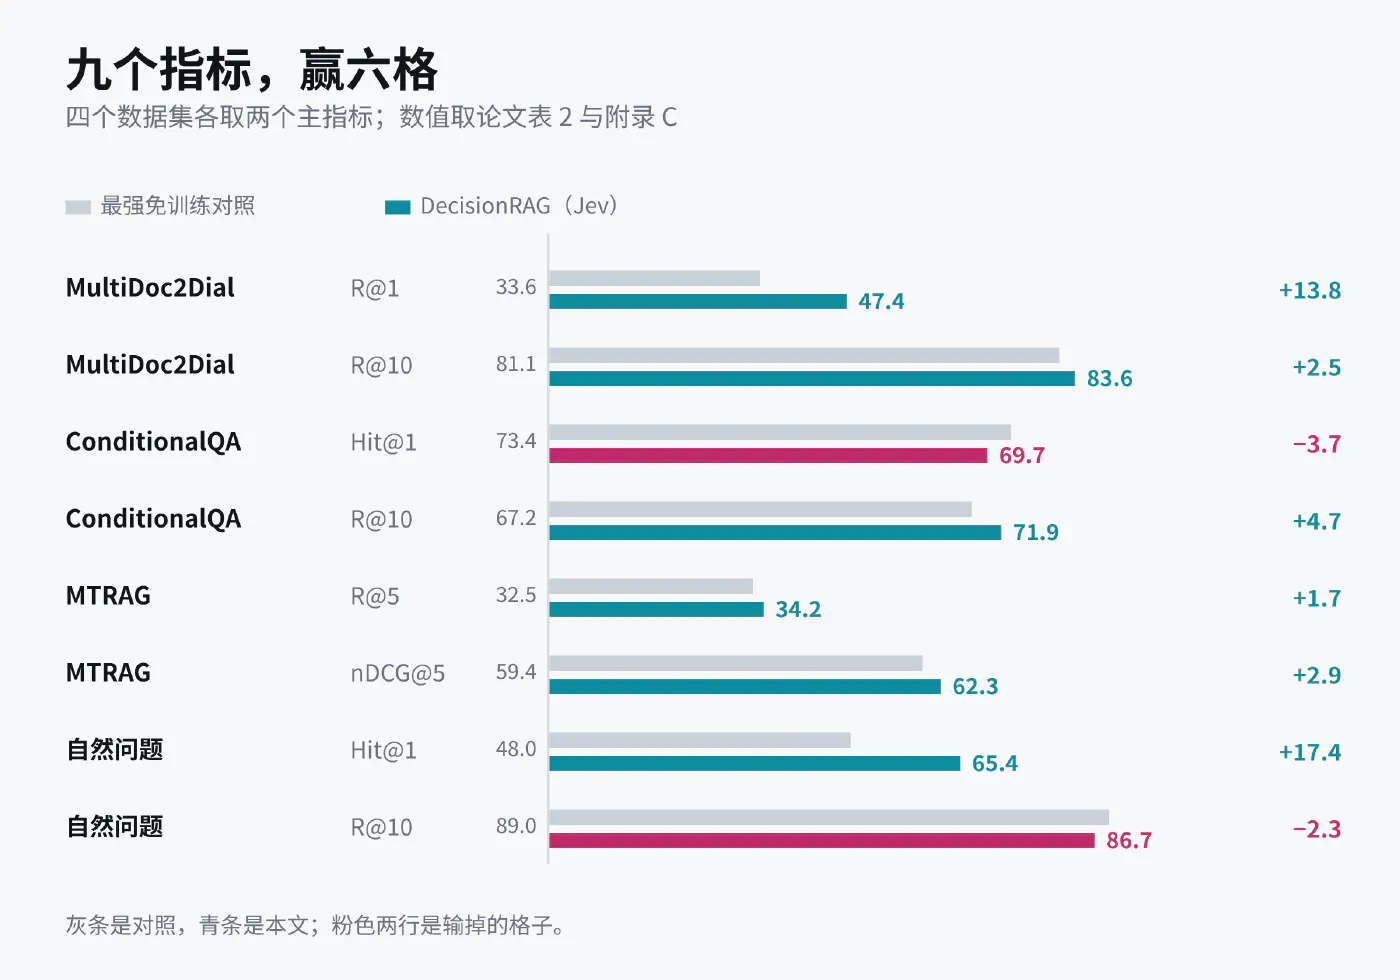
图 2 赢的六格里,有两格的绝对值只领先 1.7 和 2.5 个点,读的时候要看区间。
| 数据集 | 指标 | 本文 | 加 dense 候选 | 最强免训练对照 | 差 |
|---|---|---|---|---|---|
| MultiDoc2Dial | R@1 | 47.4 | 48.5 | 33.6 | +13.8 |
| MultiDoc2Dial | R@10 | 83.6 | 84.7 | 81.1 | +2.5 |
| ConditionalQA | Hit@1 | 69.7 | 73.4 | 73.4 | −3.7 |
| ConditionalQA | R@10 | 71.9 | 76.3 | 67.2 | +4.7 |
| MTRAG | R@5 | 34.2 | 36.6 | 32.5 | +1.7 |
| MTRAG | nDCG@5 | 62.3 | 65.0 | 59.4 | +2.9 |
| 自然问题 | Hit@1 | 65.4 | 66.4 | 48.0 | +17.4 |
| 自然问题 | R@10 | 86.7 | 88.9 | 89.0 | −2.3 |
| 自然问题 | nDCG@10 | 76.0 | 77.6 | 74.6 | +1.4 |
输的三格。
- ConditionalQA 的首位命中输给 GPT-5 重排 3.7 个点。加上 dense 候选后追平(73.4)。
- 自然问题的前十召回输给一个 8B 重排器 2.3 个点,但 nDCG@10 领先 1.4 个点,说明它的排序在前几名更好、尾部更差。
- MultiDoc2Dial 的首位召回 47.4 对 GPT-5 重排的 47.5,是平手;差别在 R@10,83.6 对 78.6。
还有一个容易忽略的敏感性检查。MultiDoc2Dial 里有同一段文本挂着不同 ID 的情况,按文本去重之后,本文 R@1 从 47.4 涨到 55.8(加 dense 57.0),dense 加 8B 重排器从 33.6 涨到 40.3。两边都涨,差距从 +13.8 变成 +15.5,排序没变(附录 E.1)。
八 B 权重自己训一个判官,MultiDoc2Dial 首位召回到 60.7,比已发表的最好训练式检索器高 5.7 个点;只在 MultiDoc2Dial 上训能到 63.1(附录表 17)。这套框架也能从梯度里受益。
六、共享上下文值多少#
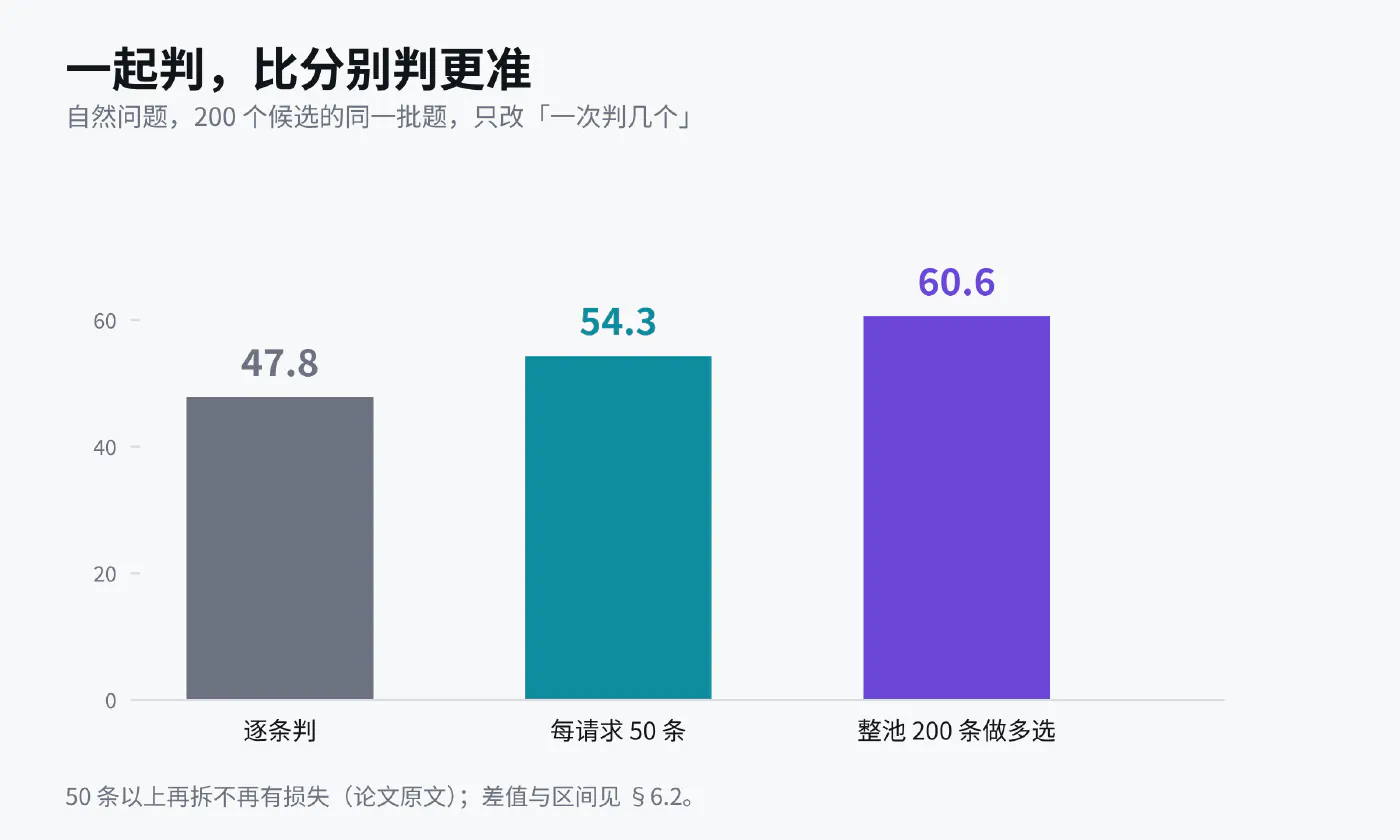
图 3 逐条打分 47.8,每请求 50 条 54.3,全 200 条一次做多选 60.6。
论文把「一起判」拆成三组可复算的对照。
| 对照 | 结果 | 区间 |
|---|---|---|
| MultiDoc2Dial:逐页打分 → 所有页的段放一起判 | 36.7 → 44.4 R@1 | +7.7 [3.3, 12.2] |
| 自然问题:200 候选逐条 → 每请求 50 条 | 47.8 → 54.3 Hit@1 | 图 6 |
| 自然问题:200 候选全放一起做多选 | 60.6,比同池二元高 6.8 | [2.5, 11.0] |
| ConditionalQA:加多选重排 | 71.9 → 76.5 Hit@1 | 未给 |
| MultiDoc2Dial:加多选重排 | 50.1 → 51.3 R@1 | 未给 |
第一,共享上下文做的是相对化,不是标定。一个单独看很像的候选,旁边有更好的,分数就掉下来。所以它解决的是「谁比谁更值得走」,不是「这个概率准不准」。
第二,收益在每请求 50 条附近饱和。好消息是 17,500 个页标题可以放心切成几十个请求。坏消息是它同时削弱了必须全局可比这个论证,因为一旦拆分,你拿到的就是跨上下文的分数,而这正是论文 §3.2 说不可比的东西。
第三,多选重排是便宜的收尾。一次请求 0.12 到 0.15 秒,成本涨 4% 到 33%,ConditionalQA 首位命中涨 5.3 个点。它和多选在 MTRAG 上只把最高分那一段提到第一位,是因为长回复的金标本来就是多段。
七、候选更少,第一名反而更准#
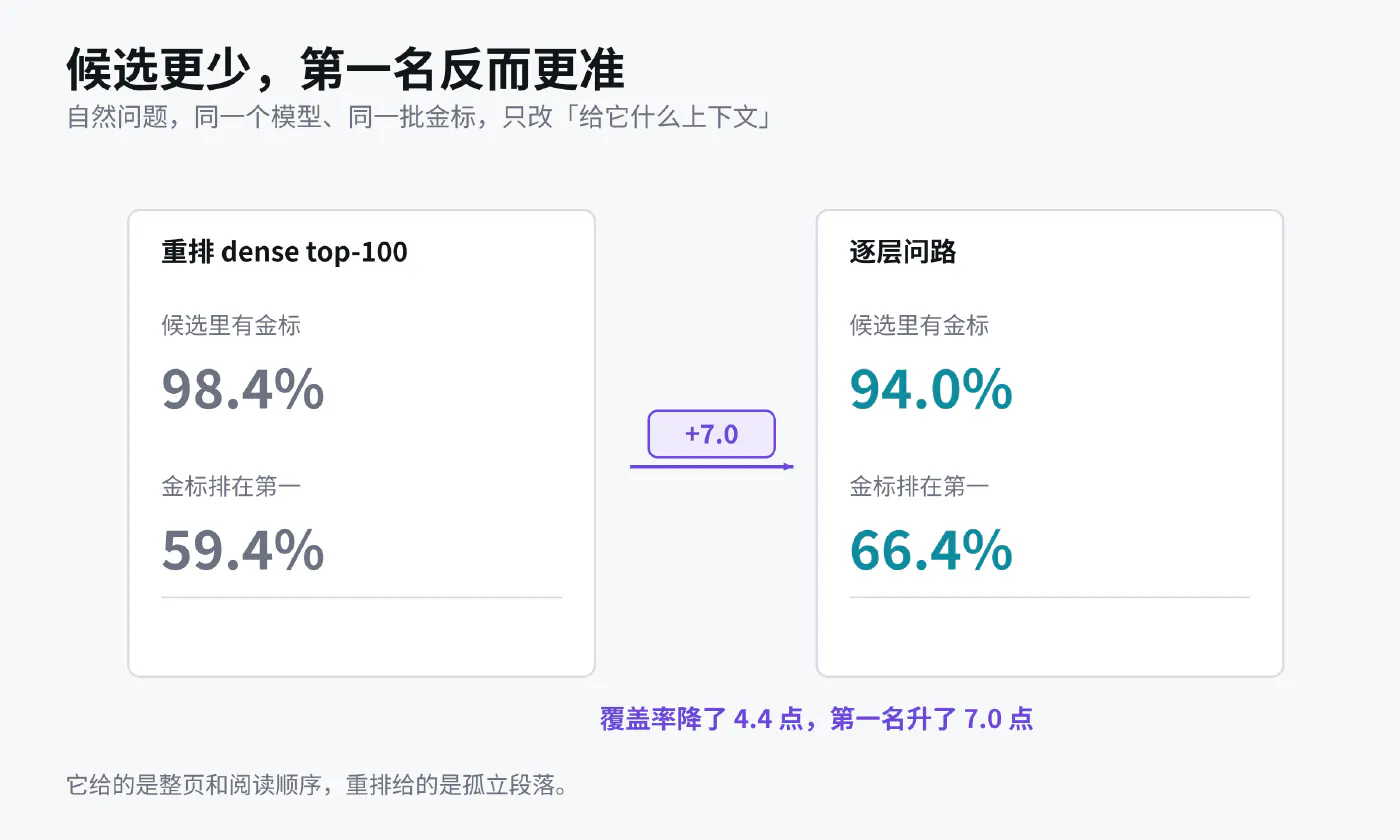
图 4 自然问题上的一对数字。候选含金 98.4% 对 94.0%,把金标排第一 59.4% 对 66.4%。
同一个 Jev,去重排 Qwen3-Embedding-8B 的前 100 条,和走层级做同一件事。
| 候选含金 | 金标排第一 | |
|---|---|---|
| 自然问题:重排 dense top-100 | 98.4% | 59.4% |
| 自然问题:走层级 | 94.0% | 66.4% |
| ConditionalQA:重排 dense top-100 | 98.5% | 65.7% |
| ConditionalQA:走层级 | 91.1% | 73.4% |
候选更少,第一名更准,两个数据集上分别 +7.0 [3.4, 10.8] 和 +7.7 [2.6, 13.3]。MultiDoc2Dial 只涨 1.3,MTRAG 只涨 0.4,说明这个效果不是万能的。
论文给的解释是「给整页和阅读顺序,而不是孤立段落」,这和 DAPR 那条线(文档感知的段落检索)同向。这组数字真正的价值在于它把检索质量拆成候选覆盖率和排序能力两件事。层级牺牲了一点覆盖率,换到了更好的排序条件。
它也顺手暴露了瓶颈在哪。ConditionalQA 上,三页配置漏掉金页只占 8.5%,但「金页到了、却排了同一页的别的段」占 13.7%,「排了别的页的段」占 9.6%。MultiDoc2Dial 给定金页时,段落首位召回也只有 62.7。导航解决的是页找没找到。剩下的误差落在段落层,而段落层的判定正是共享上下文那一次。
八、代价,和四个薄弱处#
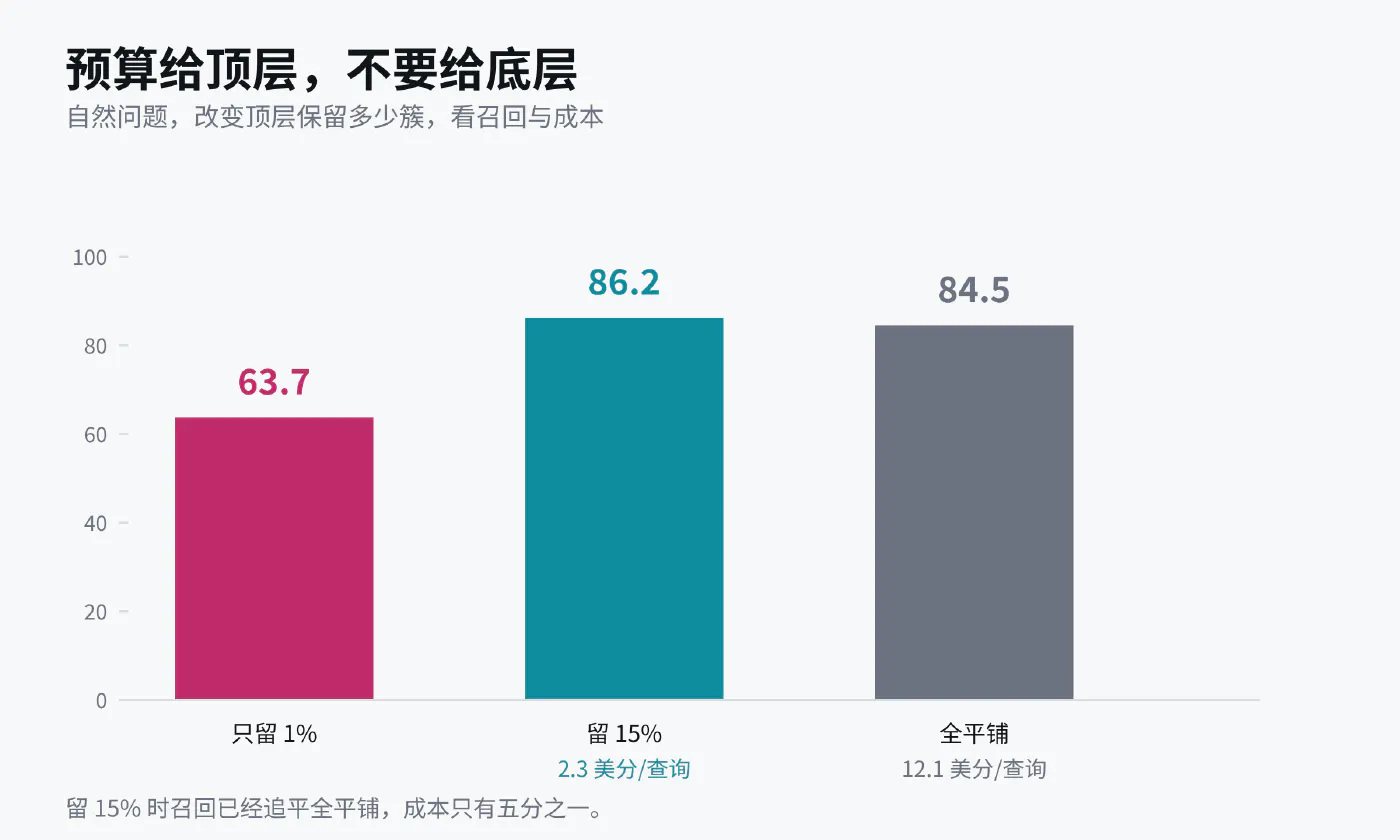
图 5 保留 15% 的簇时,R@10 是 86.2,全平铺是 84.5,成本 12.1 美分对 2.3 美分。
| MultiDoc2Dial | ConditionalQA | MTRAG | 自然问题 | |
|---|---|---|---|---|
| 本文 p50(秒) | 0.68 | 0.82 | 1.76 | 1.73 |
| 本文 p95(秒) | 0.91 | 1.02 | 2.26 | 2.54 |
| 本文美分/查询 | 0.22 | 0.29 | 1.73 | 2.33 |
| 本机单卡 dense + 8B 重排(秒) | 7.51 | 3.33 | 14.33 | 5.8 |
| GPT-5 重排(秒 / 美分) | 11.8 / 1.40 | 14.4 / 1.20 | 12.2 / 1.90 | 15.0 / 1.40 |
| GPT-5 生成式导航(秒 / 美分) | 未测 | 28.2 / 6.1 | 未测 | 250.8 / 57.2 |
论文写 34 到 145 倍的延迟优势、21 到 25 倍的成本优势,我按表 5 与表 6 复算过,对得上(28.2/0.82 = 34.4,250.8/1.73 = 145,6.1/0.29 = 21.0,57.2/2.33 = 24.6)。
但这两个倍数要打折看。基线的计时是本机单卡跑 100 条候选的重排,本文是调 API、一条查询内最多 8 并发,论文自己在附录 F 写明不是受控加速比。同一张卡上 dense 编码加检索只要 0.05 到 0.08 秒,7.5 秒里几乎全是重排在等 GPU。换成同等的服务化,这个倍数会小很多。
成本也不是对数的。延迟随层级深度走(T(N) ≈ t_req ⌈log_b N⌉,b=100 时 10⁹ 段只要 5 次决策、约 1 秒),但每层要判 k·b 个候选,成本跟着这个乘积走。自然问题一条查询 2.33 美分,已经接近 GPT-5 重排的 1.40 美分。
- 结构是造的。 自然问题的 1,000 个簇来自 e5-base-v2 编码「标题 + 首句」后的 k-means,簇描述由 Qwen3-8B 从页标题写一句话。维基的标题信息量大,这一层成立;换成合同、日志、代码,标题读不懂,顶层就塌。论文在局限里承认了这一点,但没有给出一个「标题不可读」的数据集来量化它。
- 跨请求分数不可比,却被直接 pooled。 见第四节。这是设计里最不干净的一处。
- 「零任务训练」有保留。 权重没动,但预算、路由、问题措辞都按数据集在设计集上选过。问题措辞尤其关键。agent 下一次回复要不要依据第 n 段,和第 n 段是否包含回答需要的信息,是两种不同的题。
- 评测口径要看清。 MultiDoc2Dial 的官方 test 不可用,用的是 4,201 轮验证集;自然问题只抽了 500 题(DAPR test 3,610 题的固定子集);MTRAG 的金标由 GPT-5 扩充过,它把原金标里 87.9% 判为「答案需要」,18 个系统的 top-5 池化后再判(附录 A.3)。
还有一条不算论文自身的问题。头号结果依赖 Jev 1.13 这个商业决策模型。论文自己训的开源权重是能给方向的,但通用 8B 判官只有 40.4 首位召回,低于 Jev 的 47.4;1.7B 只有 20.5,比 BM25 的 20.6 还差一点。也就是说,「不训练就能用」这句话只对那一个闭源模型成立。
九、怎么用,以及两个答不上来的问题#
如果要在自己语料上试,三条来自论文数字的判断。
- 钱花在顶层覆盖,不要花在底层重排。 顶层从 1% 拉到 15%,R@10 从 63.7 到 86.2;把页预算从 3 加到 10,R@10 只涨 2.6,成本涨 83%、延迟涨 28%。
- 和 dense 混着用。 加 dense top-20 之后,四个数据集的 R@10 全部改善(83.6→84.7、71.9→76.3、86.7→88.9、34.2→36.6),说明两者捞到的是不同的证据。论文标题里的 retriever-free 是设计取向,不是部署建议。
- 先量标题。 抽 100 个页标题,人能不能只看标题判断相关。判不出来,这套方法的第一层就不成立,先去修标题或换结构。
两个我现在答不上来的问题。
- 层级的描述质量能不能不靠前沿模型生成,而由语料自己给(链接图、目录、schema)?论文里连簇描述都是模型写的,这一层的能力依赖没有被单独测量。
- 决策模型的分数能不能跨层、跨请求校准?现在靠「段落分乘页概率」和「top-50 二次 rescore」两处补丁,补丁的代价没有量化。
参考#
- Wan, Jünger, Du, Liu, Krishnan, Weinberger. 《Retriever-Free Retrieval: Navigating Documents with Decision Models》. arXiv 2610.35868, 2026. arXiv 页面 / PDF 。
- 同一条线上的工作,Jev 1.13(typesafe/jev-1.13 )、DAPR(Wang et al., ACL 2024)、RAPTOR(Sarthi et al., ICLR 2024)、LATTICE(Gupta et al., TMLR 2026)、PageIndex(VectifyAI )、RankGPT(Sun et al., EMNLP 2023)、Qwen3-Embedding 与 Qwen3-Reranker(Zhang et al., 2025)。
- 本站写过 JevAct 给 LLM Agent 加的决策门 。同一族决策模型,这次的位置在执行前。
配套视频,中文版与英文版各一支,逐节讲这套问路的走法,以及它在哪一层丢分。