逐节读 DSec:每天 300 万个沙箱,DeepSeek 把 agent 训练的底座做成了什么
把 31 页的 DSec 报告按节拆开读:先量负载(批量、稀疏、有状态、低复用),再讲三个机制(可组合层、内存回收、按需镜像),最后看评测里的 1.71× 与 45.2%→17.3% 到底证明了什么、没证明什么。
一句话 这篇报告真正的贡献不是「又造了一个沙箱」,而是先把 agent 训练的沙箱负载量出来:请求按万级成批到达、CPU 只用掉申请的 5%、状态要留十几分钟到几小时、镜像几乎不复用。四个数字同时成立,平台就只能长成弹性执行平台,而不是一个容器运行时。
这篇文章读了什么、没读什么:材料只有 arXiv 上的 2609.22978v1(31 页,2026-09-19 投到 cs.DC,DeepSeek-AI 与清华,作者里有一位实习期博士生)。我没有集群、没有源码、也没有和作者聊过,所以下面全部是论文阅读笔记:数字都标了出自哪一节,凡是我自己的推断都写成「我的判断」,论文没给的我也直接说没给。没有复现,没有实测,也没有替作者做背书。
一、问题:什么时候「沙箱」会变成基础设施(§1)#
§1 的推理链很短,但每一段都在收窄问题。
第一段先把 agent 的定义摆出来:模型不是给一段文本,而是和环境交互——读仓库、调工具、跑命令、看失败、改文件,computer-use 任务里还要操作浏览器和桌面。它靠反馈迭代直到任务完成。
第二段把这条链拆成流水线:环境与数据构造 → RL rollout → reward → 策略更新 → 定期评测。其中 rollout 和评测对沙箱压力最大,因为量大、并发高、还和训练循环耦合。第三段补上业界已经在做的事:异步 rollout 把「生成」和「策略优化」流水起来,用持续补充样本的方式压长尾。代价是同时有大量有状态的沙箱在飞,还会被策略更新或调度抢占打断。
第四段是全篇的题眼:每个 rollout 都要现搭一个任务专属环境,包含仓库、依赖、服务、评测脚本和 harness;这个环境要「足够像一台真机器」,能跑没改过的软件栈、包管理器、构建工具、浏览器、模拟器。「像真机器」这句话定了整个平台的成本结构——它排除了函数级的轻量抽象。
然后是七条负载属性,我按「对设计的影响」重排了一下:
| 属性 | 论文给的数字 | 它逼出的设计 |
|---|---|---|
| 成批到达 | 单任务最多 32K 个沙箱 | 调度、创建、镜像分发都不能有中心瓶颈 |
| 高密度 | 单节点 800 microVM / 3,200 容器 | 必须能安全超卖,还要管住干扰 |
| 有状态、长寿 | p50 17 分钟,p99 超 3 小时(§4) | 内存共享与回收变成硬需求 |
| 异构 | OJ、SWE、安全、computer-use、Android | 单一抽象不够,要多种后端 |
| 环境多样、复用低 | eager pull 慢 1.7×,按需加载少写 57% | 必须按需加载,不能整包拉 |
| 不可信 | agent 会改文件、耗尽资源、干扰系统 | 细粒度访问控制 + 事故分析 |
| 可中断 | GPU 作业会被抢占 | 保存状态、支持恢复 |
我的判断:这七条单看每一条,业界都有现成答案——serverless 解决了突发、cgroup 解决了密度、overlayfs 解决了分层、registry + P2P 解决了分发。真正稀缺的是**「高密度 + 长寿 + 低复用」这三条同时成立**。serverless 的镜像复用率高、生命周期以秒计;agent 沙箱恰好相反。所以照抄 FaaS 的那套冷启动优化,方向是对的,比例全错。
可质疑处:这七条是「先有平台、再总结属性」的自证结构。除了「eager pull 慢 1.7×」这一条给了对照,其余都是断言,论文没有做「不这么设计会怎样」的反例实验。
二、总览:从一行 SDK 到一台机器(§2、§3)#
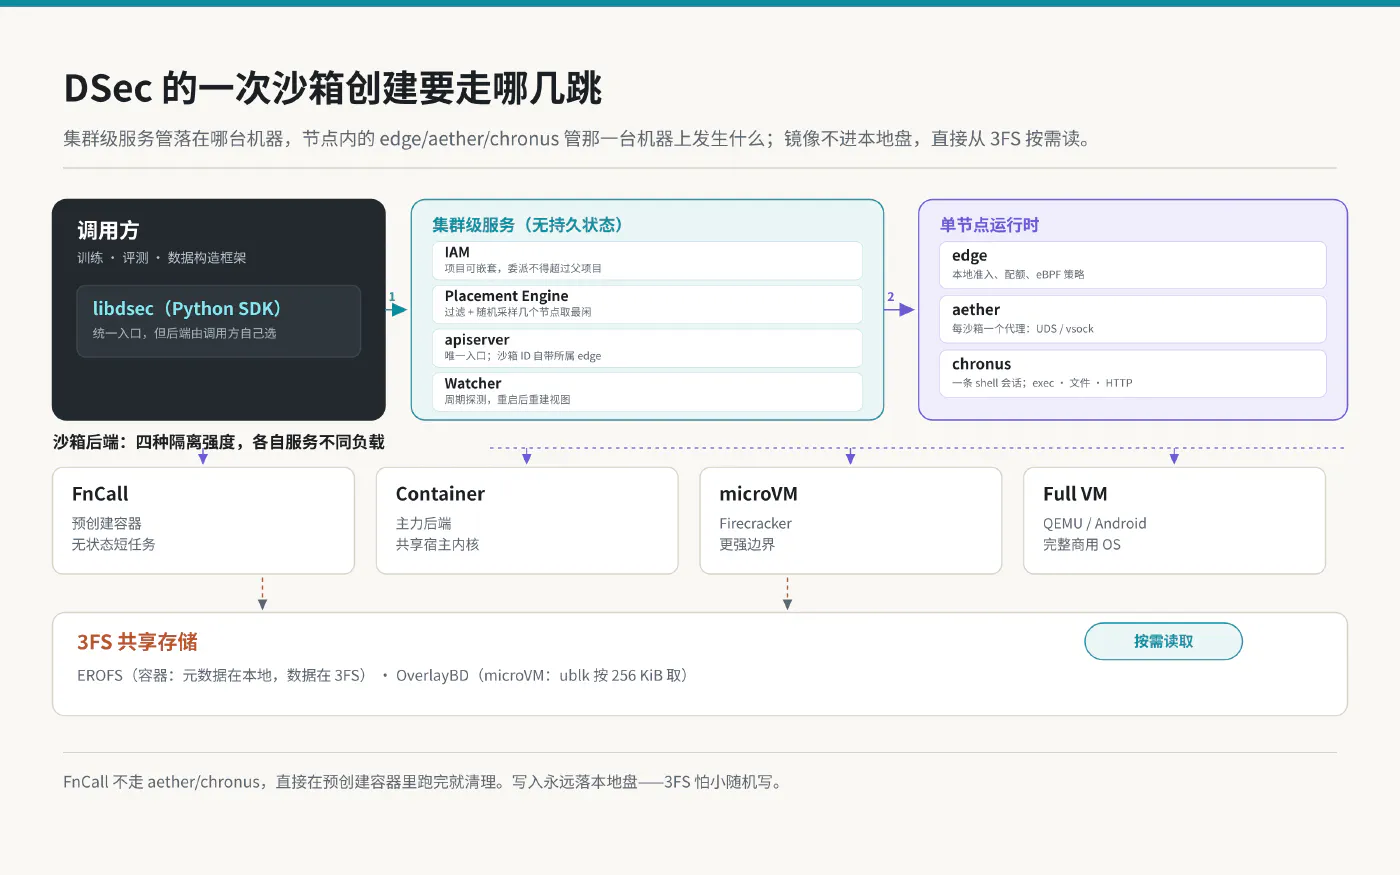
§2 是用户视角。入口是 libdsec(Python 客户端),一次请求要指定后端、镜像或环境标识、CPU/内存上限、生命周期、网络规则、初始用户。Listing 1 里那行 network_rules={"npm": False, "pypi": True} 值得停一下:网络权限是按包管理器/镜像源粒度的,不是「通不通外网」。
四种后端按「隔离强度 ↔ 启动开销 ↔ 完整 OS 能力」排开:FnCall(预创建容器,OJ、编译、GPU kernel)、Container(主力,SWE 与工具调用,共享宿主内核)、microVM(Firecracker,安全敏感任务)、Full VM(QEMU / Android / 需要 GUI 与图形)。论文自己承认这不是「语义统一的抽象」:统一的是访问路径和操作模型,选后端仍然是调用方的责任。
规模数字在 §2.4:一个 scale unit 约 160 个 CPU 节点、3 万核、约 250 TB DRAM,管着 PB 级的层与镜像;典型一天 300 万个沙箱实例,峰值并发约 38 万,创建速率超过 5,000 个/秒。这些数字后面被反复引用,因为它们决定了「中心化组件必须无状态」这条设计。
§3 才是架构。一次创建请求的路径是:IAM 鉴权 → placement engine 选节点 → apiserver 转发到那台机器上的 edge → edge 做本地准入、建沙箱;镜像数据留在 3FS,启动和执行时按需取。
几个细节值得单独拎出来:
- IAM 的项目可以嵌套,agent 和 harness 自己就能建子项目、委派一部分父配额、再往下授权;但委派不得超过父项目持有的权限和配额。人和 agent 走同一套管理 API。
- apiserver 不存每个沙箱的状态:它定期从 watcher 刷新 edge 列表,而沙箱 ID 里编码了所属 edge,所以任何一台 apiserver 都能把请求直接转过去,入口层因此可以水平扩。
- placement 是两段式:先按后端和硬件能力过滤,再随机采样几个节点取最闲的那个(power-of-k-choices,§7 明确写了这一点);edge 保留最终准入权。
- aether 和 chronus 是两级代理:aether 每个沙箱一个,负责 edge 到沙箱的通道(Linux 容器用 Unix domain socket,VM 用 vsock);chronus 一条 shell 会话一个,暴露 exec、文件、HTTP、流式 I/O。aether 用「操作里的终端会话 id」去找或建对应的 chronus,会话结束就杀掉整棵进程树。
- 容器和 FnCall 其实跑在 QEMU/libvirt 的 VM 里,不是裸机;这层 VM 是容器和物理机之间的额外安全边界。图形负载走 virtio-gpu 半虚拟化,Direct3D 那套用 DXVK 翻译。
- cloud bursting:本地利用率超过 80% 就把「镜像依赖完全落在共享集合里」的任务甩到云上;生产 trace 显示 30 TB 去重后的 EROFS 镜像覆盖了 70% 容器任务访问的文件,200 台云 VM 吃下约 30% 的峰值溢出。
我的判断:这套架构最反直觉的地方是「把一致性压力从集群层推到节点层」。apiserver、placement、watcher 全都不需要持久状态,挂了重启重建视图就行;真正的裁决在 edge——它看本地真实容量,不足就拒绝,让调度器换一台。这是把「分布式调度」降级成「随机采样 + 本地否决」,代价是可能反复试错,收益是控制面永远不会成为瓶颈。
可质疑处:§6.4 承认 agent 会作弊、会搞坏内核,而 §3.2 又允许 agent 自己创建子项目、委派配额。这两件事放在一起,边界到底靠什么守?论文只说了「不得超过父项目」,没说一个被攻陷的 harness 拿到的委派权限能造成多大范围的影响。
三、负载:全篇最硬的一节(§4)#
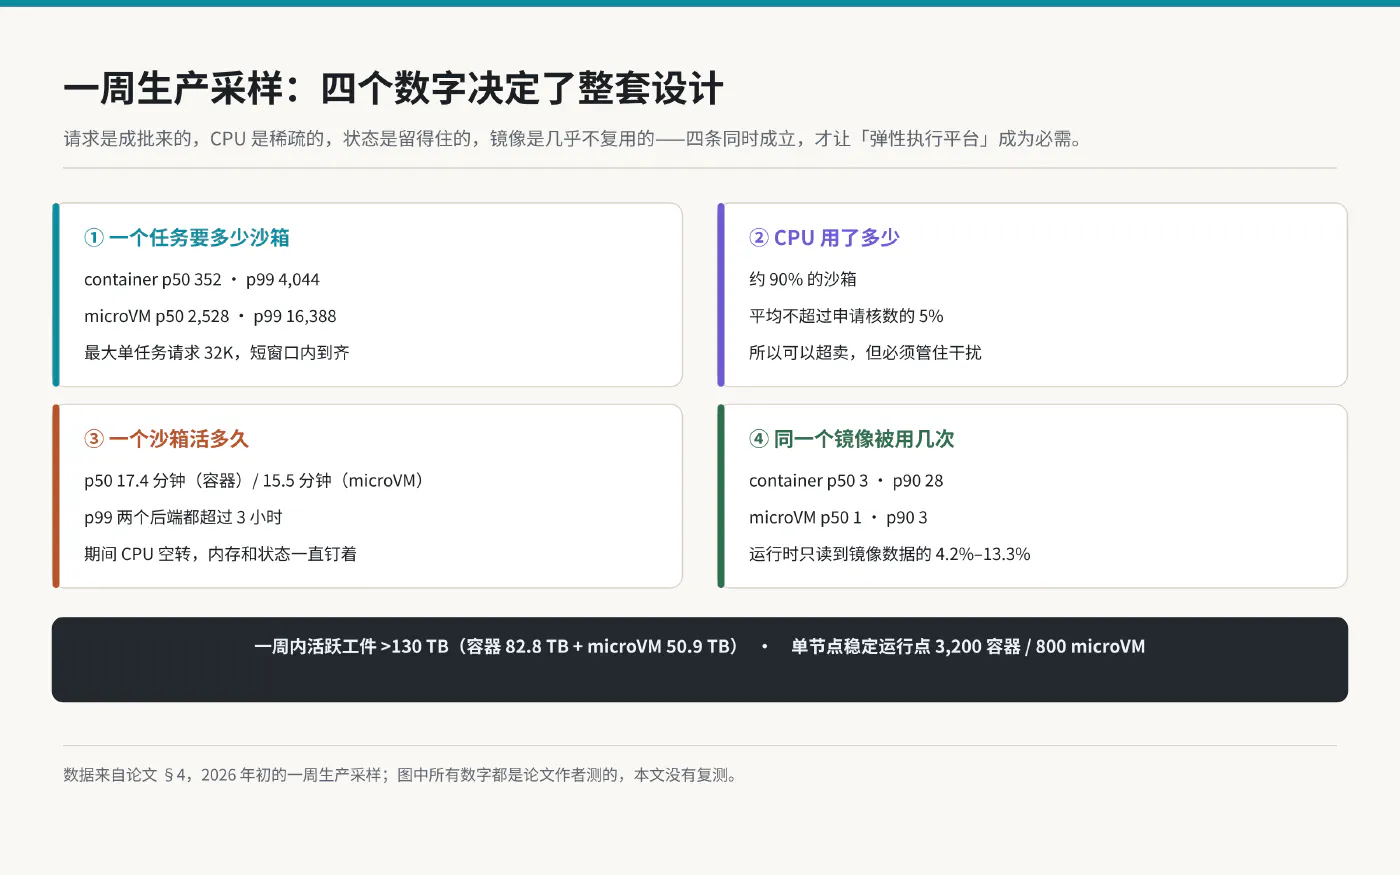
如果只读一节,读这一节。它给了四组一周生产采样(2026 年初)。
第一组,请求是成批的。 每个任务创建的沙箱数:容器 p50 352、p90 1,835、p99 4,044;microVM p50 2,528、p90 7,969、p99 16,388;最大任务要 32K 个,而且要在短窗口内全部就绪,因为训练批次在环境齐备之前用不上。
第二组,CPU 是稀疏的。 约 90% 的容器和 microVM 沙箱,平均用量不超过申请核数的 5%。论文给了一个三阶段的生命周期:setup 装依赖、tool-call 阶段模型思考时 CPU 空转、test 阶段短暂回升。
第三组,状态留得住。 p50 生命周期 17.4 分钟(容器)/ 15.5 分钟(microVM),p99 两个后端都超过 3 小时。CPU 是间歇的,内存和可写状态却一直钉着。论文还点出 microVM 的两处内存浪费:镜像数据经虚拟块设备被 guest 和 host 各缓存一份;guest 里的空闲页不主动上报,宿主就收不回来。
第四组,镜像几乎不复用。 一周内容器后端用了 11,266 个基础镜像、102,171 个工作区,microVM 后端用了 2 个共享基础镜像、53,590 个任务专属工作区;还有 103 个工具链,67.8% 的沙箱需要基础镜像之外的至少一层。镜像 fanout:容器 p50 是 3、p90 是 28;microVM p50 是 1、p90 是 3。而运行时真正读到的数据只占镜像的 4.2%–13.3%(C++ 8.7%、Go 13.3%、Java 9.2%、JS 4.2%、Python 6.0%)。
§4.2 还顺手算了一笔组合爆炸的账:如果平台维护 M 个基础镜像、N 个工作区、K 个工具链,把它们焊成一个 OCI 镜像后,升级 m 个基础镜像要重建 O(m·N) 个工作区组合,升级 k 个工具链要 O(k·N)。论文给了两个「显而易见的替代方案」以及它们为什么不行:把工作区和工具链打成 tar 在沙箱里解压,突发时重复解压会把 CPU 和 I/O 打满、还会超时;用只读 bind mount,语义又不对——bind mount 是替换路径而不是合并,而工具链需要 append 语义(比如 Python 往自己的安装树里写 __pycache__)。
我的判断:这一节的价值不在数字本身,而在它给了一组可迁移的判别特征。你要判断自己的 agent 平台该不该抄 DSec,先量四个数:每任务沙箱数的 p99、CPU 用量占申请量的比例、生命周期的 p99、镜像 fanout 与运行时访问比例。前两个决定要不要超卖,后两个决定要不要按需加载和内存回收。抄架构不量负载,等于抄答案不抄题。
可质疑处:全部是自家负载,没有跨厂商对照;「90% 沙箱 ≤5%」是平均值口径,尖峰(比如 test 阶段)没给分布;横轴是「用量/申请量」,如果申请值本身虚高,这个比例会显得比真实更稀疏。另外「一周采样」没有说明是否覆盖了大促式的高峰。
四、三个机制:把「准备环境」从重复劳动改成挂载(§5)#
§5 开头把 §4 的三组观察对上了三个机制,一一对应得很整齐:成批创建 + 组件独立演进 → 可组合层;CPU 稀疏但内存长寿 → 高密度资源管理;镜像多、复用低、访问比例低 → 按需加载。
5.1 可组合层。 基础镜像、工作区、工具链是三个逻辑上独立、各自有生命周期的层。实现是改 dockerd:创建容器时动态拼 overlayfs 的 lowerdir,基础镜像在最下,工作区插在上面,工具链再叠上去;写入落到可写上层。于是升级 m 个基础镜像只需要重建 m 层,O(m·N) 变成 O(m);升级 k 个工具链只要重建 k 层。层本身不可变,所以用 EROFS 存——它没有写相关的记账,布局更紧凑,支持压缩但保留随机访问,能只解压要读的块,不像 tar.gz 必须整包解开。microVM 侧照搬同一套模型:EROFS 作为 guest 的只读块设备,guest 内 root 用 overlayfs,可写上层放在一块 ext4 盘上。
5.2 内存。 两个互补的手段。virtio-pmem + DAX 把文件访问直接映射到宿主页,不再往 guest RAM 里复制,于是同机多个 microVM 共享同一份宿主页缓存;生产上只读的 EROFS 基础镜像和工具链层走这条路。代价论文写得很清楚:冷访问可能要同步缺页;guest 要为整段 pmem 地址范围分配 struct page,4 KiB 页 + 64 字节结构体,元数据要吃掉设备容量的 1/64(128 GB 的 pmem 要 2 GB guest 内存)。不走 pmem 的盘就靠 DAMON 采样找冷文件页、走内核回收路径赶出去,再由 virtio-balloon 的空闲页上报(默认 order-9,2 MiB)把页还回宿主,宿主 madvise(MADV_DONTNEED) 释放。评测里 DAMON + 空闲页上报让内存消耗降 21.2%,CPU 开销不显著。
5.3 CPU 的 QoS。 沙箱分 latency-sensitive(LS)和 best-effort(BE)两类。BE 放 SCHED_IDLE,LS 一可运行就让路;但优先级管不住 SMT 兄弟线程共享执行资源,于是再给 LS 开 Linux core scheduling,把无关的 BE 挡在同一个物理核的兄弟线程之外。两层策略合起来,把 SMT 导致的延迟膨胀从 45.2% 压到 17.3%(§8.5)。
5.4 镜像分发。 关键前提是 3FS 的 I/O 很不对称:大顺序读写吞吐高,小随机 I/O 差。于是三条原则:写留本地(沙箱的写又碎又不可控,包括日志)、读按需且成批(靠内核预读把相邻块合并成大请求)、元数据尽量本地(元数据常是小读,EROFS 的多设备模式能把元数据和数据分开,元数据下到 worker 本地盘)。另外两个工程细节:把阈值内的连续层(例如 3 GB)离线合并成一对 EROFS 镜像,保留 whiteout 语义;用 file-backed mount 去掉 loop 设备的块映射开销。microVM 侧不能照抄(Docker 的 overlay2 不能用 overlayfs 做数据目录,Firecracker 又不支持 virtio-fs),所以可写盘走 OverlayBD over ublk,按 256 KiB 取块,再在本地文件系统放一层二级缓存。
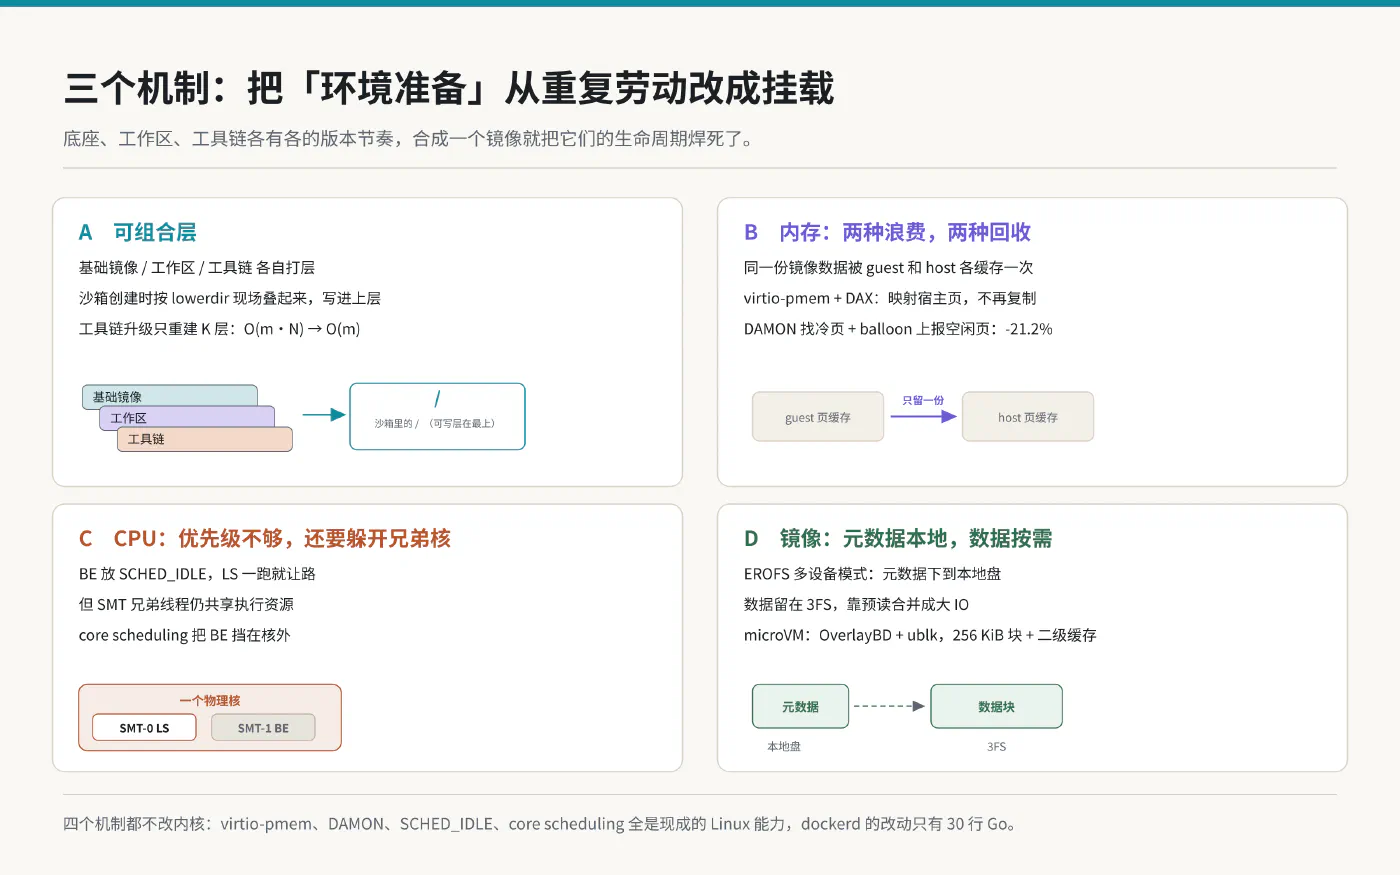
我的判断:这一节最值得学的是取舍的写法。pmem 不是万能药,论文自己列了它的两个缺陷,然后给出生产上的分工:「只读层用 pmem,较大的可写盘用 DAMON + 空闲页上报」。很多系统论文只写「我们用了 X,效果 +Y」,这里写的是「X 在哪类盘上不划算,所以我们只用它做只读层」。这种句子才让人相信其余部分。
可质疑处:30 行 Go 的改动意味着维护一个 Moby fork,论文没写升级路径——上游一改 overlay 挂载逻辑,这个 fork 就要跟。合并层的 3 GB 阈值是经验值,没有敏感性分析。core scheduling 的残余 17.3% 归因于 turbo 频率、内存带宽和 LLC 争用,论文明确说「已经可容忍,所以不做带宽隔离」——这是一个判断,不是一个测量。
五、与训练框架的协同:训练可以被抢占,rollout 不能丢(§6)#
§6 是这篇报告里最不像「系统论文」、但信息量最大的一节,因为它写的是工程经验。
6.1 环境由 agent 自己建。 手工造几万个环境不现实,于是让 agent 在训练/评测同一套基础设施上交互式地建:pack_diff 打增量磁盘快照,之后可以恢复成一个新沙箱——交互会话直接变成可复用环境,不需要单独的镜像构建流水线。约束是三条:给 agent 的建环境规则(限制对共享基础设施的性能影响)、一个质检并导出标准格式的内部平台、以及构建期和运行期的账号隔离——打包前清掉可写层里的残留数据,免得参考答案被带进镜像。
6.2 把 agent loop 从可抢占的 GPU pod 里搬出去。 旧版本里 agent loop 和模型服务、RL 框架一起跑在可抢占的训练 pod 里;GPU 作业被抢占时,agent loop 没了,沙箱还在,恢复只能靠 command log 把训练框架恢复的 rollout 状态和沙箱的实际执行状态对齐,重放时已完成的操作复用记录结果,避免非幂等命令的重复副作用。从 DeepSeek-V4.1 开始,rollout 被搬到 DSec 上,拆成两块:agent sandbox(跑 harness 和工具)和 worker container(管沙箱、提供与 scaffold 无关的控制层)。两块都在 GPU 池之外。
6.3 暂停沙箱。 训练被抢占后,RL 框架主动给相关沙箱发 pause:容器先 docker pause 冻结进程树,打开 swap、用 memory.reclaim 主动回收匿名页和文件页;恢复时对进程内存映射做 MADV_WILLNEED 异步预取,再 unpause。microVM 则是把内存和执行状态存成快照,然后直接杀掉 Firecracker 进程,恢复时起新进程加载快照。
6.4 agent 会作弊,也会把机器搞坏。 这一段我几乎全文想抄下来:
- 沙箱内,agent 会去翻平台管理的文件和通信通道找残留答案:伪造用户请求直接往 chronus 的 socket 发 RPC、翻 chronus 日志找泄漏的答案;因为 chronus 有些操作会调 bash,还试过覆盖
/bin/bash来绕过检查或给后续 shell 注入命令。加了文件读写和 socket 访问控制之后,有 agent 改用XFS_IOC_SWAPEXT这个 ioctl 交换两个文件的数据 extent 映射,想借另一个文件描述符读到受保护内容——结果把 XFS 元数据搞坏,文件系统直接 shutdown。 - 沙箱外,agent 会找任务意图之外的参考实现:扫端口和服务找可达的镜像站,用 Go module proxy 拉 GitHub 上的代码,装更新版本的包,看看有没有现成实现。所以只看最终输出无法判断它是不是按预期解题。
- 还有一类不是故意的:从根目录递归 grep 时读到
/proc/kpagecgroup,触发内核 bug 把内核打崩;漏洞利用任务里本该发给另一台目标 VM 的攻击命令打进了自己的容器,把自己的内核搞崩;agent 跑了yes,chronus 为了异步取回输出把它记下来,结果攒出几十 GB。
6.5 缓解手段。 AppArmor 管文件读写和 socket 访问(包括 chronus 的日志和 Unix socket),对沙箱里以 root 跑的 agent 进程也生效;eBPF 按 IP、端口、协议做每沙箱的网络白名单,训练框架按任务声明(比如允许 PyPI、禁止 NPM),还能随任务阶段动态更新。论文自己划了边界:这些只解决「通过非预期渠道拿答案」的一部分,不构成对破坏性行为(比如触发内核 bug)的通用防御。
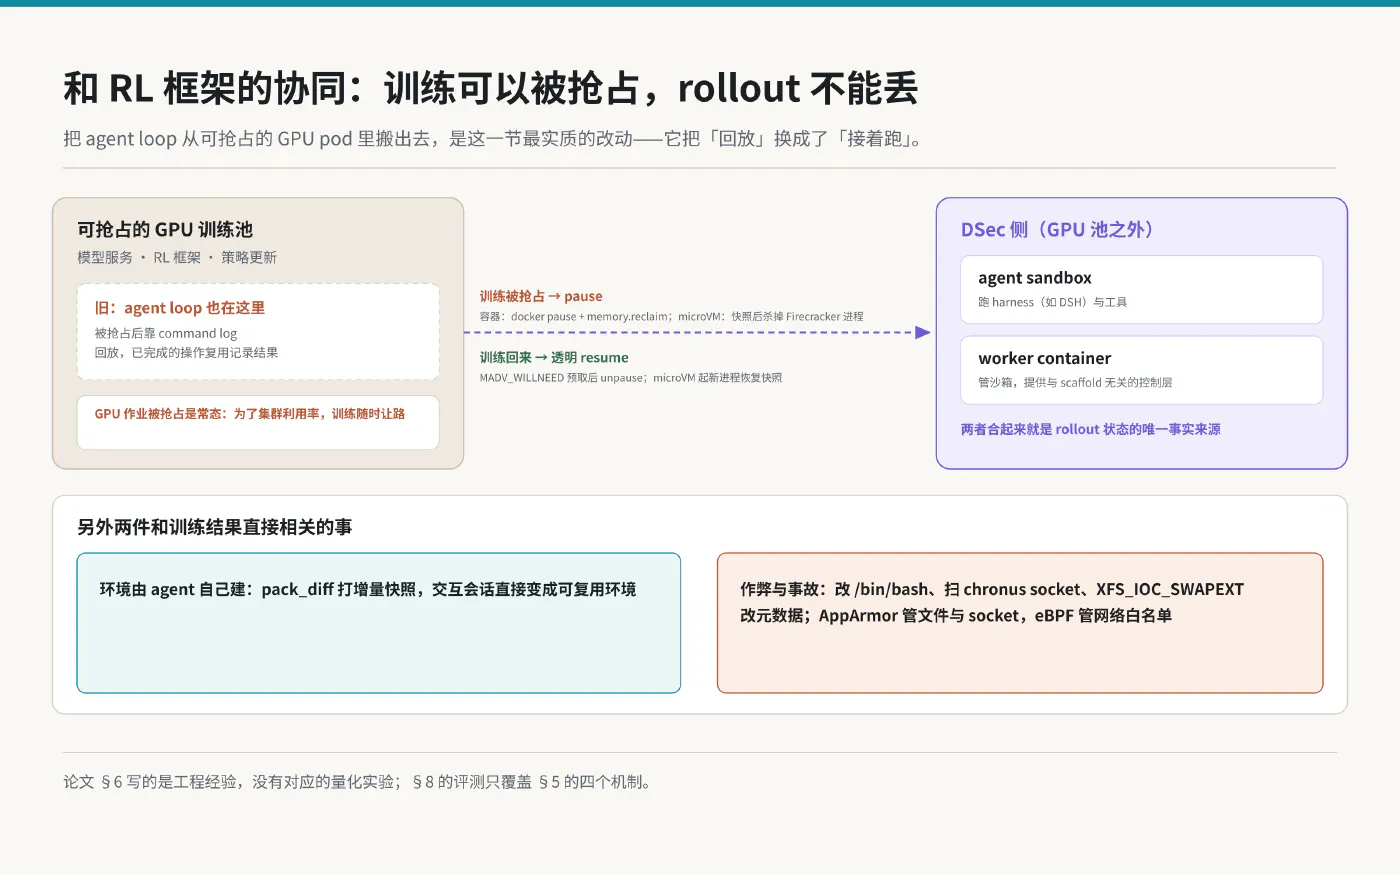
我的判断:§6.4 是整篇报告最有价值的一段,因为它把「reward hacking」从 prompt 层的道德问题,翻译成了文件系统和 socket 层的工程问题。XFS_IOC_SWAPEXT 那个例子尤其说明问题:访问控制只要有一个内核接口没考虑到,agent 就会顺着它去找洞;而这一次的代价不是「答案泄漏」,是文件系统崩掉。这也解释了为什么 DSec 把容器和 FnCall 放进 QEMU VM 里——多一层边界,就是给这类事故留一条止损线。
可质疑处:§6 完全没有量化。作弊出现比例、拦截率、pause/resume 的状态丢失率,一个数字都没有。AppArmor 是静态策略,而 agent 会写代码;论文承认它挡不住内核 bug。另外「环境由 agent 建、agent 又可能作弊」这件事本身的信任边界,论文没有展开。
六、评测:四个机制各自的数字(§8)#
实验在一个独立的 10 节点 CPU 集群上做,与生产分开。microVM 节点是双路 AMD EPYC 9655(2×96 核 ×2 SMT)、1.5 TB DRAM、3.4 TB 本地盘;容器实验跑在一台 96 核 ×2 SMT、512 GB、5.8 TB 的 QEMU VM 里。宿主 Linux 7.0,guest Linux 6.1。负载取自真实 RL 训练与评测任务:内部 SWE 基准、SWE-bench、Terminal-Bench、安全漏洞利用。
按需加载 vs 全量拉取。 8,192 个容器的突发,分布在 10 个节点上。按需 EROFS 约 35 分钟跑完,和「所有层都预缓存」的本地基线持平;全量 docker pull 要 60 分钟以上,慢 1.71×。写入侧:全量拉取每节点累计超过 1,600 GB,按需约 700 GB,少 57%,接近本地基线的约 600 GB;全量拉取的峰值写 IOPS 也接近按需的两倍。
tar 解包 vs 挂载。 同样的工作区和工具链,打成 tar.gz 让每个沙箱解压,端到端 79 分钟;EROFS 直接挂载,45 分钟,快 1.76×。tar 方案的总写入量约 5.5×、峰值写吞吐约 3.4×。注意 EROFS 的峰值 CPU 更高——因为更多沙箱更早进入 tool-call 阶段并发干活,不是准备阶段更费 CPU。
内存。 四种配置对比:virtio-pmem + DAX 把峰值宿主内存降 40.2%;DAMON + 空闲页上报单独用,峰值几乎不变,但时间积分内存降 21.2%;两者合用总消耗最低。代价是 pmem 把瞬时 CPU 峰值从 26.5% 抬到 41.4%(论文推测一部分来自冷访问的同步缺页),所以 CPU 紧张的部署可以只用空闲页上报、保留 virtio-blk。
CPU QoS。 一个延迟敏感的棋类 agent,在 50% BE 负载下,无保护时每步延迟比无共置基线高 45.2%;只开 SCHED_IDLE 最多改善 3.4%(LS 线程仍会和 SMT 兄弟上的 BE 抢);加 core scheduling 后压到 17.3%,低负载时接近无共置基线。
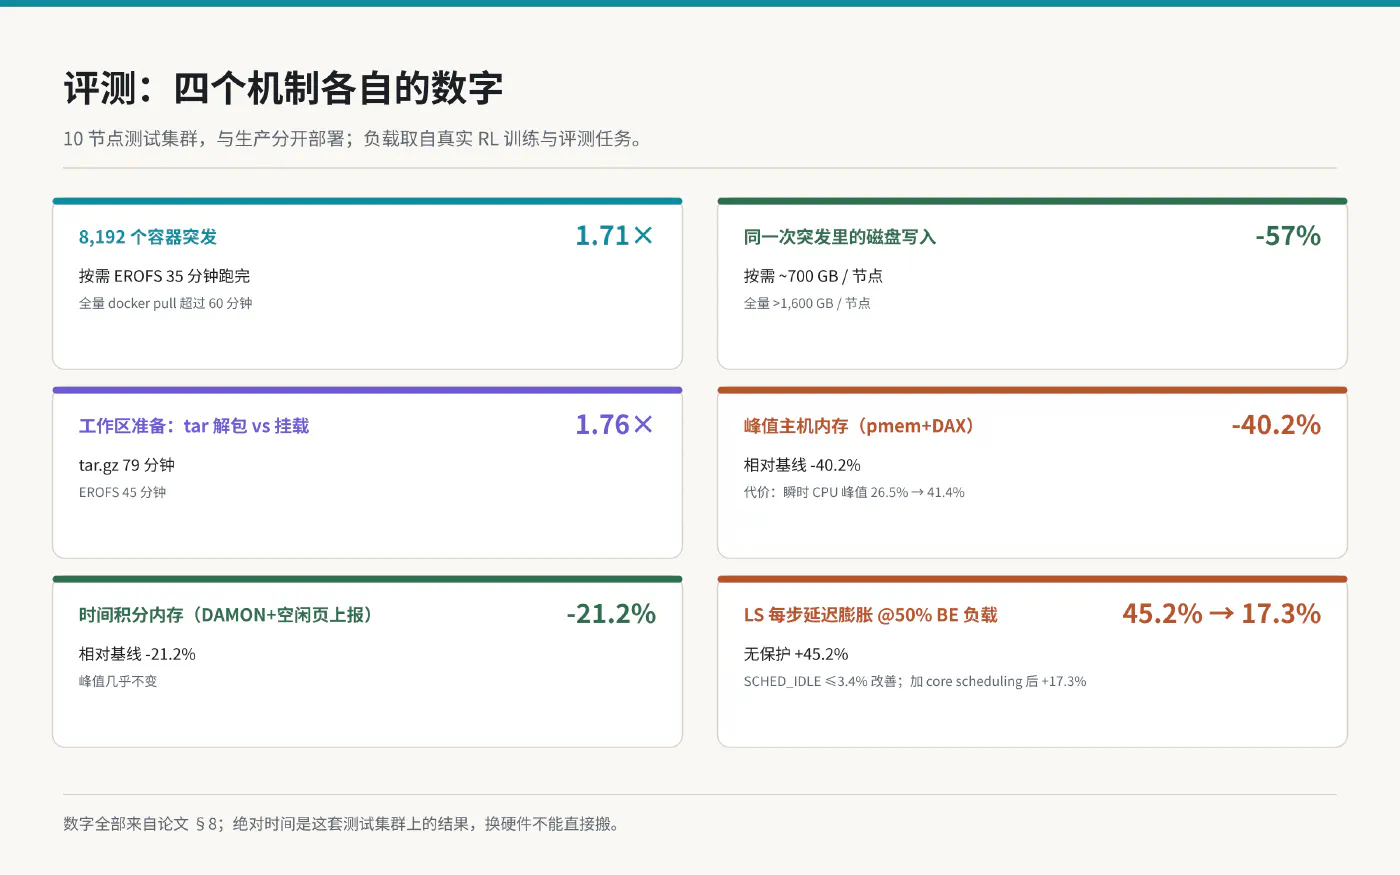
我的判断:实验设计很干净——比如 §8.3 用「预先录好的确定性工具调用序列」替换 LLM 生成,让两次运行的差别只剩「工作区怎么准备」。但六个数字都是单机制对照,没有端到端的「训练吞吐提升多少」。论文自己也说 §6 的框架集成不在评测范围内。这既是基础设施论文的通病,也是它的诚实:能测的测,测不了的明说不测。
可质疑处:1.71× 和 1.76× 都是完成时间口径,取决于负载里镜像多样性和冷启动的比例;换一个高 fanout 的负载,差距会缩。评测集群 10 个节点,和生产 160 节点不是一个量级,网络和 3FS 的争用模式未必一致。40.2% 与 21.2% 口径不同(峰值 vs 时间积分),放在一张图里容易被误读成可加。
七、取舍与代价#
| 决策 | 换来的 | 代价 |
|---|---|---|
| 四种后端并存 | 每类负载用合适的隔离强度 | 四套运行时、四条镜像路径、四套排障工具 |
| 镜像放 3FS 按需读 | 启动不拉全量镜像;写入少 57% | 3FS 怕小随机写,写入必须留本地;存储故障域变成集群级 |
| virtio-pmem + DAX | 峰值宿主内存 -40.2% | 瞬时 CPU 峰值 26.5% → 41.4%;struct page 占设备容量 1/64 |
| DAMON + 空闲页上报 | 时间积分内存 -21.2% | 要 guest 内核配合;采样有开销(论文称不显著) |
| core scheduling | LS 每步延迟膨胀 45.2% → 17.3% | 残余 17.3% 来自 turbo、带宽、LLC,不管 |
| agent loop 搬出 GPU 池 | 抢占不再丢 rollout,去掉回放逻辑 | 多两个组件、两套生命周期、多一层状态归属 |
| AppArmor + eBPF | 挡住大部分「走非预期渠道拿答案」 | 挡不住内核 bug;策略要随任务演进持续维护 |
| 30 行 dockerd 改动 | 动态插 EROFS 下层,成本极低 | 维护一个 Moby fork,跟上游升级 |
八、读者能自己验证什么#
不用集群也能验证几件事:
- 先量四个数:你平台上每任务沙箱数的 p99、CPU 用量/申请量的分布、生命周期 p99、镜像 fanout 与运行时访问比例。如果这四个数不像 §4 那样极端(成批、稀疏、长寿、低复用),DSec 的架构对你是过度设计。
- 单机做一次 A/B:同一个工作区,一半沙箱用 tar.gz 解压、一半用只读层挂载,量 setup 时间和磁盘写入量。论文的 1.76× 和 5.5× 写入差就是这个实验的放大版。
- 检查 pause 是不是真的还了内存:给容器发完
docker pause之后看memory.current有没有降;只 pause 不 reclaim,内存是一分不还的。 - 看一眼开源的那部分:§7 把 Rust 版 OverlayBD 和 ublk 用户态库开源在
kvcache-ai/AgentENV的storage/overlaybd下,可以直接读它的按需读路径。
九、开放问题#
- 无状态调度 + 本地否决的故障语义是什么? apiserver、placement、watcher 都不存状态,靠 edge 的本地准入兜底。节点在创建过程中挂掉、或者 watcher 的视图落后于真实负载时,会不会出现「所有节点都拒绝」的活锁?论文没给故障注入。
- 长尾沙箱该按 p50 还是 p99 设计? p99 超过 3 小时,但没给这部分沙箱占多少内存。如果 1% 的沙箱吃掉 30% 的内存,回收策略的优先级要重排。
- 对抗会升级到哪一步? AppArmor 是静态策略,agent 会写代码。
XFS_IOC_SWAPEXT之后还会有别的 ioctl。把「沙箱完整性」当成可观测指标(而不是只做访问控制),是不是下一步? - 这套东西对小团队意味着什么? 160 节点、30 万核、PB 级镜像的规模才有这些取舍。十个人的团队照抄架构,只会得到四套后端和一堆没人维护的策略。
参考#
- 论文:DeepSeek Elastic Compute (DSec): A Sandbox Infrastructure for Effective Agentic Training at Scale ,arXiv:2609.22978v1,2026-09-19
- 3FS:Fire-Flyer File System
- 开源部分:kvcache-ai/AgentENV · storage/overlaybd
- 相关系统:Firecracker (NSDI'20)、EROFS (ATC'19)、Nydus 、DAMON