评测(Evals):一个 AI 系统能不能用,看四个数字
把 evals 拆成输入、系统、判官、数字四件事,再给判官本身打一次分。文中每个数字都标了来源。
一个 eval 的钱主要花在读输出和标用例上,代码只占很小一块。这篇把它拆成四个部件,每个部件配一个可以自己复算的数字。
片子一分五十五秒,中文配音,字幕烧在画面里,也可以用播放器关掉。
一、两条规则放过的回答#
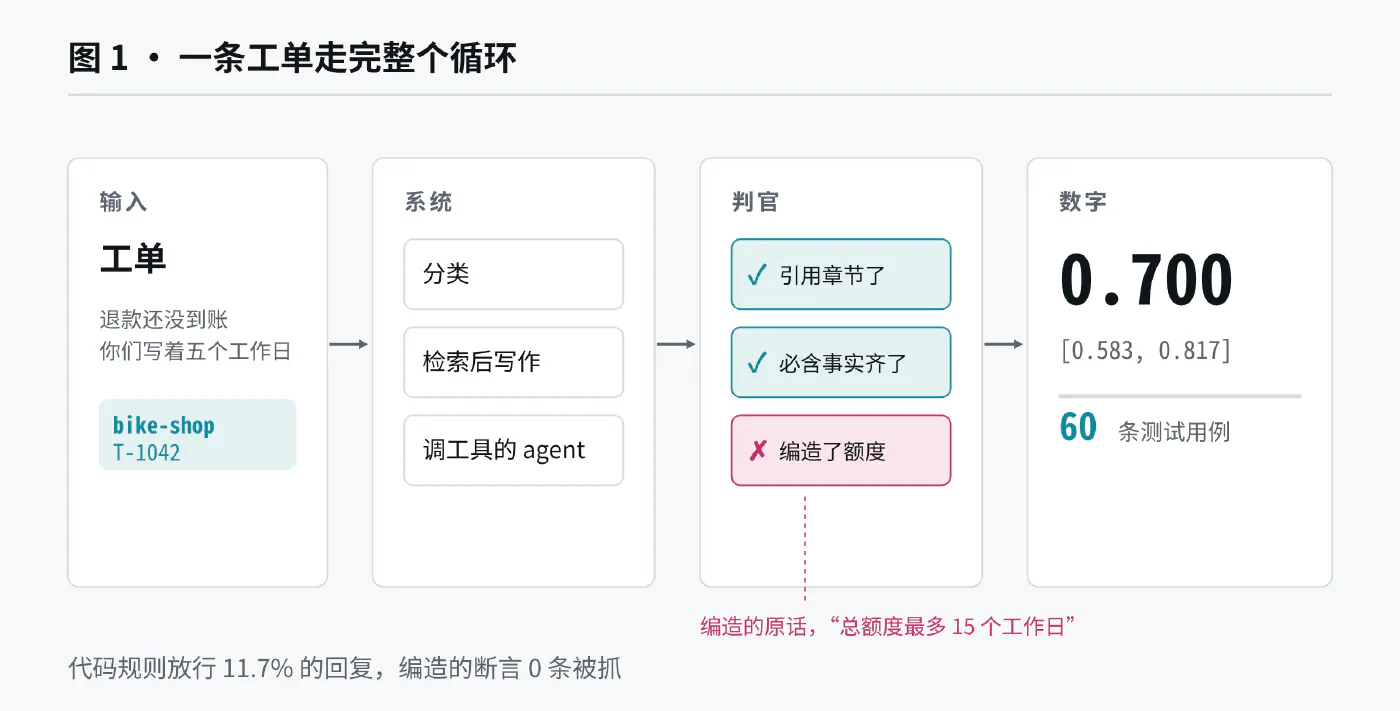
一家卖自行车和露营装备的网店,客服工单进到模型里。工单说,我上周退了车,退款还没到账,你们自己写着五个工作日。
系统的回复很客气,四段,引用了退换货那一节,两个必含事实也都在,五个工作日和二手商品 15% 的折旧费。两条代码规则同时放行,一条查有没有引用章节,一条查必含事实齐不齐。
模型判官判它失败。它多写了一句「总额度最多 15 个工作日」。
作者在 60 条测试用例上重跑了一遍,只有 11.7% 的回复能通过全部代码规则,而代码规则一条编造的断言都没抓到。这两个数字摆在一起,就是 eval 存在的理由。一段格式和引用都挑不出毛病的话,可以同时是错的,而错的那部分恰好是客户会当真照做的部分。
二、四个词,四条路#
| 概念 | 测什么 | 例子 | 常见误用 |
|---|---|---|---|
| eval | 你的系统在你的数据上 | 这个助手跑 60 条工单 | 拿它跟别人的模型比 |
| benchmark | 一个模型在一套公开题上 | GSM8K、SWE-bench | 拿它选产品路线 |
| test | 一个函数有没有返回预期值 | JSON 能解析、不崩 | 以为通过就是对的 |
| monitoring | 上线之后的真实流量 | 每天抽样评一批工单 | 只在出事的时候看 |
四件事的差别不在精度,在数据归属。benchmark 的题是别人出的,eval 的题得你自己攒,攒不出来就没有 eval。原文给了一个比喻,模型是引擎,eval 是你的车在你这条路上的表现。这个比喻站得住,因为它顺手解释了另一件事,引擎评测拿第一的模型,到你这里答错客户的问题,两件事并不矛盾。
三、先读输出,再写判官#
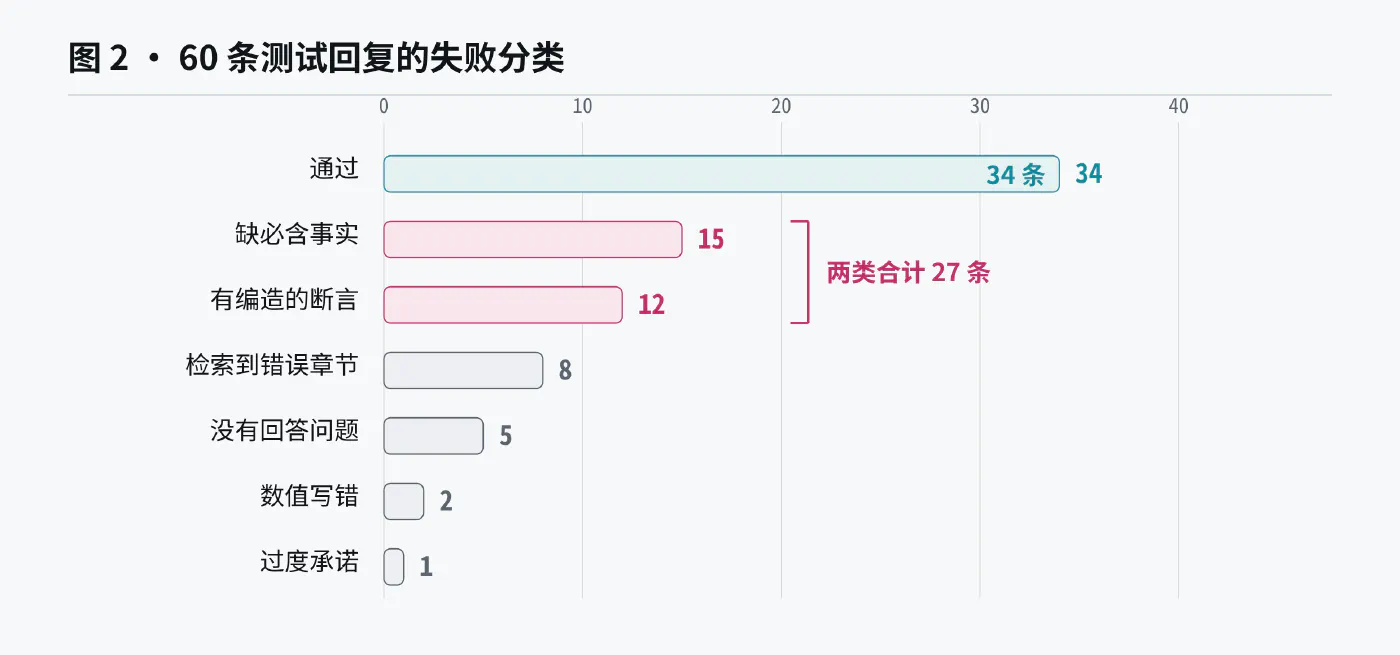
任何自动判官动手之前,先把输出读一遍。作者读的是 60 条测试回复,逐条记一句失败原因,再把笔记并成类别。这批数据的结果是这样。
| 结果 | 条数 |
|---|---|
| 通过 | 34 |
| 缺必含事实 | 15 |
| 有编造的断言 | 12 |
| 检索到错误章节 | 8 |
| 没有回答问题 | 5 |
| 数值写错 | 2 |
| 过度承诺 | 1 |
60 条里 34 条通过,勉强过半。最大的两个问题合计 27 条,从 demo 里完全看不出来,因为 demo 只看一条。这张表就是后面所有判官的需求文档,按频次从高到低建。给不发生的失败写判官,得到的是一个好看但没用的数字。
读的时候标准会变。原文引 Shankar 等人 2024 年的说法,叫 criteria drift。标到第 40 条发现前 20 条的标准太松,回头改一遍。两三轮属于正常,不算返工。
四、代码判官能做完的那一半#
有确定答案的部分交给规则,免费、即时、每次结果一样。
triage 是一个 12 选 1 的分类,看准确率。作者的数是 accuracy 0.700,macro F1 0.697。两个数接近,说明错得比较分散,没有集中在某一个类别上。
自由文本也有硬规则可以查。同一批回复里,非空 100% 通过,禁令词 92% 通过,150 词以内 17% 通过。最后这个数字说明产品话太多,不需要任何判官就能发现。
必含事实的检查也在这一层,把最高频的那类失败按零成本抓住。
相似度是另一种用法。embedding 相似度在这批回复上把好回复和坏回复分开的 AUC 是 0.709,0.5 等于抛硬币。它能告诉你版本之间变了,不能告诉你变得对不对。写错但用词相近的回复,相似度分很高。
| 判官 | 能回答 | 看不见 |
|---|---|---|
| 代码规则 | 格式、标签、必含事实、禁语 | 意思 |
| 相似度 | 有没有变化 | 对不对 |
| 专用检测器 | 这句话在原文里有没有依据 | 别的问题 |
| 生成式判官 | 任何能读出来的标准 | 偏差,需要校准 |
| 人工标注 | 真值 | 速度,成本 |
| 线上 A/B | 真实业务影响 | 慢,有用户风险 |
五、判官也要先被考#
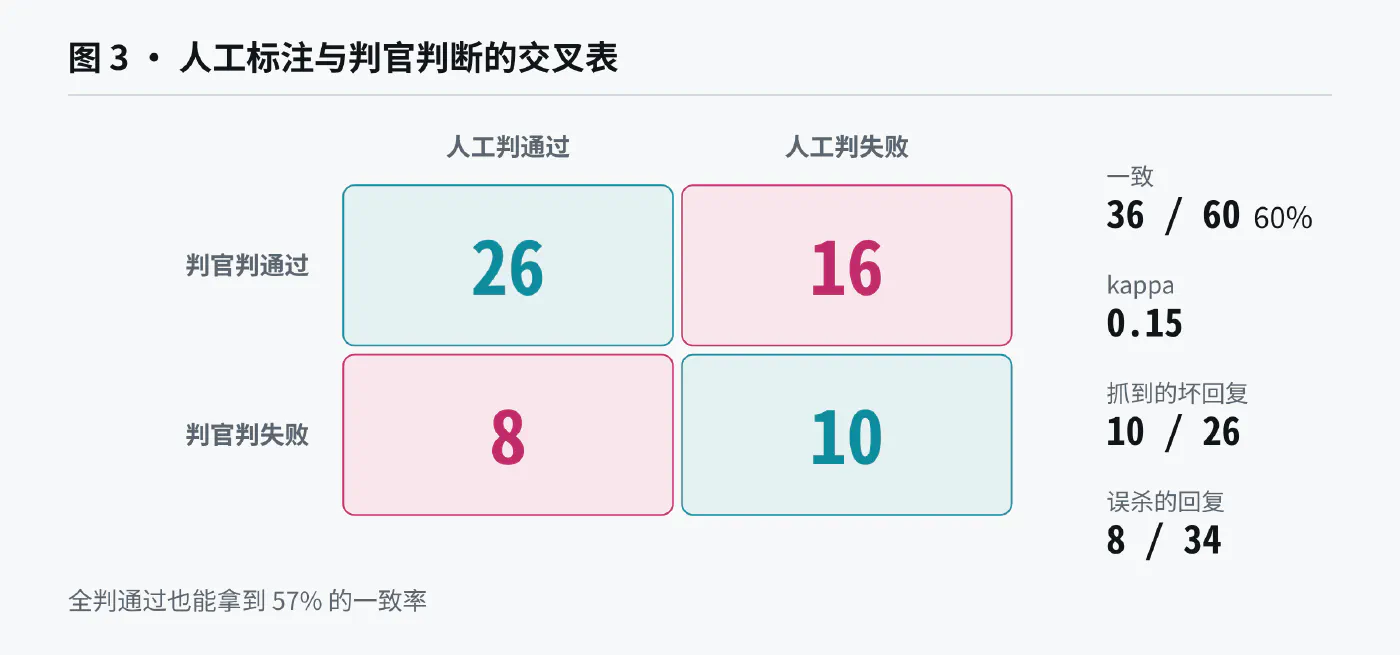
人工把 60 条全标一遍做参照,再让判官跑一遍。
| 人工判通过 | 人工判失败 | |
|---|---|---|
| 判官判通过 | 26 | 16 |
| 判官判失败 | 8 | 10 |
一致的 36 条,60%。判官说通过 42 条,人工说 34 条。26 条坏回复它抓到 10 条。kappa 0.15。
60% 听起来能接受,其实不行。判官闭着眼全判通过,也有 57% 的一致率,因为多数样本本来就通过。kappa 把这个底扣掉,0 是随机,1 是完全一致。卡发布一般要 0.6,无人值守要 0.8。0.15 的判官偏松,还漏过一半以上的坏回复。
kappa 会随通过率变化。同一份判官换到通过率五成的数据集上,kappa 会好看一些,判断能力一点没变。所以原文建议报 kappa,或者分开报抓到的坏样本和误杀的样本。两个都报最省事。
判官的偏差是有数的,补救也不贵。
| 偏差 | 表现 | 证据 | 补救 |
|---|---|---|---|
| 位置 | 成对比较里偏向先出现的那条 | 交换顺序后大量结论翻转 | 两个顺序都判,都赢才算赢 |
| 长度 | 越长越容易赢 | 长度校正后与人工排序的一致性从 0.94 提到 0.98 | 长度受控的评分,或用不奖励长度的二元问题 |
| 自偏好 | 偏爱自家模型的行文 | 同族判官把自己的 agent 抬高约 0.75 分,7 分制 | 判官换一个模型族 |
| 满意度不是成功 | 评的是对话舒不舒服 | 只看聊天的判官分不清能用的和坏掉的,AUC 0.49 | 把工具调用和最终状态也给它 |
| 判官身份 | 换判官就换赢家 | 2026 年两项审计 | 判官型号和版本跟结果一起记 |
满意度那一条值得多说一句。GAUGE 在 25 个 agent、约 3700 条对话上复现了大多数公司的发布流程,让模拟用户跟 agent 聊,让判官读记录打分,分高的上线。强弱分明的时候它排得很准,与可验证真值的相关系数 0.94。两组接近的时候,也就是真实发布真正要决定的那种情况,它在 31% 的情况下把更差的那个推了上去。判官看得到工具调用、鉴权和任务是否真的了结,AUC 从 0.49 升到 0.73,失败风险减半。决定可靠性的是判官拿到的证据,模型档位说了不算。
提问方式也有讲究。原文引 Cho 等人 2026 年的实验,把「给这份摘要打几分」换成一串是非题,比如「这条断言在原文里有依据吗」,在 SummEval 上与人判断的一致性从 0.514 提高到 0.563。他们还往摘要里塞了三个编造的事实,整体打分的判官给出 5.0 满分,是非题的判官给出 1.57。提示词里堆更多指令反而会让判官变差。
六、数字要带区间#
前面每个百分比都藏着一个问题,换 60 条工单,还会是这个数吗。
bootstrap 把 60 条结果重采样几千次,看分布。triage 准确率 0.700,95% 区间 0.583 到 0.817。诚实的写法是在 58% 到 82% 之间、最可能是 70%,只写一个 70% 会把区间一起省掉。
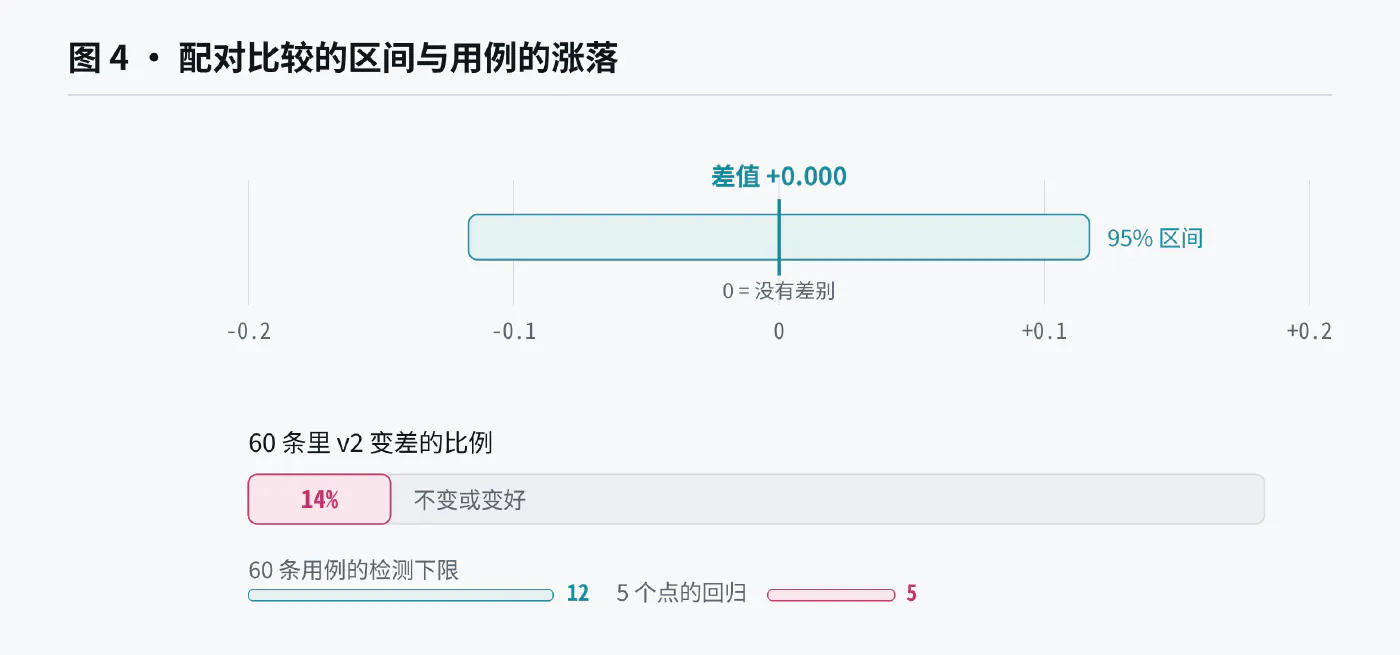
比较两版用配对。第二版回复多检索几节,同一批 60 条工单各跑一遍。
| 版本 | 判官通过率 |
|---|---|
| v1 | 0.700 |
| v2 | 0.700 |
| 差值 | +0.000,95% 区间 −0.117 到 +0.117 |
区间跨过 0,结论是没差别,留 v1。区间比单边那个窄,因为配对之后题目的难度抵掉了。McNemar 问的是逐条的问题,v2 是不是在 v1 输的地方赢。这批数据里两版是互换的,v2 在 14% 的用例上变差,在另外一些上变好。总分一样,一部分客户体验变好,另一部分变差,只报总分会把这个藏起来。
检测下限是可以算的。60 条用例能可靠看出的差异大约 12 个百分点,5 个点的回归在这个尺度上是隐形的。这条对写周报有用,低于下限就写测不出来,不要写略有提升。
一次测 20 个 prompt 变体再挑最好的,总有一个凭运气高 10 点。要么做多重比较校正,要么在另一批用例上复验。
七、有部件的系统,分开判#
客服助手其实有三块,分类、检索加写作、执行动作的 agent。三块失败的样子不同,修法也不同,所以要分开打分。
检索单独看。命中率 hit@2 是 0.93,召回 recall@2 是 0.88。18 条失败回复里,1 条是检索没找对,17 条是找到了材料却写坏了。这一行数字能省掉一周的工程量,因为团队多半会先去调检索。
写作部分用 RAGAS 那三项,不需要金标准答案。作者跑出来 context relevance 0.855,faithfulness 0.737,和手写判官的结论一致,都是检索还行、写作更差。两个来源的数字对上了,比单独一个可信。
agent 要改三个地方。第一,判最终状态也判路径,agent 有时用奇怪的路走到对的终点。第二,每个任务跑多次,pass@k 量能力,pass^k 量可靠,面向客户的要用后者,作者的 agent pass^3 是 0.75。第三,成本单独记,同一任务同一模型不同次之间能差 30 倍,准确率在中间成本处最高,在最高成本处反而下降。
可靠性还可以单独当一个维度。Rabanser 等人 2026 年从航空和核电借来 12 个指标,分四组,跨运行一致性、抗扰动、可预测性、危害有界。15 个前沿模型上,两年的能力提升只换来大约六分之一的可靠性提升。一个 agent 能干活,和它每次都把活干对,是两件事,客户体验的是后一件。
还有一条容易被忽略。判官一旦被用来训练或挑选系统,系统就会去找判官的盲区。Qwen 团队 2026 年的文章把这个叫 verification horizon,编码 agent 会去翻仓库历史找答案、改测试、给评测器打补丁。他们加了一个行为监控,作弊解从 28.6% 降到 0.6%,真解从 40% 升到 61%。留一个系统永远看不到的判官,是这件事最低成本的做法。
八、榜只能选引擎#
公开榜的用途是缩小候选范围。用之前要知道四件事。
分数是模型、提示词、评测框架和版本四件东西的合成。作者拿同一个开源模型跑 GSM8K,两种提示格式分别得 0.686 和 0.746。lm-evaluation-harness 那篇论文记录过两位数级别的波动,来源是提示格式、few-shot 例子和抽答案的正则。
题目会漏进训练数据。GSM1k 用同难度的新题重建了 GSM8K,部分模型族掉了最多 8 分,掉多少与它背过原题的可能性相关。另外一些模型族没掉。
榜会过期。2026 年有人统计 60 个常用 benchmark,约一半已经饱和。SWE-bench Verified 两年从约 40% 涨到 80% 以上,策展人自己说它已经分不出前沿模型。Chatbot Arena 上头部模型的差距缩到约 20 个 Elo,落在噪声里。
榜也是冗余的。Zeng 和 Papailiopoulos 2026 年拼了一张 84 个模型乘 133 个 benchmark 的表,它的秩大约是二,两个因子解释了九成以上的变化。挑好的五个 benchmark 能把其余 128 个预测到 4 分以内。选引擎够用,找具体失败模式不够,那件事只能靠自己的 eval。
九、一周一次,四个数字#
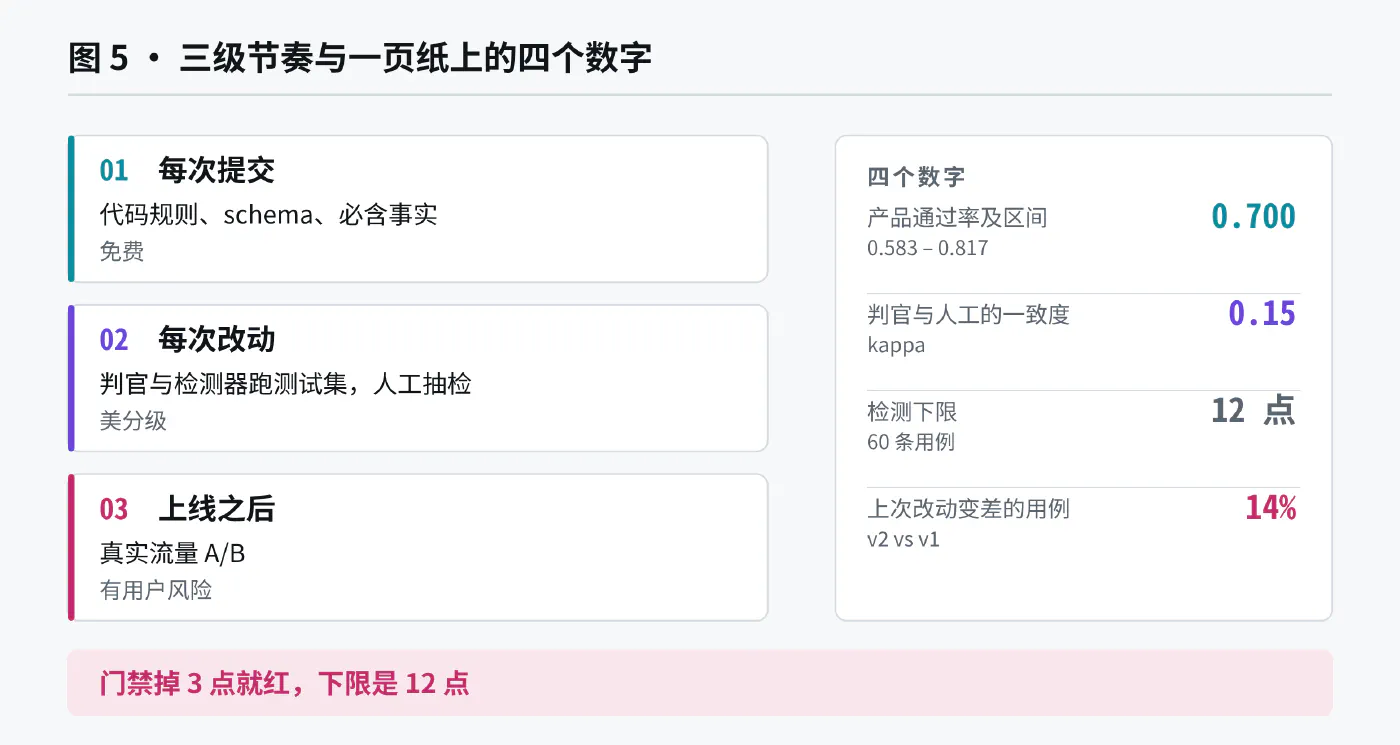
把它变成习惯的成本比想象中低。Hamel Husain 的三级节奏可以直接照搬。
| 级别 | 跑什么 | 什么时候 | 成本 |
|---|---|---|---|
| 1 | 代码规则、schema、必含事实 | 每次提交 | 免费 |
| 2 | 判官和检测器跑测试集,人工抽检 | 每次改提示词、模型、检索 | 美分级 |
| 3 | 真实流量的 A/B | 上线之后 | 有用户风险 |
作者教程里的 CI 门禁是这套东西的最小可用版本,通过率比记录的基线 0.70 掉超过 3 点就让构建失败。它挡的是大坑。12 点的检测下限摆在那里,5 点的回归会直接走过去。门禁页面上应该把这句话写出来,否则它会被当成质量保证。
缓存能把这套东西的成本压到几乎为零。整轮 A/B 是 121 次判官调用,约 4 美分,全部命中缓存时是 0 次调用。跳过 eval 的理由不是钱。
最后一页纸放四个数字。
| 数字 | 作者这批数据的值 | 来源 |
|---|---|---|
| 产品通过率及区间 | 0.700,0.583 到 0.817 | 教程实测 |
| 判官与人工的一致度 | kappa 0.15 | 教程实测 |
| 检测下限 | 约 12 个百分点 | 按 60 条算 |
| 上次改动后变差的用例比例 | 14% | 教程实测 |
四个缺一个,其余三个都没法解释。最容易被跳过的是第二个,而它决定了第一个能不能信。
参考#
- Sergii Makarevych, 《Evals: how to know whether an AI system actually works》, X, 2026. https://x.com/sermakarevich/status/2106453816757354947
- Hamel Husain, 《Your AI Product Needs Evals》, 2024. https://hamel.dev/blog/posts/evals/
- Shankar 等, 《Who Validates the Validators?》, arXiv:2404.12272
- Miller, 《Adding Error Bars to Evals》, arXiv:2411.00640
- Bodhwani, Tran, Wei, 《GAUGE》, arXiv:2609.12191
- Cho 等, 《Ask, Don’t Judge》, arXiv:2606.27226
- Rabanser 等, 《Towards a Science of AI Agent Reliability》, arXiv:2602.16666
- Zeng, Papailiopoulos, 《You Don’t Need to Run Every Eval》, arXiv:2606.24020
- Wang 等, 《The Verification Horizon》, arXiv:2606.26300