同一张图,十五种写法,差 28 个百分点
Oracle 把同一张知识图谱写成 15 种文本格式,用 9 个前沿模型配置跑了四个评测面。抽取任务上格式只值 1.3 到 3.9 个百分点,结构化推理上值 28.4 个。
一句话。图怎么写进 prompt,是一个能测量的系统参数。抽取任务上它值 1.3 到 3.9 个百分点,结构化推理上值 28.4 个,而同一个模型家族里三个推理档位各有各的最优写法,最准的那一档用的 token 反而最少。
一、先把这一步的价格量出来#
假设你在做一件很普通的事。用户问了一句需要多跳才能回答的话,你的检索器从图数据库里捞出两跳邻域,封顶 450 条三元组,然后把这堆东西塞进 prompt。
塞进去的方式,你大概率是随手选的。json.dumps 一下,或者抄一段 turtle,或者干脆写成「A 认识 B」的句子。这篇文章说,这一步的选择能让同一个模型在同一个问题上的准确率差 28.2 个百分点。
数字来自 Oracle 的 Julien Yu、Mihaela Bornea、Avirup Sil、Katrin Kirchhoff 四位作者,论文投在 EMNLP 2026 Findings。他们在 110 道 Wikidata 题上跑 gpt-5.4,把子图和问题都固定住,提示也一字不改,只换序列化格式。jsonld 拿到 41.8%,adjacency 拿到 13.6%。
这件事不是第一次被量。TLAG 在合成图上报过 4.8 到 61.8 个点的差距,KG-LLM-Bench 在知识图谱理解任务上报过 17.5 个点。这篇要做的是把设计空间铺开,把推理档位算进去,再补一个真实子图的实验。
二、十五种写法是哪十五种#
论文按语义显性度把格式分成六个家族,共十五种。这十五种都是作者手写的序列化器,不对应现成库里的某个标准格式。
| 家族 | 格式 | 暴露什么 |
|---|---|---|
| 语义网与约束视图 | turtle jsonld shacl_lite | 类型、谓词、域与值域约束 |
| 结构化自然语言 | text2kgbench entity_centric relation_indexed | 实体与关系的可读描述 |
| 表格 | markdown_table toon | 节点表和边表 |
| 图语言 | mermaid dot | 拓扑的画法 |
| 连通性编码 | adjacency edge_list structured | 邻接关系本身 |
| 散文 | nl_summary friendship | 用句子讲一遍图 |
差别有多大,看两段就好。同一张五节点的小图,structured 写成两行集合。
V = {0, 1, 2, 3, 4}
E = {(0,1), (0,2), (1,3), (2,3), (3,4)}
shacl_lite 把它写成五个形状,每个形状列出这个节点连到谁。
shape(3) {
  path adjacent -> node(1) ;
  path adjacent -> node(2) ;
  path adjacent -> node(4) ;
}
这两段在 GraphQA 上的 token 成本差四倍多。
控制变量做得很干净。同一个模型任务实例里,所有格式共用同一份指令和同一组图事实,问题与随机种子也相同,节点编号和边的顺序都不动,只有序列化那一段不同。温度统一为 0,开了思考的 claude-sonnet-4-6 是例外,它用 API 默认值 1。
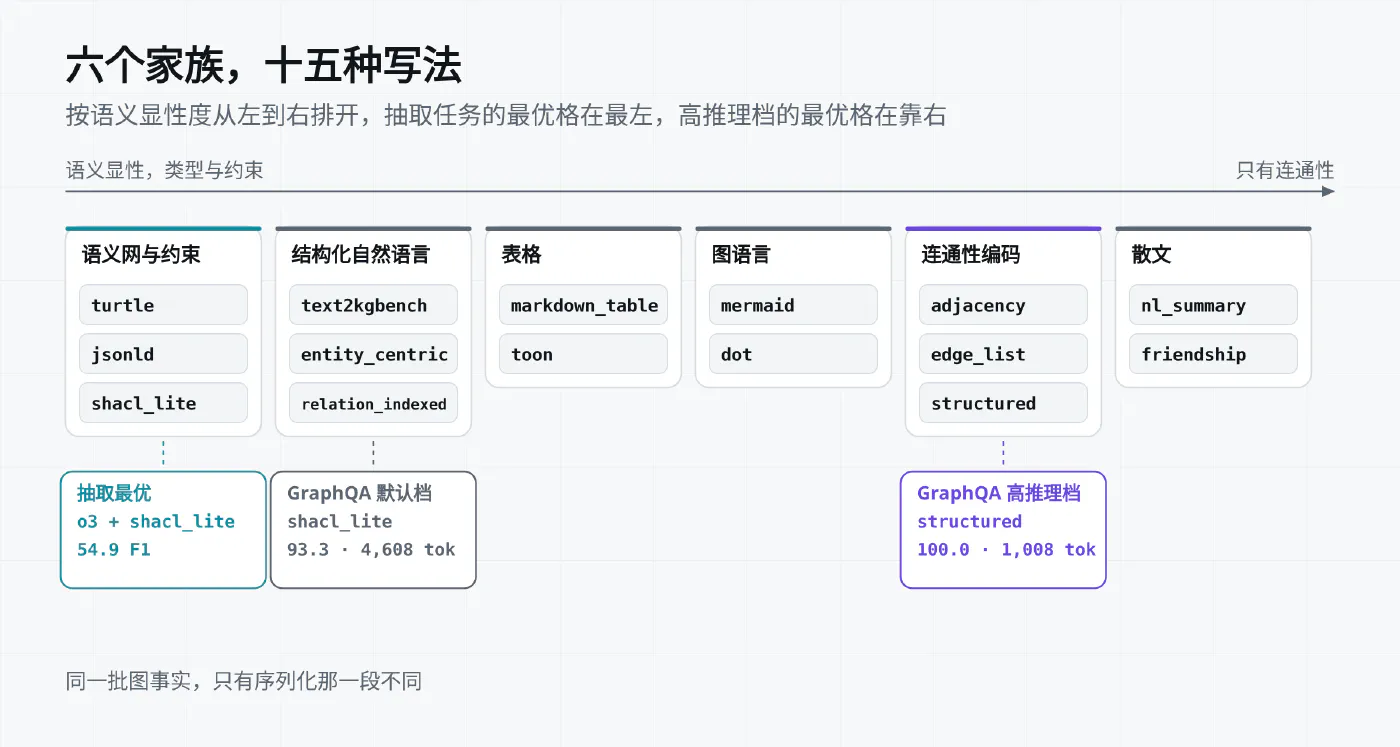
三、抽取任务上,格式几乎不重要#
第一个评测面是本体的知识抽取。Text2KGBench 的 2,014 句测试集,来自 19 个 WebNLG 领域本体,模型要按给定本体把句子里的三元组抽干净。
九个配置的 F1 全落在 45 到 55 之间。因格式产生的变化只有 1.3 到 3.9 个百分点。最好的一格是 o3 配 shacl_lite,54.9 F1,比 2023 年原论文的基线高约 25 个点。
那 25 个点要打个折。作者的评分器把原来的贪心匹配换成了 Hopcroft-Karp 最大匹配,论文自己也写明这个差值只是背景信息,不是编码选择带来的效果。属于格式的那部分是那 1.3 到 3.9。
token 上,shacl_lite、text2kgbench、mermaid 三种在拿到高分的同时最省,turtle 和 jsonld 明显更贵。19 个本体都很小,上下文长度不构成瓶颈,所以这里省下的是账单,不是注意力。
均值还盖住了一件事。按领域拆开看,头部领域(comicscharacter、university、scientist、astronaut)已经饱和,尾部(meanoftransportation、airport、monument、city)一直在 50 F1 以下。在没饱和的领域上,跨格式差距能到 6.1 个点,比 3.9 这个头条数字大。真实业务基本都落在尾部。
四、结构化推理上,同样的选择值 28 个点#
第二个评测面是结构推理。给一张图,问度数、邻居、连通分量、最短路、三角形数量,模型要从文本里把这几个量算出来。作者在原始 GraphQA 上加了两个汇总任务,又造了两个更难的版本。
敏感度跟着难度和推理档位一起涨。
| 评测面 | 规模 | 跨格式差距 |
|---|---|---|
| GraphQA,gpt-5.4 默认档 | 11 个任务,n 从 8 到 50 | 4.8 pp |
| GraphQA,grok-4-fast 非推理版 | 同上 | 17.0 pp |
| GraphQA-Hardened | n 从 35 到 75,加 7 个算子 | 4.2 到 28.4 pp |
| GraphQA-Topology | n 固定 50,换 6 种生成器 | 5.5 到 16.7 pp |
| Wikidata 真实子图 | 10 个种子,110 题 | 24.5 到 28.2 pp |
加进去的七个算子都不是看一眼邻接表就能答的,k-core 大小、图直径、最大团、第二短简单路径、介数中心性最高的节点、局部聚集系数、度数不低于阈值的邻居个数。
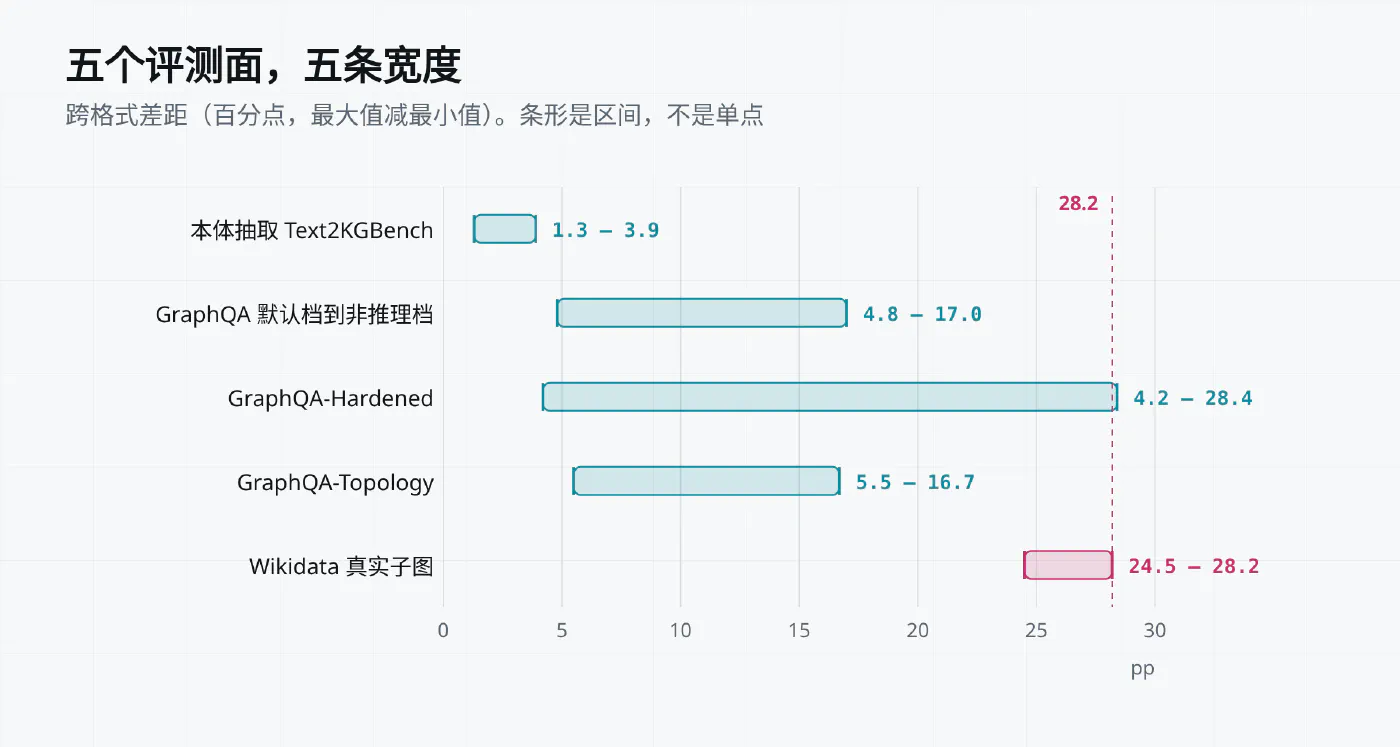
这张图看区间长度。抽取任务上你换格式,大概换不来什么。结构推理上你换格式,可能换掉三分之一的分。
五、同一家族三个档位,三种最优写法#
同一个 gpt-5.4 家族,三个推理档位,各自最爱的格式完全不同。
| 配置 | 最优格式 | GraphQA 准确率 | 输入 token |
|---|---|---|---|
| gpt-5.4-mini | jsonld | 79.4 | 3,501 |
| gpt-5.4 默认档 | shacl_lite | 93.3 | 4,608 |
| gpt-5.4 高推理档 | structured | 100.0 | 1,008 |
第三行最说明问题。准确率拉满的那一档,用的格式最便宜,比默认档的最优格式便宜 4.5 倍。默认档需要 shacl_lite 那四千多个 token 的形状约束,高推理档读两行集合就够。
没有全局最优格式。同一个家族的档位之间都能翻转,跨模型家族更不用说。管线上如果混着几个档位,便宜模型跑长尾、贵模型跑难题,一个写死的格式必然对其中一部分不利。
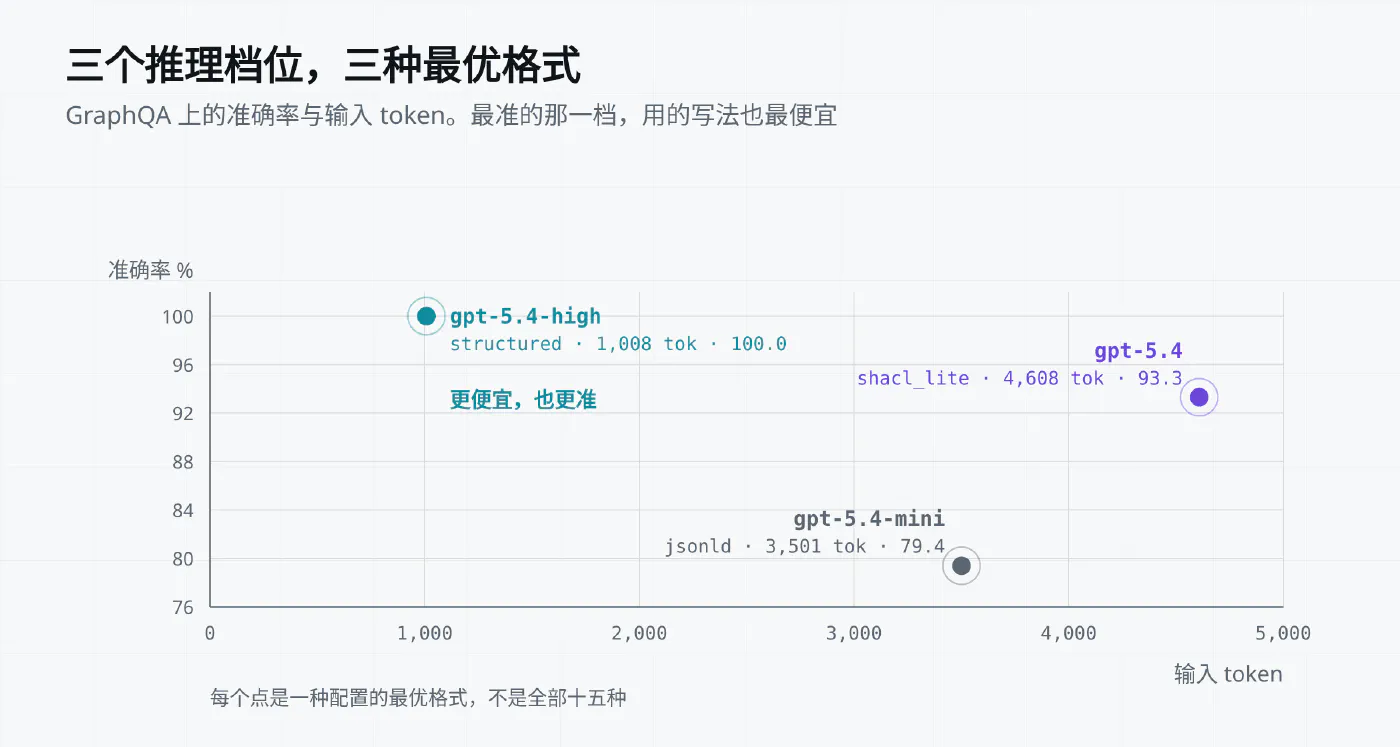
六、真实子图上,纯连通性编码会崩#
合成图的答案都是拓扑量,度数、直径、团大小。真实知识图谱上的问题常常问的是谓词和类型本身,「有多少部电影至少有一个导演」这一句,答案分布在 director 这条边上。
实验是这么设计的。10 个种子实体,覆盖电影、科学家、城市、公司,各取两跳邻域,封顶 450 条三元组。实体名全部换成一致的匿名标识,谓词名保留。110 道题分三类,31 道按关系聚合,31 道按类型聚合,48 道多跳可达。金标准在序列化之前就从规范子图上算好,所以十五种写法里装的是同一批事实。
伪名化这一步是这套设计里最要紧的一处。它堵住了模型靠记住 Rowan Atkinson 演过什么来答题的路,剩下的只有从文本里读结构。
结果两种模型排名一致,jsonld 第一、turtle 第二。
| 模型 | 最好 | 最差 | 差距 |
|---|---|---|---|
| gpt-5.4 | jsonld 41.8% | adjacency 13.6% | 28.2 pp |
| gpt-5.4-mini | jsonld 30.9% | nl_summary 6.4% | 24.5 pp |
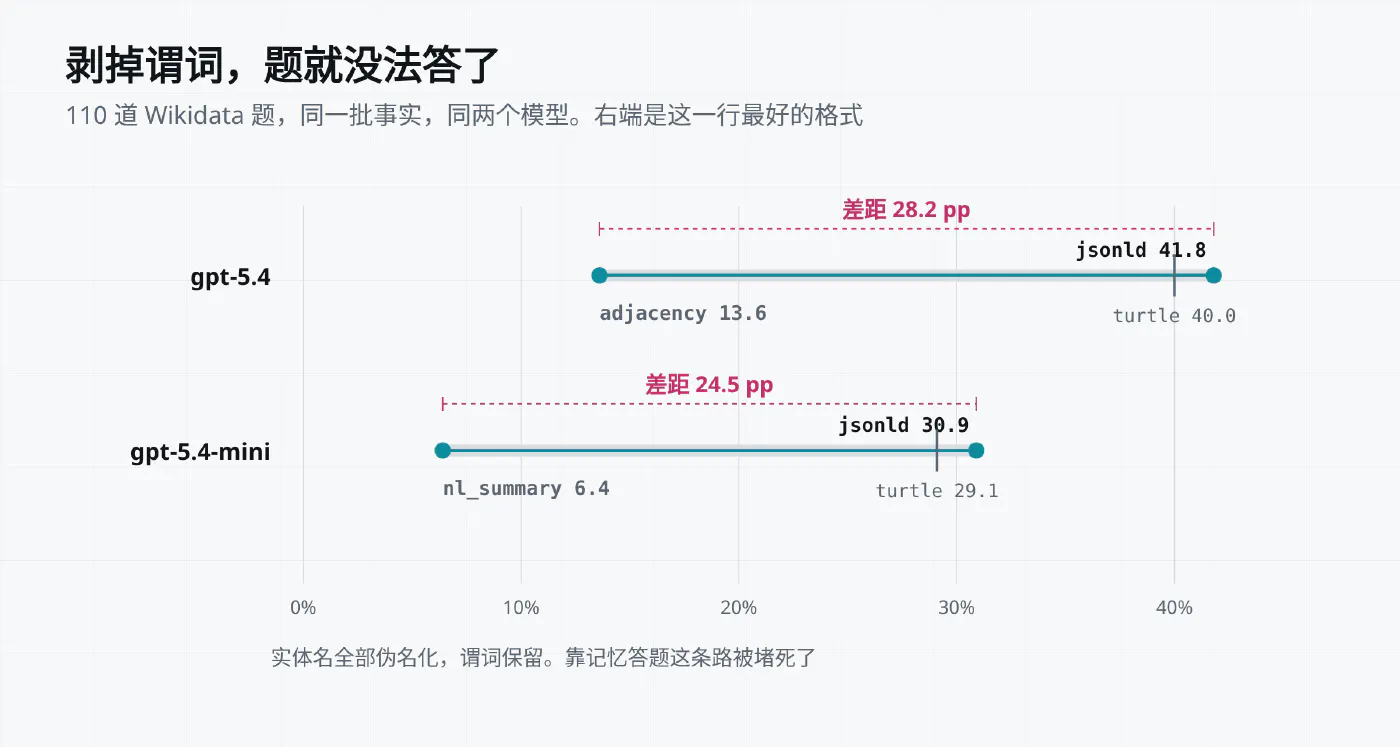
adjacency 在合成图上便宜又好用,到这里只剩 13.6%。原因不难找,它把谓词和类型全丢了。题目问的就是被丢掉的那部分。
作者自己也留了一句限定,格式的家族标签是描述性的,不是因果分解,没有哪一个特征能单独解释这些排名。同一种信息组织方式,在不同任务上的表现可以相反。
七、让模型自己挑格式#
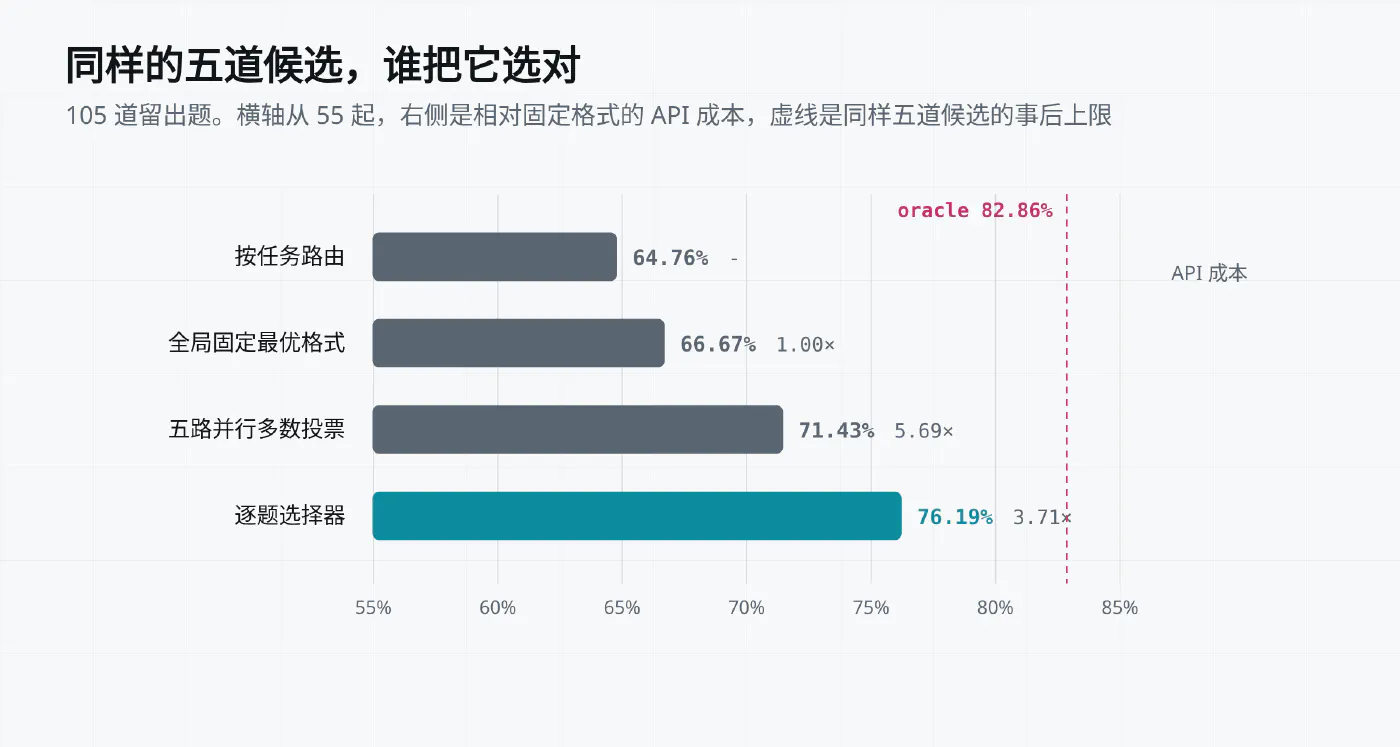
既然最优格式逐题不同,那就每一题都挑一次。作者做了一个选择器,五个候选格式,五路并行打分,最高分那一路交给一次生成调用。打分调用能看到问题、候选格式的名字、该格式在校准集上的历史准确率,以及用这个格式渲染好的图。选择器给出的理由不会流进生成调用,避免答案模型被选择器的说法带跑。
校准集和测试集各 105 题,从同一个生成器独立采样,种子不重叠。校准是一次离线审计,7 个任务乘 15 种格式,1,575 次调用,产出一张按任务和格式分的准确率先验表。
| 策略 | 准确率 | API 成本 | 延迟 |
|---|---|---|---|
| 全局固定最优格式 | 66.67% | 1.00× | 单次调用 |
| 按任务路由 | 64.76% | 接近 1.00× | 单次调用 |
| 五路并行多数投票 | 71.43% | 5.69× | 9.1 s |
| 逐题选择器 | 76.19% | 3.71× | 9.4 s |
| 事后最优上限(同样五个候选) | 82.86% | 不适用 | 不适用 |
逐题选择器比固定最优高 9.52 个点,95% 置信区间 [+1.90, +16.19],McNemar 检验 p=0.013。按任务路由只有 64.76,比固定最优还低,收益来自逐题判断,任务级先验解释不了。
3.71 倍的钱换 9.52 个点,多数人第一次看到会觉得贵。可同样的钱花在多数投票上更差,5.69 倍才换到 71.43。选择器吃掉了上限的六成,剩下的四成留给更好的打分器。
这套东西只在一个分布上验证过。GraphQA-Hardened 的独立种子,选择器和生成器都是 gpt-5.4,测的是同分布的新样本。换数据集、换图分布、换选择器与生成器的模型搭配,论文列为后续工作。
八、你能自己跑的那个检查#
这套结论要落到你自己的管线上,得先知道你的任务落在窄带还是宽带。下面这个检查半下午能跑完。
- 固定 20 到 50 道题,固定同一份图。让检索器每次返回不同的图,比较就没有意义了。
- 挑 3 到 5 种写法,覆盖谱的两头。
jsonld、shacl_lite、structured、adjacency、nl_summary够用。 - 温度调 0,关掉响应缓存,每种写法跑 3 轮。
- 每题记两列,答对与否,以及输入 token 数。
- 算两个数,跨格式差距(最大值减最小值)和同格式三轮的标准差。
判定规则可以直接抄。
# spread_check.py,作者脚本,不是仓库代码
def verdict(spread_pp: float, run_std_pp: float) -> str:
    if spread_pp < 3:
        return "固定一种格式,别在这上面花时间"
    if spread_pp < 10:
        return "按任务分组各固定一种,先别上选择器"
    if run_std_pp * 3 > spread_pp:
        return "差距不够稳,加样本再来一次"
    return "差距够大,值得做逐题选择"
最后一行的阈值来自论文的一个对照。同样十五种格式、三轮独立解码、20,250 次调用,同格式重复跑的准确率标准差是 1.5 个点,跨格式差距平均是它的 7.7 倍。如果你的重复标准差接近差距本身,你量到的多半是噪声。
九、还没答案的两个问题#
第一个是迁移。选择器用 gpt-5.4 选、也用 gpt-5.4 答,这套流程搬到 Claude 或者开源权重模型上还成不成立,论文没测。选择器打分的依据是「这个格式是否把要算的子结构摆在了明面上」,这个判断本身也依赖模型能力。
第二个是尾部领域。抽取任务的均值落在 45 到 55 F1,按领域拆开,尾部领域在 50 以下,跨格式差距能到 6.1 个点。你的业务更可能落在尾部,而尾部恰恰是这篇论文最薄的一层。
还有一件事论文自己承认了,所有被测模型都是闭源商用系统,无法排除某些格式在预训练里出现过更多次。换成开源模型,这条限制至少可以自己验一次。
参考#
- 论文 Graph Serializations for Reasoning LLMs ,EMNLP 2026 Findings
- Talk like a Graph ,TLAG,GraphQA 的出处
- KG-LLM-Bench ,17.5 个点的那篇
- Text2KGBench ,本体驱动的抽取基准
- SHACL
,
shacl_lite的来处 - JSON-LD 1.1
,
jsonld的规范