如果没有 KV cache,编码 agent 该怎么设计
一份 2026 年 9 月的设计笔记从一个反问出发,把编码 agent 的六个常见缺陷归到同一个原因,并给出以 Jev 决策层为核心的替代架构。路由算术、token 占比与安全分级逐项标注来源。
2026 年 9 月一份围绕 Jev 的设计笔记,用一句话把编码 agent 的六个毛病收在一起。假如语言模型没有 KV cache,今天这些 agent 会写成什么样。答案不在更强的模型上。它要求有人决定,每一轮往模型面前放什么。
片子两分多一点,中文配音,字幕烧在画面里,也可以用播放器关掉。
一、一个反问,六个症状#
今天的编码 agent 大多是一个循环、一个模型、几只工具。真正决定它好不好用的东西不在这个循环里,而在循环每转一次时递给模型的那段文本。
KV cache 是这段文本写成追加式记录的原因。复用缓存前缀几乎免费,改动靠前的任何一个字节,后面全部要重算。这条经济学没有写进任何设计文档,它写在账单里,并且决定了几乎所有主流 agent 的骨架。
把缓存当成不存在,会同时发生两件事。一是可以按状态显式设计,上下文是组装出来的。二是六个一直被人抱怨的缺陷露出同一个底。
| 症状 | 为什么它会存在 | 代价 |
|---|---|---|
| 路由失败 | 交回大模型时上下文被重算 | 混合路由比纯 frontier 更贵 |
| 工具挤占上下文 | schema 必须常驻系统消息 | 无关工具的 token 照付,选择还更差 |
| 压缩压在问题之前 | 假设所有轮次共享一份状态 | 查询无关的压缩丢掉后面要用的信息 |
| 子 agent 很少启动 | 传什么进去、合并什么回来很难 | 并行度低 |
| 重启丢掉状态 | 有状态的记录会漂移 | 坏状态和好状态一起扔 |
| 内置能力之争 | 每个内置永久占用上下文 | 在易用和强大之间二选一 |
这份笔记给替代方案留了一个位置,叫 Jev。它不写代码,坐在模型旁边当决策层。harness 把当前状态交给它,包括目标、上下文、规则、可用动作和已执行动作,同时给一个预设问题,它返回类型化答案,取值为 choice、score 或 noul,各带一个概率。类型化带来的是可校验,harness 能卡阈值、能分支,不用解析散文。
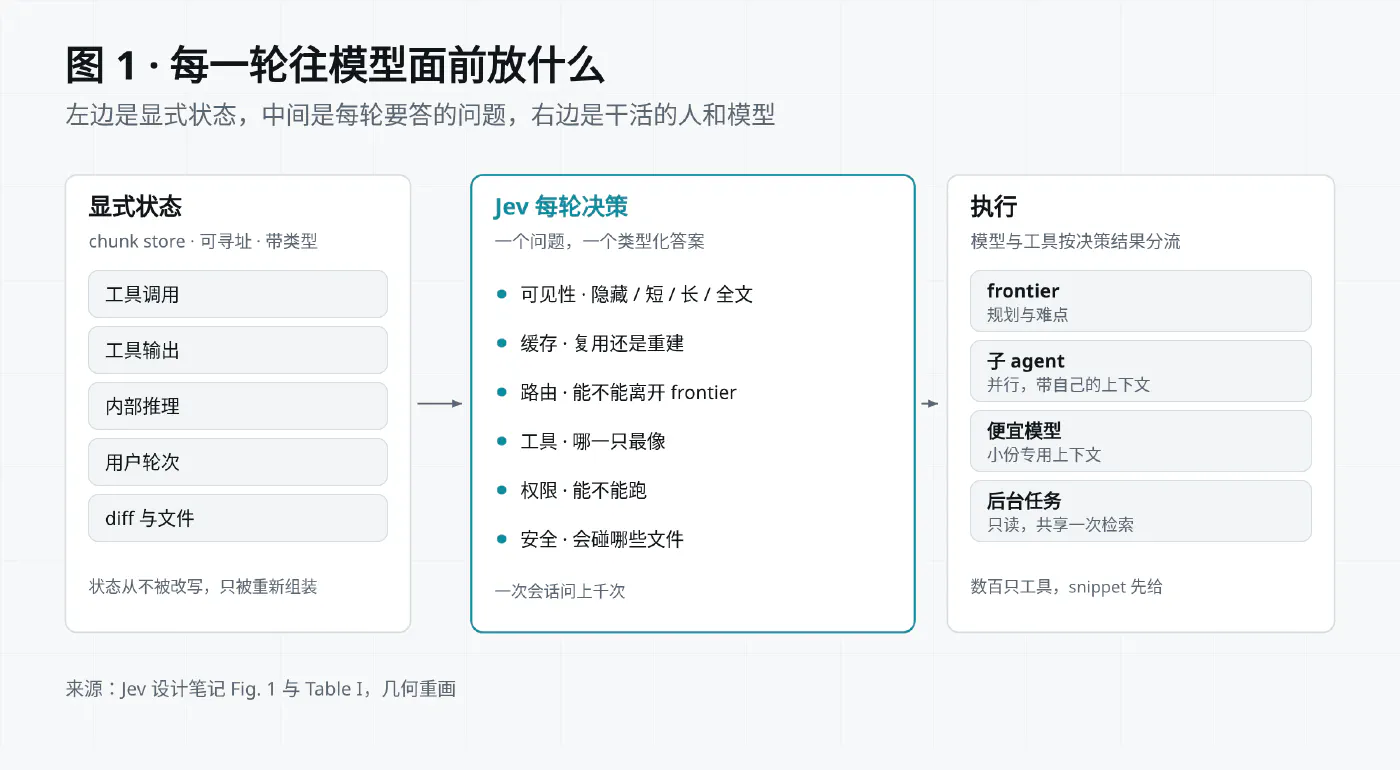
笔记把这套东西压成一张表,六个高频决策点,一个问题一个类型化答案。
| 决策点 | 问 Jev 什么 | 返回什么 |
|---|---|---|
| 上下文 | 这一段对这个查询该有多可见 | 隐藏、短摘要、长摘要、全文 |
| 缓存 | 复用前缀还是重建 | noul 加概率 |
| 路由 | 这个子任务能不能离开 frontier | 选择加成本估计 |
| 工具 | 哪只工具对得上这个意图 | 排序结果,取前 k |
| 权限 | 这条命令能不能跑 | 允许、询问、拒绝 |
| 安全 | 这个任务会碰哪些文件 | 敏感度分数 |
六个问题每轮都问,一次会话里问上千次。笔记把杠杆放在这个位置,模型那边没有。
二、路由省的钱是负的#
最直觉的做法是把规划留给 frontier,执行交给便宜模型,最后再让 frontier 审一遍。笔记用清单价把它算了一遍,Opus 每百万 token 输入 5 美元、输出 25 美元,Sonnet 是 3 和 15。设 X 是上下文 token,Y 是生成的 token,Z 是干活过程中另外读进去的 token,比如命令输出和文件内容。
| 路径 | 生成 | 读取 | 总计 |
|---|---|---|---|
| 纯 Opus | 25·Y | 5·Z | 25Y + 5Z |
| Opus → Sonnet → Opus | Sonnet 加载 3·X,生成 15·Y | Sonnet 读 3·Z,Opus 重读 5·(Y+Z) | 3X + 20Y + 8Z |
代进一个像样的会话形状,X 等于 0.65,Y 等于 0.12,Z 等于 0.23,纯 Opus 是 4.15,路由那条是 6.19。想省钱的那条路贵了 49%。
代价来自两个地方。往下交的时候,便宜模型得先把上下文加载一遍;往上交的时候,frontier 得重读帮手产出的东西。只要会话够长(X 大)、读的比写的多得多(Z 远大于 Y),或者两者兼有,这笔账就翻不回来。
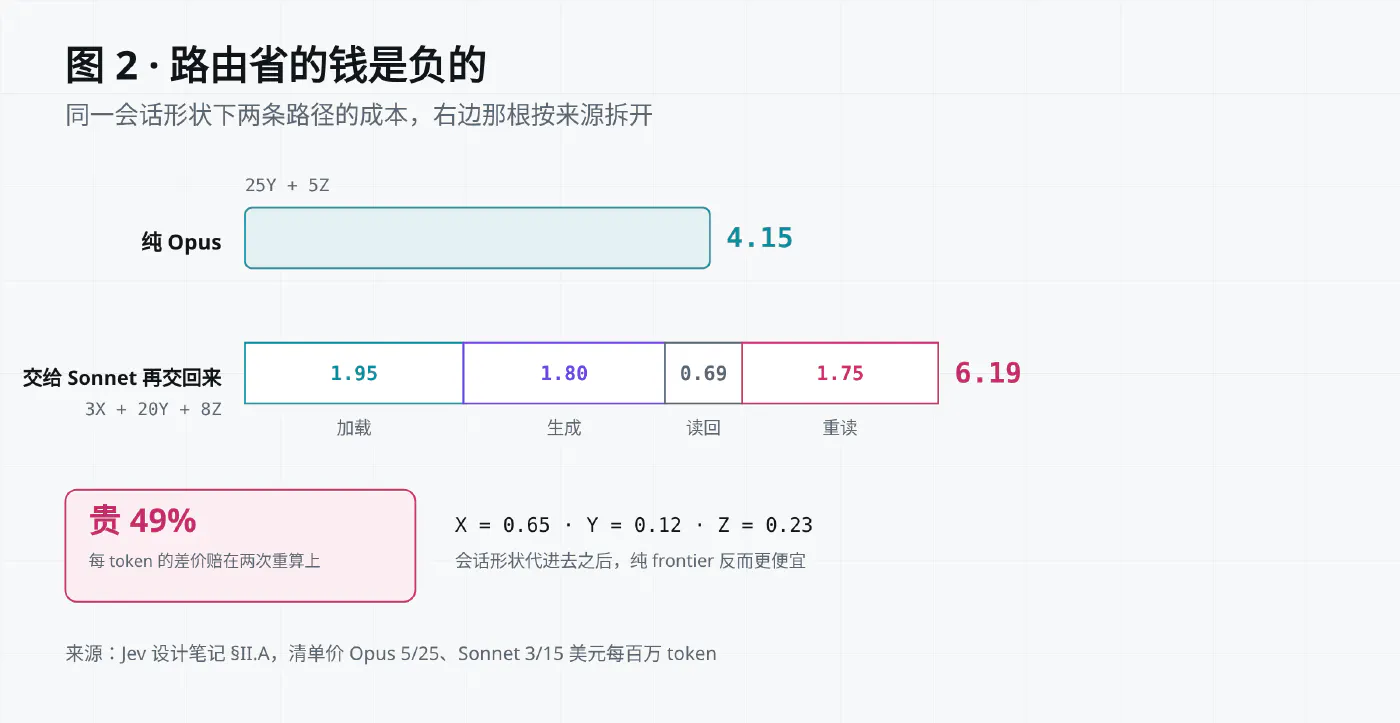
结论推不到「路由没用」那么远。按 token 计价的路由用错了单位,该计价的是上下文重建的次数。路由变得可行有两个前提,harness 能递给便宜模型一小份专用上下文,回程不必让 frontier 重读全部。
三、钱花在读和写上#
在动手改 harness 之前,值得先看清一次会话把钱花在哪。笔记给了一张按子任务切分的估算表,口径偏输入侧,反复重读的文件每次都算一次。
| 子任务 | 大致占比 | 说明 |
|---|---|---|
| 读文件内容 | 30% 到 40% | 最大的一块,文件随上下文被反复读 |
| 搜索代码库 | 10% 到 18% | grep、glob、列目录,输出噪声大 |
| 命令输出 | 10% 到 20% | 报错和栈一失败就膨胀 |
| 系统提示、工具 schema、AGENTS.md | 5% 到 12% | 每轮都要付的固定开销 |
| 会话回放 | 放大器 | 上面每一项被重复计数的原因 |
| 推理与规划 | 5% 到 15% | 硬 debug 时更高 |
| 写代码与改代码 | 4% 到 10% | diff 和 str_replace 本身很紧凑 |
| 向用户解释 | 2% 到 5% | CLI agent 故意写得很短 |
最刺眼的是靠后那行。写代码是编码 agent 存在的理由,却是账本上最小的一项。
外部证据指向同一个方向。微软的 fastcontext 项目报了一组数。在 GPT-5.4 的轨迹里,读和搜占全部工具调用轮次的 56.2%,占主 agent token 的 46.5%(项目自报,未见独立复现)。两组数字的口径不同,说的是同一件事。
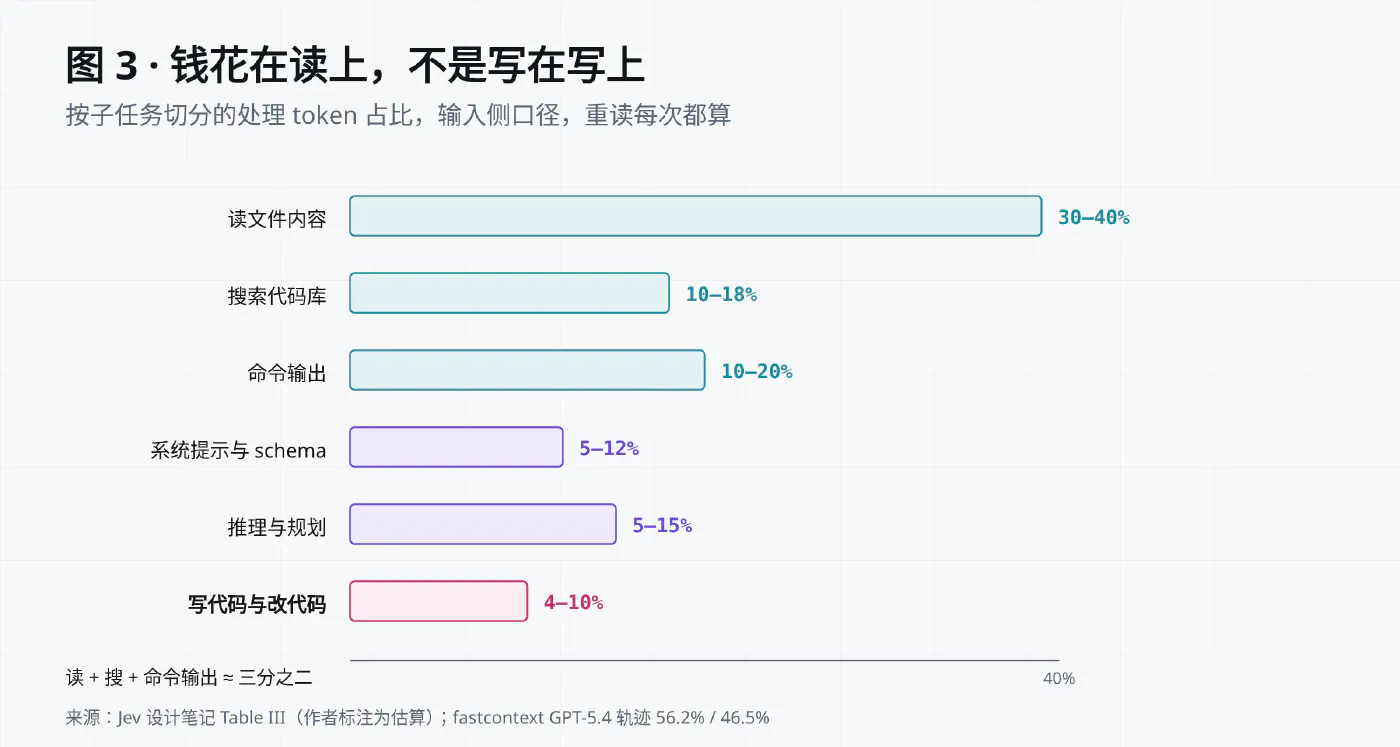
如果这两组数字能推广,编码 agent 最大的一笔效率提升会来自更聪明的检索。更好的模型给不了它,更好的 diff 格式也给不了。
四、可见性阶梯#
中心提案是把上下文从静态名词改成每轮动作。每个用户查询,harness 问 Jev 两件事。上一份上下文还值不值得留着,复用缓存和重建哪个更便宜也更好。新的上下文怎么拼,把相关的都放进来,别的都不放。
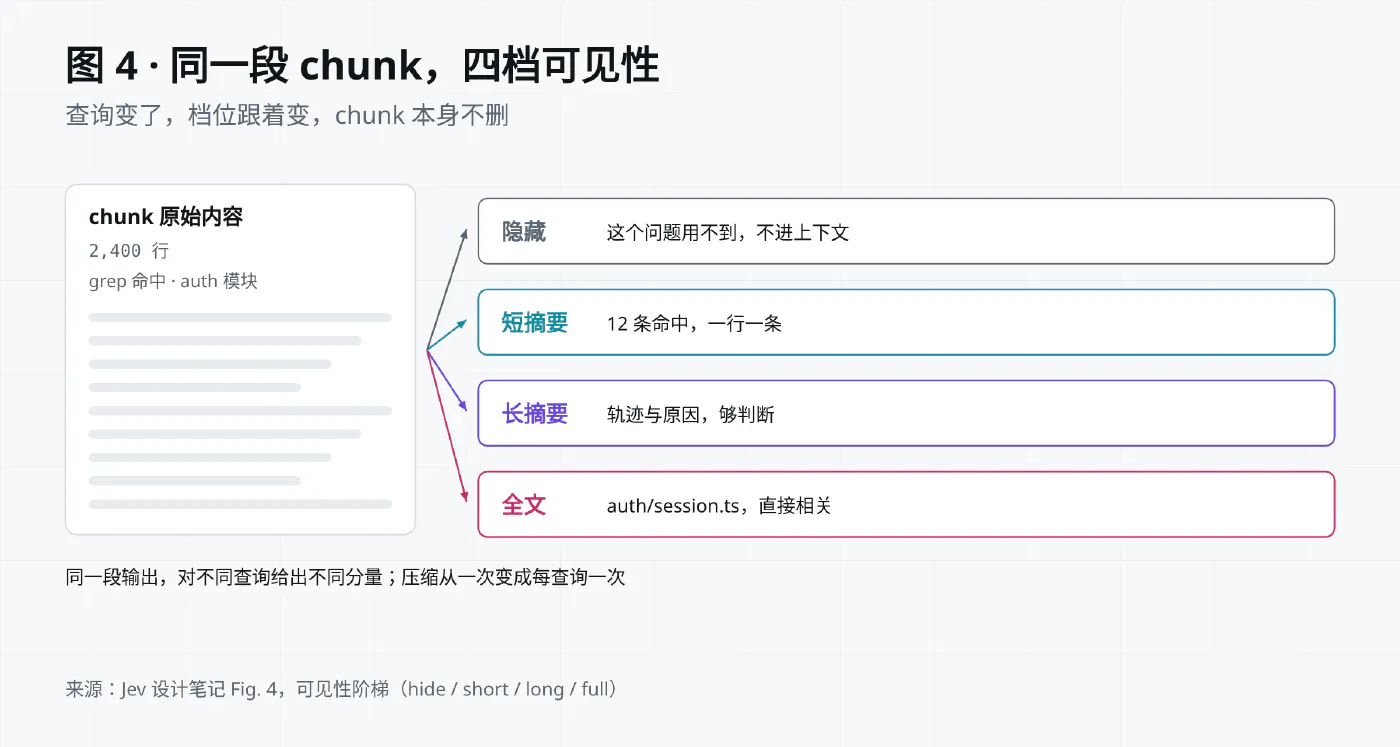
最简形式是给每个 chunk 一个 noul。每一次工具调用输入、每一次工具输出、每一段内部推理、每一轮和用户的对话,都要过一次。后来的版本把分数换成档位,隐藏、短摘要、长摘要、全文。
同一段 2,400 行的 grep 输出,对这个问题是 12 条命中,对下一个问题可以完全不显示,而它在状态里从未被删除。
压缩这件事因此换了位置。老办法压一次,压的时候还不知道要问什么。阶梯每查询压一次,压之前就知道问题是什么。一篇在问题出现之前写好的摘要,一定会扔掉问题需要的东西。
笔记里还有一个视觉上的想法。如果 harness 能给 grep 输出做一张热力图,标出哪些行与当前问题有关,就能按预算裁到任意精度。作者顺口加了一句,这样看起来也酷。
同一个机制放开了子 agent。今天子 agent 贵,贵在决定传什么进去。如果这层上下文能自动拼好,子 agent 可以用得比现在频繁得多,也可以变成一个用户可调的旋钮,多花钱换更快更好,或者少花钱稳妥跑。
五、工具分三层,指令挂在条件上#
工具现在的处境有点怪。schema 必须在系统消息里一次写全,不管这轮用不用得上。它吃掉很大一块上下文,选择质量也不见得好。笔记的工作假设是两件事叠在一起,一是工具数量多,二是工具用法与训练分布不一致。
解法是分层披露。
| 层 | 内容 | 什么时候加载 |
|---|---|---|
| 第一层 | 一行一个能力,几百只工具的地图 | 相关时加载 |
| 第二层 | 被选中的那几只的完整参数 | 选定之后 |
| 第三层 | 某个一次性查询要用的手册 | 用完即弃 |
模型不能提出它不知道存在的动作,所以第一层必须便宜地列出全部能力。第一层的描述可以很短,像 skill 的描述那样。真正的要求是第三层用完就从上下文里消失。
如果这一层能成立,第二节那个内置能力之争自己就散了。一个内置在没被用到之前几乎不花钱,agent 可以带几百只工具和几千页文档。笔记还补了一句生意经,近乎零成本的集成是很强的联合营销渠道。
同一条思路铺到指令上。今天的 AGENTS.md 整份加载,笔记主张按条件加载。改前端代码时挂上风格指南,在某个子目录里干活时挂上那个目录的坑清单,笔记建议每个子目录都有一份。写散文时挂上语气样例和禁忌清单。
它和 skill 的区别在这里。skill 倾向表达现在做这件事,条件指令表达把这件事记在心里。条件指令还需要一个 skill 没有的性质,免疫压缩。长会话会把早加载的 skill 压缩掉,绑在条件上的指令则在条件成立时重新加载。
六、按敏感度路由,后台共享一次检索#
今天谈路由只谈两根轴,难度和成本。笔记加了第三根,信任。一些开源权重模型经低价供应商提供服务,价格远低于 frontier API,数据会不会留在外面是个真问题。
做法是给每个子任务估一个「它大概会碰哪些文件」,把策略绑在文件类型上,再让路由跟着策略走。
| 会碰的文件 | 策略 | 可用模型 |
|---|---|---|
| 公开文档、开源依赖 | 开放 | 任意,先挑便宜的 |
| 应用代码 | 标准 | 经过审核的供应商 |
| 密钥、环境变量、基础设施配置 | 受限 | 仅第一方 frontier |
| 专有研究代码 | 自定义 | 排除指定供应商 |
最后一行是更广的一个点。团队可能因为自己在做模型研究而避开某家的模型,也可能因为安全敏感的工作而避开某些供应商。路由一旦变成策略驱动,这些偏好就成了配置,不再依赖纪律。
另一半是后台。笔记在几种流行的 agent 工作流里看到一个共同形状。
- 边干活边更新的 HTML 进度页
- 一条「理解而不是生成才是新瓶颈」的判断
- 在后台生成 eval
- 一个用几张图讲清一个系统的 ELI5
- 让 agent 维护一个带截图和笔记的进度页,长跑时用手机看
这些任务的共同点是后台运行、只读、不抢锁。让它们的检索做一次、共享,是最省的一笔,因为第三节说了检索吃掉 token 预算里最大的一块。读出与写出的显式区分在这里第一次派上大用场,只读任务永远不冲突。
七、这套设计的代价#
把六个症状收在一处很好看,落地的成本得一条条算。
Jev 每轮要额外跑一次模型,延迟和费用都加在热路径上。决策层也会错,类型化只让错误可校验,不让它正确。
按敏感度路由依赖一个「这个任务会碰哪些文件」的估计。这个估计本身是模型输出,也会错,而错的方向是数据出界,这是所有错误里最难挽回的一种。
分层披露把「模型不知道存在的工具」变成永久盲区。第一层描述写坏了,那只工具就永远不会被选中,而且没有任何信号提示你。
笔记里的数字要说清性质。路由的 4.15 和 6.19 用的是清单价和一个示例会话形状,作者没有跑真实计费;token 占比那张表作者自己标了 illustrative;fastcontext 的两个百分比是项目自报。
反例也留着。会话短、读得很少的路由确实省钱,笔记的公式自己承认这一点。插件形态的 agent 拿不到上下文组装权,这套东西对它基本无效,这也是笔记开头那条「有些能力只能自己做」的由来。
八、怎么自己核这笔账#
五处都能在一两分钟内复现。
| 要核什么 | 去哪里 | 看什么 |
|---|---|---|
| 路由的账 | 笔记第二部分的公式 | 用自己的 X、Y、Z 代进去,别用作者的 |
| 六个症状落在哪 | Table I 与 Table II | 六个决策点各有对应的代价 |
| token 占比 | Table III | 表头写着估算,不是测量 |
| 56.2% 与 46.5% | fastcontext 项目说明 | 口径是工具轮次与主 agent token |
| 阶梯的实际效果 | Fig. 4 | 同一段输出在四档下的样子 |
动手的部分是十分钟的活。挑一次你最近的长会话,按子任务给 token 打标,再把同一批 token 按第二节的公式算一遍「交出去再交回来」。如果 Z 明显小于 Y,你的会话可能真的适合路由;如果 Z 是 Y 的两倍,账会跟 4.15 对 6.19 一样难看。
九、两个还没答案的问题#
第一个问题,判断相关性本身要花 token。给每个 chunk 打分、给 grep 输出做热力图,这些动作的成本没有进那笔 4.15 对 6.19 的账。打分花的钱什么时候超过它省下的钱,笔记没有算,我也不打算替它猜。
第二个问题,上下文每轮重装,前缀缓存还剩多少价值。Jev 化之后,缓存从约束变成可选项,代价是命中率会掉。掉多少取决于两次重装之间重叠多少,而这个重叠度没有任何公开测量。它可能决定这套设计在长会话里是省的还是贵的。
参考#
- 《Jev Engineering for Coding Agents》,独立整理稿,2026 年 9 月。基于 Diogo Almeida(TypeSafe)的设计笔记。https://github.com/yibie/jev-engineering-zh
- TypeSafe,Jev 决策模型。https://typesafe.ai
- Microsoft,fastcontext 项目。https://github.com/microsoft/fastcontext
- Zhang, A.《Recursive Language Models》,2025。
- 笔记提到的工具,headroom、rtk、ast-grep、ast-outline、fastcontext、fff。https://github.com