Agent 的动作在被执行之前,应该有一道能查、能算、能打回的门。JevAct 的做法是把这道门拆成两半。代码算工具记录能确定的事实,决策模型只回答“对话里到底说了什么”,再用一条布尔规则把两者合起来。它在 τ²-Telecom 上让八个 agent 全部变好,也清楚地暴露了自己的边界。
中文配音版,2 分 41 秒。中文与英文两版内容一致。
原文是《Think Before You Act》(IBM SIL,副标题 Decision Gate for LLM Agents),arXiv 编号 2610.38620,全文 18 页,点开就能读 arXiv 页面,也可以直接看 PDF。这篇是我读完全文之后写的,下面的数字、阈值和局限都能在原文里逐条对回去。
一、提案即执行
ReAct 之类的 agent 循环有一个默认动作,模型说什么,harness 就执行什么。这在“回答错了还能下一轮改”的场景里问题不大,但有三类动作是不可逆的(§1)。
| 不可逆的动作 | 出错的代价 |
|---|---|
| 写调用(预订、取消、改设置) | 改了数据库状态,有的改不回来 |
| 交班(转人工、告诉用户“没办法了”) | agent 的尝试结束,用户被推给下一个人 |
| 不该发生的写(用户没要求) | 越权,比答错更严重 |
现有方法各自解决一部分(§2),ReAct 交错推理与动作;Self-Refine、Reflexion 在事后批评、下一轮改;GuardAgent、AgentSpec、ShieldAgent、CUGA、ToolSafe、PolicyGuard、ToolFence 这一类做运行期策略约束(§2.2);LLM-as-a-judge 让另一个大模型来评审(§2.3)。但“在这一条动作执行前,用一条可执行的规则判断它对不对”仍然是缺口,生成式的评审会给出解释,解释还要再被解析成“放行/拦截”;而用前沿模型逐条评审,成本又高。
论文的立场很明确,把这道门做成概率阈值化 + 可执行检查,而不是再找一个更大的模型来“讲道理”。
二、两种证据,各管一半
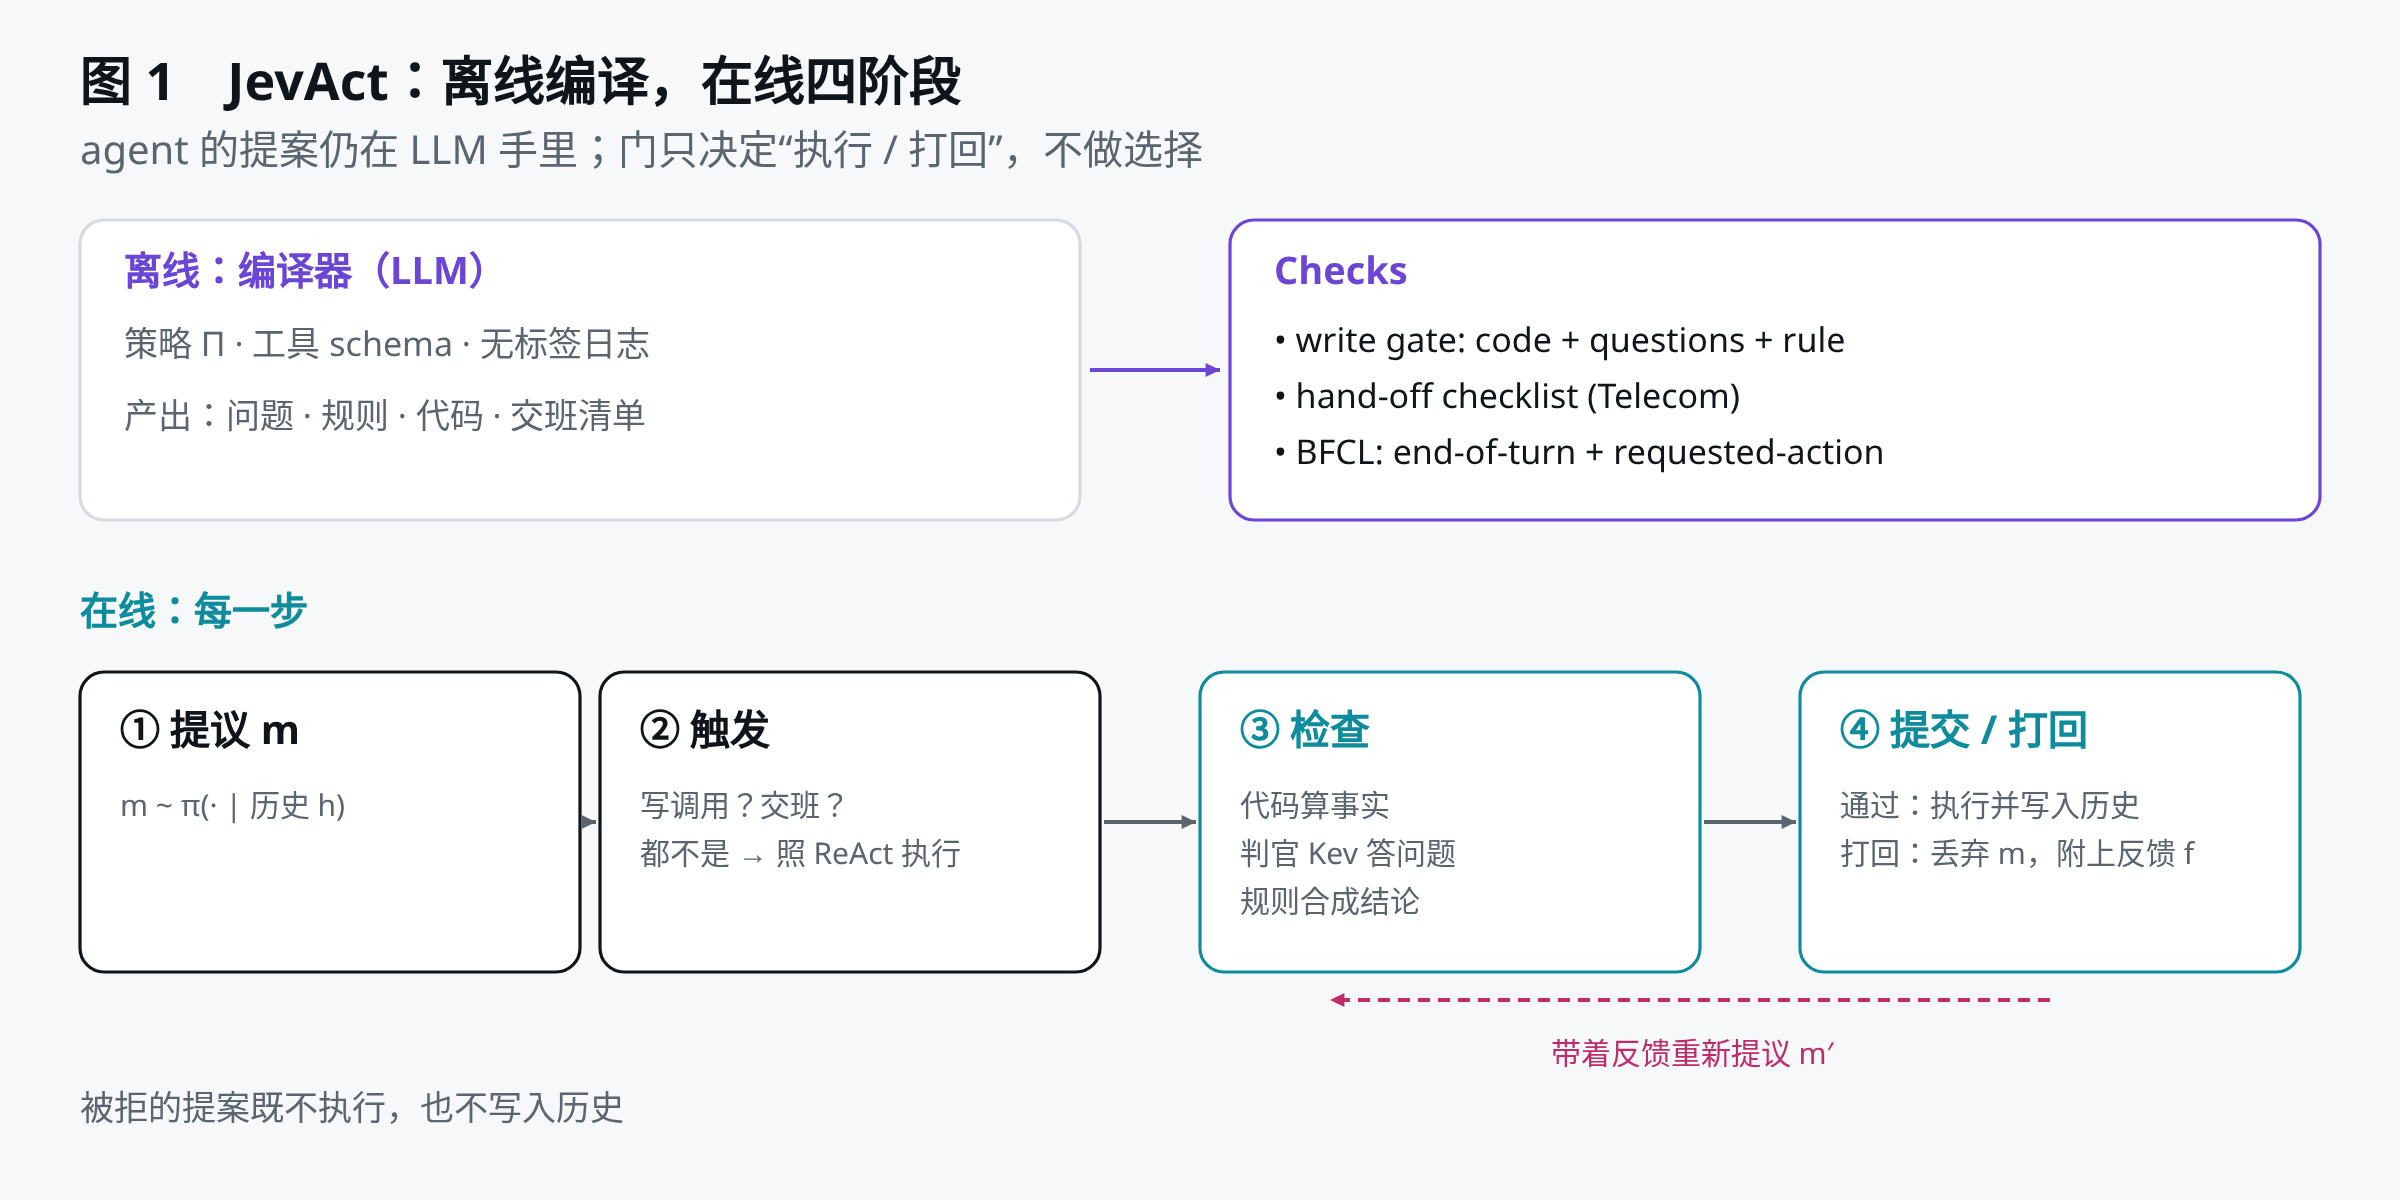
图 1 agent 仍然负责提议,门只负责决定“执行还是打回”。
JevAct 是一条跑在 ReAct 循环外面的 harness。它不选动作,只做验证。关键在于把“这个动作对不对”拆成两类问题。
- 工具记录能确定的事实。预订创建于几小时前、免费托运额度是多少、这单是不是已经飞过一段、金额有没有超。这些交给代码算,因为算术与日期比较是决策模型最不擅长的。
- 只能从对话读出的事。用户到底要求了什么、有没有明确确认、某个排障步骤是不是试过。这些交给决策模型用是非题回答。
两条证据最后由一条布尔规则合成结论。这一步是论文真正的设计主张,确定性的部分不要交给概率模型,概率的部分不要硬塞进代码。
三、四个组件
3.1 决策环的四个阶段
每一步四阶段。
- 提议。LLM 读历史 h_t,给出消息 m(可以带工具调用)。
- 触发。m 里有写调用 → 走写门;m 是交班 → 走交班检查;都不是 → 照 ReAct 直接执行。
- 检查。返回 pass 或 flag,flag 附带一段反馈 f。
- 提交或打回。通过的就执行并写入历史;被打回的消息既不执行,也不写入历史,agent 带着 f 重新提议。
两个细节值得记住,都在 §3.2 写明。
- 反馈是临时的。它只对这一次重新提议可见,不进对话历史。所以前面步骤的批评不会在上下文里越积越多。
- 预算是硬的。写门 R = 2,交班检查 R = 1。用完预算,下一次提议就不再检查、直接执行。门不可能无限拦人,也只增加最多 R 次额外的 LLM 调用(§3.2)。
3.2 编译器
离线做,每个领域跑一次,用 LLM(论文里是 Claude Opus 4.6)生成四类产物,是非题、布尔规则、算事实的代码、交班清单。六步的输入输出见论文表 6,提示词全文在附录 A.1(§3.3)。
3.3 判官 Kev
一个开源的 Jev 类决策模型(§3.4)。给定 prompt 和固定选项的问题,它一次前向就返回每个选项的概率,不生成文本。同一个 prompt 下的多个问题共享这一次前向。所以一次检查的成本不随问题数量增长。论文用的是 Kev-27B(Qwen3.8-27B 的微调版,未额外训练;另外两个尺寸 9B 与 0.8B 只用于消融)。因为它与 agent 的 LLM 是两个模型,agent 不会“自己审自己”。
3.4 三种检查
写门、交班检查,以及 BFCL 上没有策略时用的两个通用检查。
四、六步编译,两道过滤器
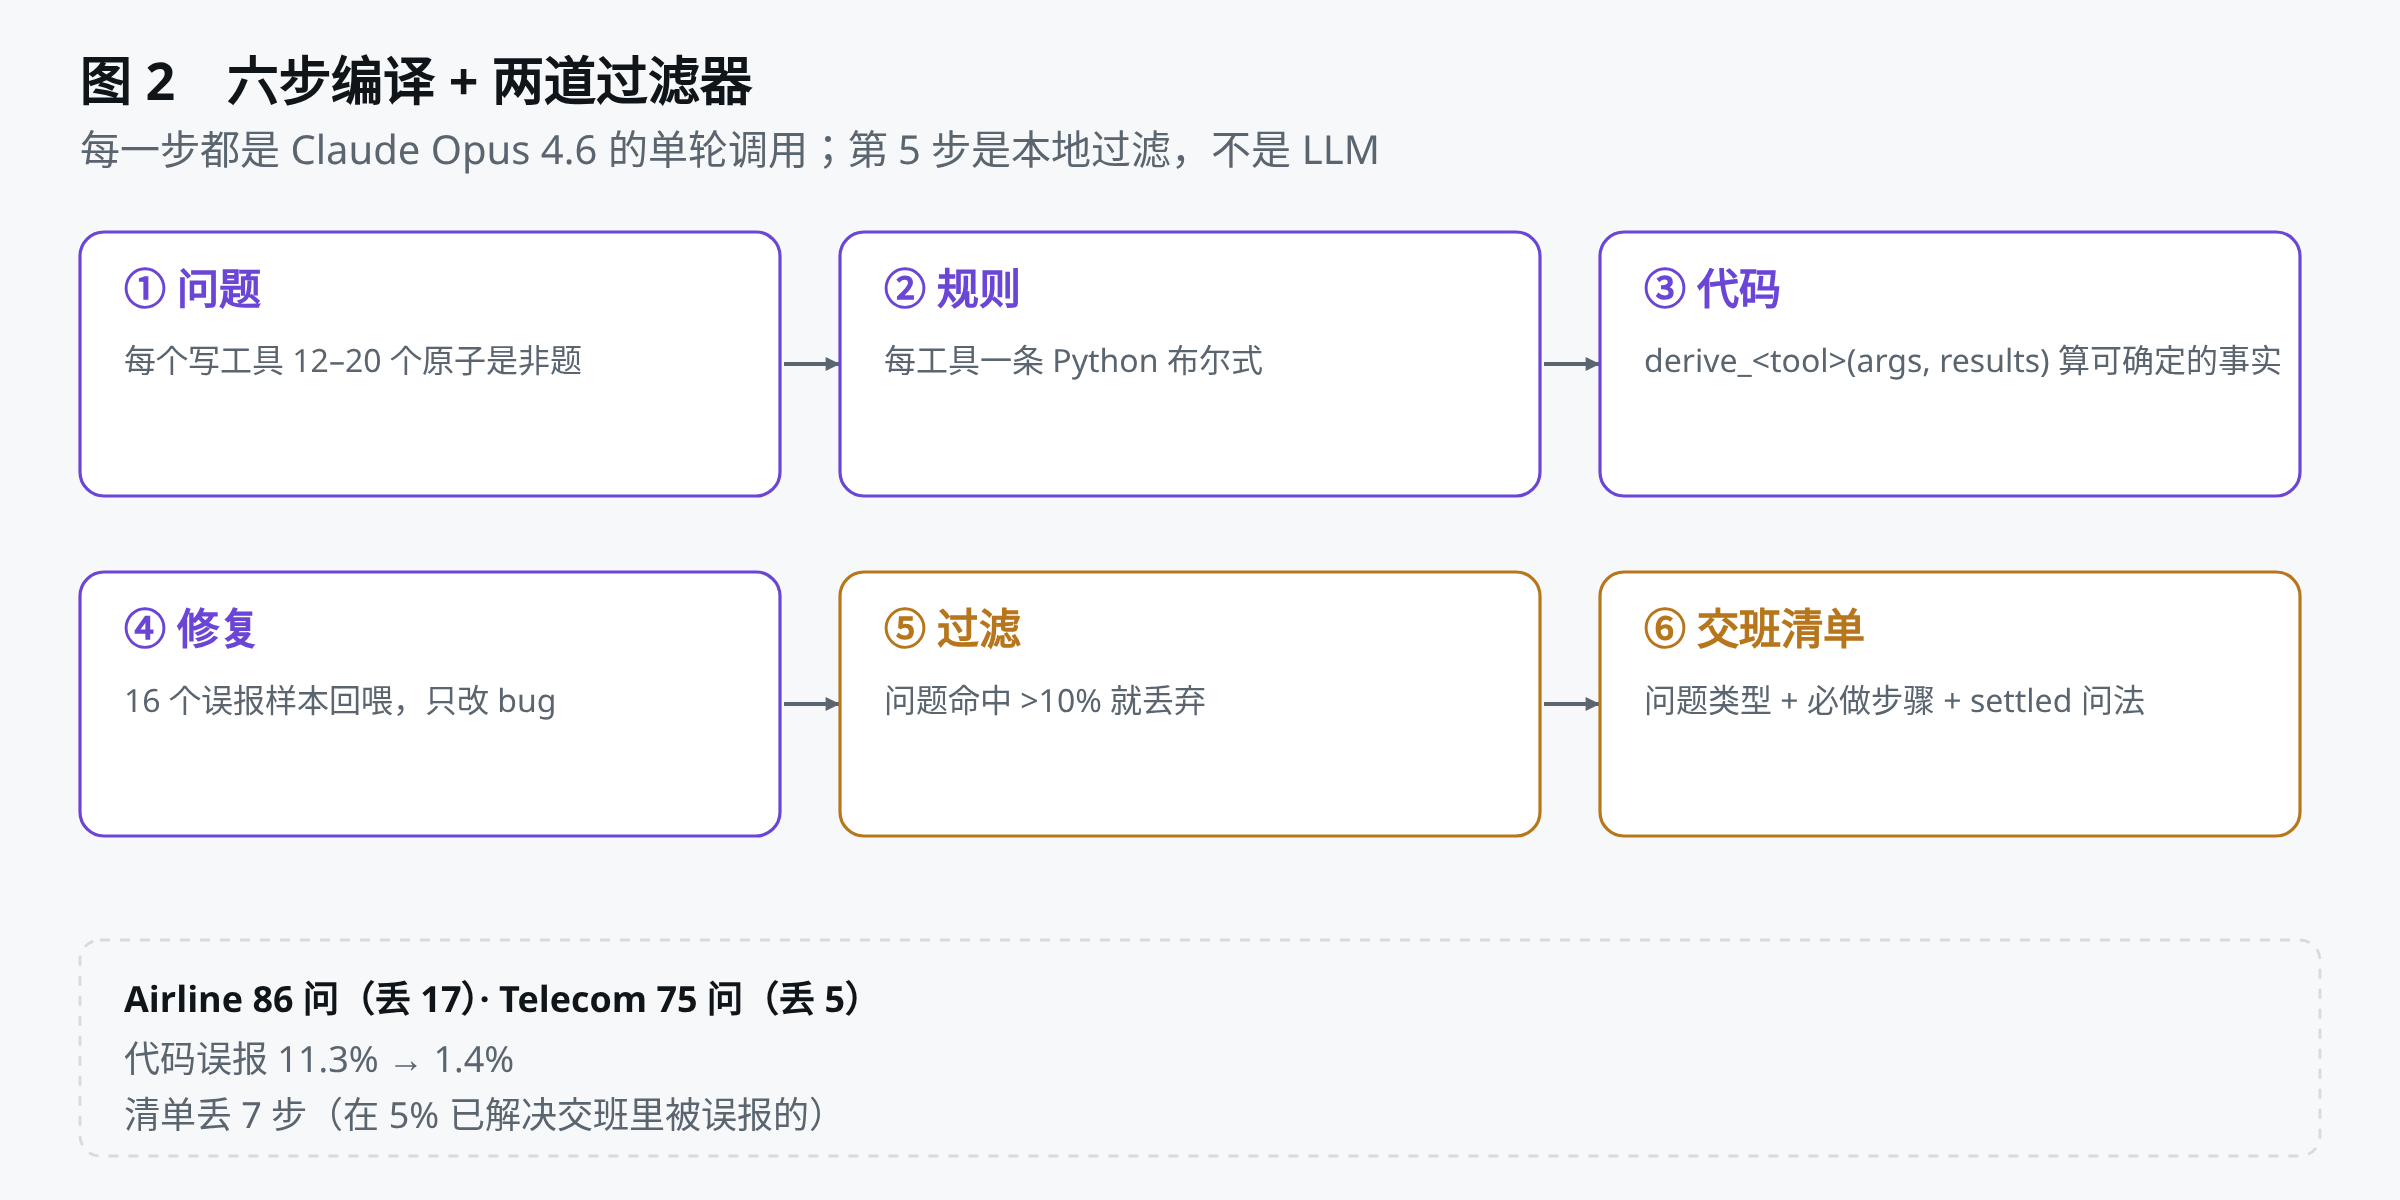
图 2 第 5 步是本地过滤,不是 LLM 调用;两道过滤器的阈值只在 Airline 上定过一次,之后复用。
| 步骤 | 读什么 | 产出 | 需要标签? |
|---|---|---|---|
| 1 问题 | 策略、写工具 schema | 每个写工具 12-20 个原子是非题 | 否 |
| 2 规则 | 策略、第 1 步的问题 | 每个工具一条 Python 布尔式 | 否 |
| 3 代码 | 策略、schema、每个读工具一条示例结果 | derive_<tool>(args, results) | 否 |
| 4 修复 | 日志上被代码报违规的调用(每工具最多一条) | 修好的代码 | 否 |
| 5 过滤 | Kev 在日志调用上的回答 | 要丢弃的问题 | 否 |
| 6a 前置步骤(仅 Telecom) | 策略、工具名 | 前置条件 | 否 |
| 6b 交班清单 | 策略、前置条件、Kev 的日志回答 | 问题类型 + 步骤 | 是(结果标签) |
4.1 为什么强调“原子”
编译 prompt 里对判官有个很具体的描述,一个只能读、不能算的小模型。所以每个问题只能测一个事实,且必须能从对话回答;参数用占位符({reservation_id}),运行时由代码填上真实值。prompt 还明确不许让判官做算术。算术交给第 3 步。
Airline 上这一步产出 86 个问题(六个写工具,每个 12-21 个),Telecom 75 个(表 1)。举一个 cancel_reservation 的片段。
reservation_id_correct,{reservation_id}是否与工具结果确认过的、属于该用户的订单号一致?no_flown_segments,按工具结果,这段行程是否有零个航段已经飞过?cancellation_eligible_24hr,按工具结果,这单是否在 24 小时内创建?at_least_one_cancel_condition_met,是否满足至少一个取消条件(24 小时内、航司取消、商务舱、保险覆盖)?user_requested_cancellation,用户真的要求取消了,还是只是询问?user_confirmed_cancellation,agent 是否列出取消详情、用户是否明确确认过?
每个问题都带 bad_if,哪个答案意味着“违规”。这样门在运行时知道极性,而不是靠问题措辞猜。
4.2 为什么问题列表不够
策略里的“满足任一条件即可”是或关系,独立问题表达不了。第 2 步让模型写出一个布尔表达式,cancel_reservation 编译出来是。
1user_id_obtained and reservation_id_correct and reservation_retrieved
2and no_flown_segments and cancellation_reason_obtained
3and at_least_one_cancel_condition_met
4and user_requested_cancellation and user_confirmed_cancellation
注意它保留了“至少一个条件满足”这个汇总问题,而把四个单条件问题去掉了。因为它们已被汇总覆盖。运行时每个 id 在没有“置信的否”时视为 true,表达式用无 builtins 的 eval 求值。
4.3 代码只报记录能确定的违规
derive_<tool> 拿两个参数,提议的 args,以及更早的每一次工具调用与结果 results。它返回算出来的事实,外加一个 violations 列表。
约束很严。
- 只用标准库(
json、math、datetime),执行时白名单 builtins; - 抛异常一律视为没有违规。宁可放过,不可误杀;
- 只有当记录本身能确定违规时才写进
violations;如果缺记录、或者规则取决于用户说了什么,就留给判官。
一个真实例子(update_reservation_baggages)。
1free_per_pax = _free_bags_per_passenger(membership, cabin)
2total_free = free_per_pax * num_passengers
3expected_nonfree = max(0, new_total - total_free)
4if new_nonfree != expected_nonfree:
5    violations.append(
6        f"nonfree_baggages should be {expected_nonfree} "
7        f"({membership}, {cabin}, {num_passengers} passenger(s): "
8        f"{total_free} free; new total {new_total}), call has {new_nonfree}")
4.4 一轮修复,只改 bug
第 3 步的代码会在训练任务的日志上跑,把被报违规的调用(每工具最多一条,共最多 16 条)连同它读过的记录一起回喂给编译器。不告诉它对错标签,只让它判断“这条违规是真的吗”,然后改代码。
这一轮把留出集上的误报率从 11.3% 降到 1.4%(对正确写调用而言,附录 A.1 第 4 步)。典型 bug 很具体,把 "Error: User not found" 这类错误字符串当成用户记录读;用了被后续工具结果推翻的旧记录。
4.5 丢掉判官读不出来的问题
Kev 在开发日志的每一次写调用上回答全部问题。如果某个问题在某工具上超过 10% 的调用里给出“置信的违规”,就丢掉它。真违规是稀少的,一个频繁触发的问句多半是“判官读不出来”或者“策略没要求”。
丢掉的按 Airline 的阈值定一次,之后不改,Airline 丢掉 86 里的 17 个,Telecom 丢掉 75 里的 5 个(175 次日志写调用,附录 A.1 第 5 步)。被丢的问题永远不再报告,并在规则里视为 yes。
4.6 一条关键的编译指令
交班检查要回答的是“agent 是不是放弃得太早”。所以编译产物是,策略里覆盖的问题类型,以及每个问题在放弃前必做的步骤;每个步骤带一个 settled 问法。“这一步是被试过、被验证,还是被排除了?”
编译 prompt 里最重要的一句是。
对话里从没讨论过的条件,不算“已排除”。
没有这句,“开漫游”会被编译成“……或者用户不在旅行”。看起来已经了结,其实没人问过用户是否在旅行。有了这句,它会单独成为一个步骤,先问用户是否在旅行。
清单的过滤器不一样,在已解决的交班里被误报超过 5% 的步骤要丢掉(因为正确的交班本来就该通过)。做法与统计口径见附录 A.1 第 6 步。用 74 个训练任务里的 217 次交班(其中 36 次发生在已解决回合)定下阈值,丢掉 7 个步骤,飞行模式、APN 设置、SIM 状态、线路停机、欠费、合约到期日、缴费后恢复线路。
五、写门的三种证据与一个阈值
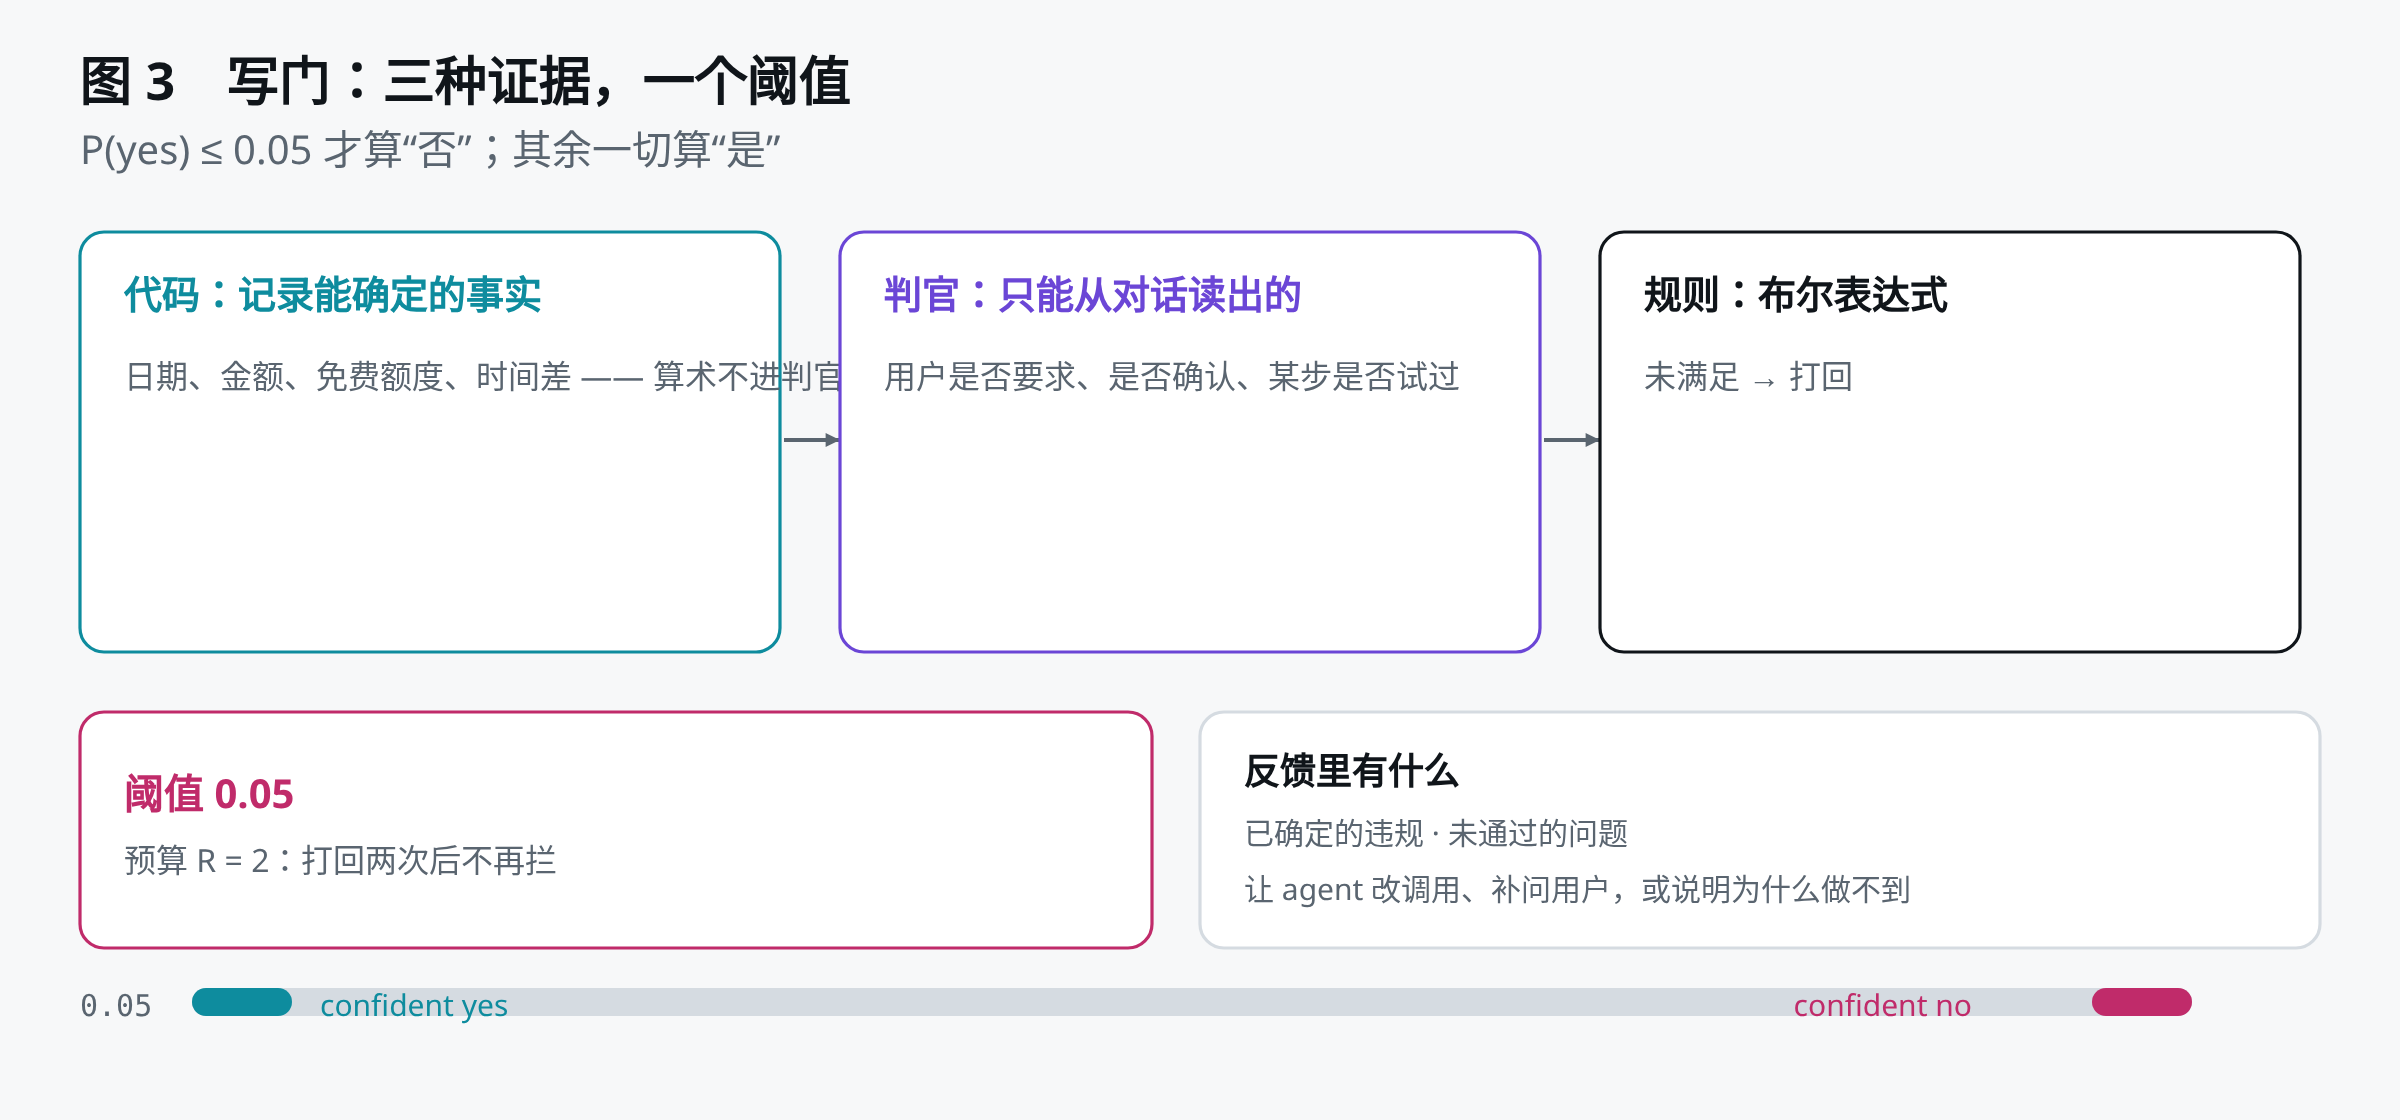
图 3 只有 P(yes) ≤ 0.05 才算“否”;反馈告诉 agent 该改调用、该问用户,还是该说明做不到。
每次写调用前三步(§3.5)。
- 代码。读提议的参数和更早的结果,返回记录能确定的违规。
- 判官。Kev 回答该工具的问题,输入是策略、对话、工具结果(日期标注为相对当前时间的偏移,选项列表预先排好序)与提议的调用。
- 规则。代码有违规,或布尔式不被满足 → 打回。
只有 P(yes) ≤ 0.05 才计为“否”,其余一律计为“是”。这是一个保守的默认。门倾向于放过,而不是误杀。原文也承认这些概率不保证标定,所以要在循环里验证(§3.1、§3.5)。论文没有假装这是标定好的概率,而是把它当成一个要在 agent 循环里验证的工程选择。
被打回时,反馈列出“已确定的违规”和“没通过的问题”,并要求 agent 三选一,改正调用、向用户补问缺的信息、或者解释为什么这个请求无法完成。如果 agent 坚持认为调用是对的,可以再提交一次;第二次被打回后,反馈会直接要求它去回复用户,不要再调工具。
在 Airline 上,门其实很少出手,Opus 4.6 平均每次运行只打回 0.08 次,Qwen3.8-27B 只有 0.03 次(§5 与附录表 9)。
六、交班检查
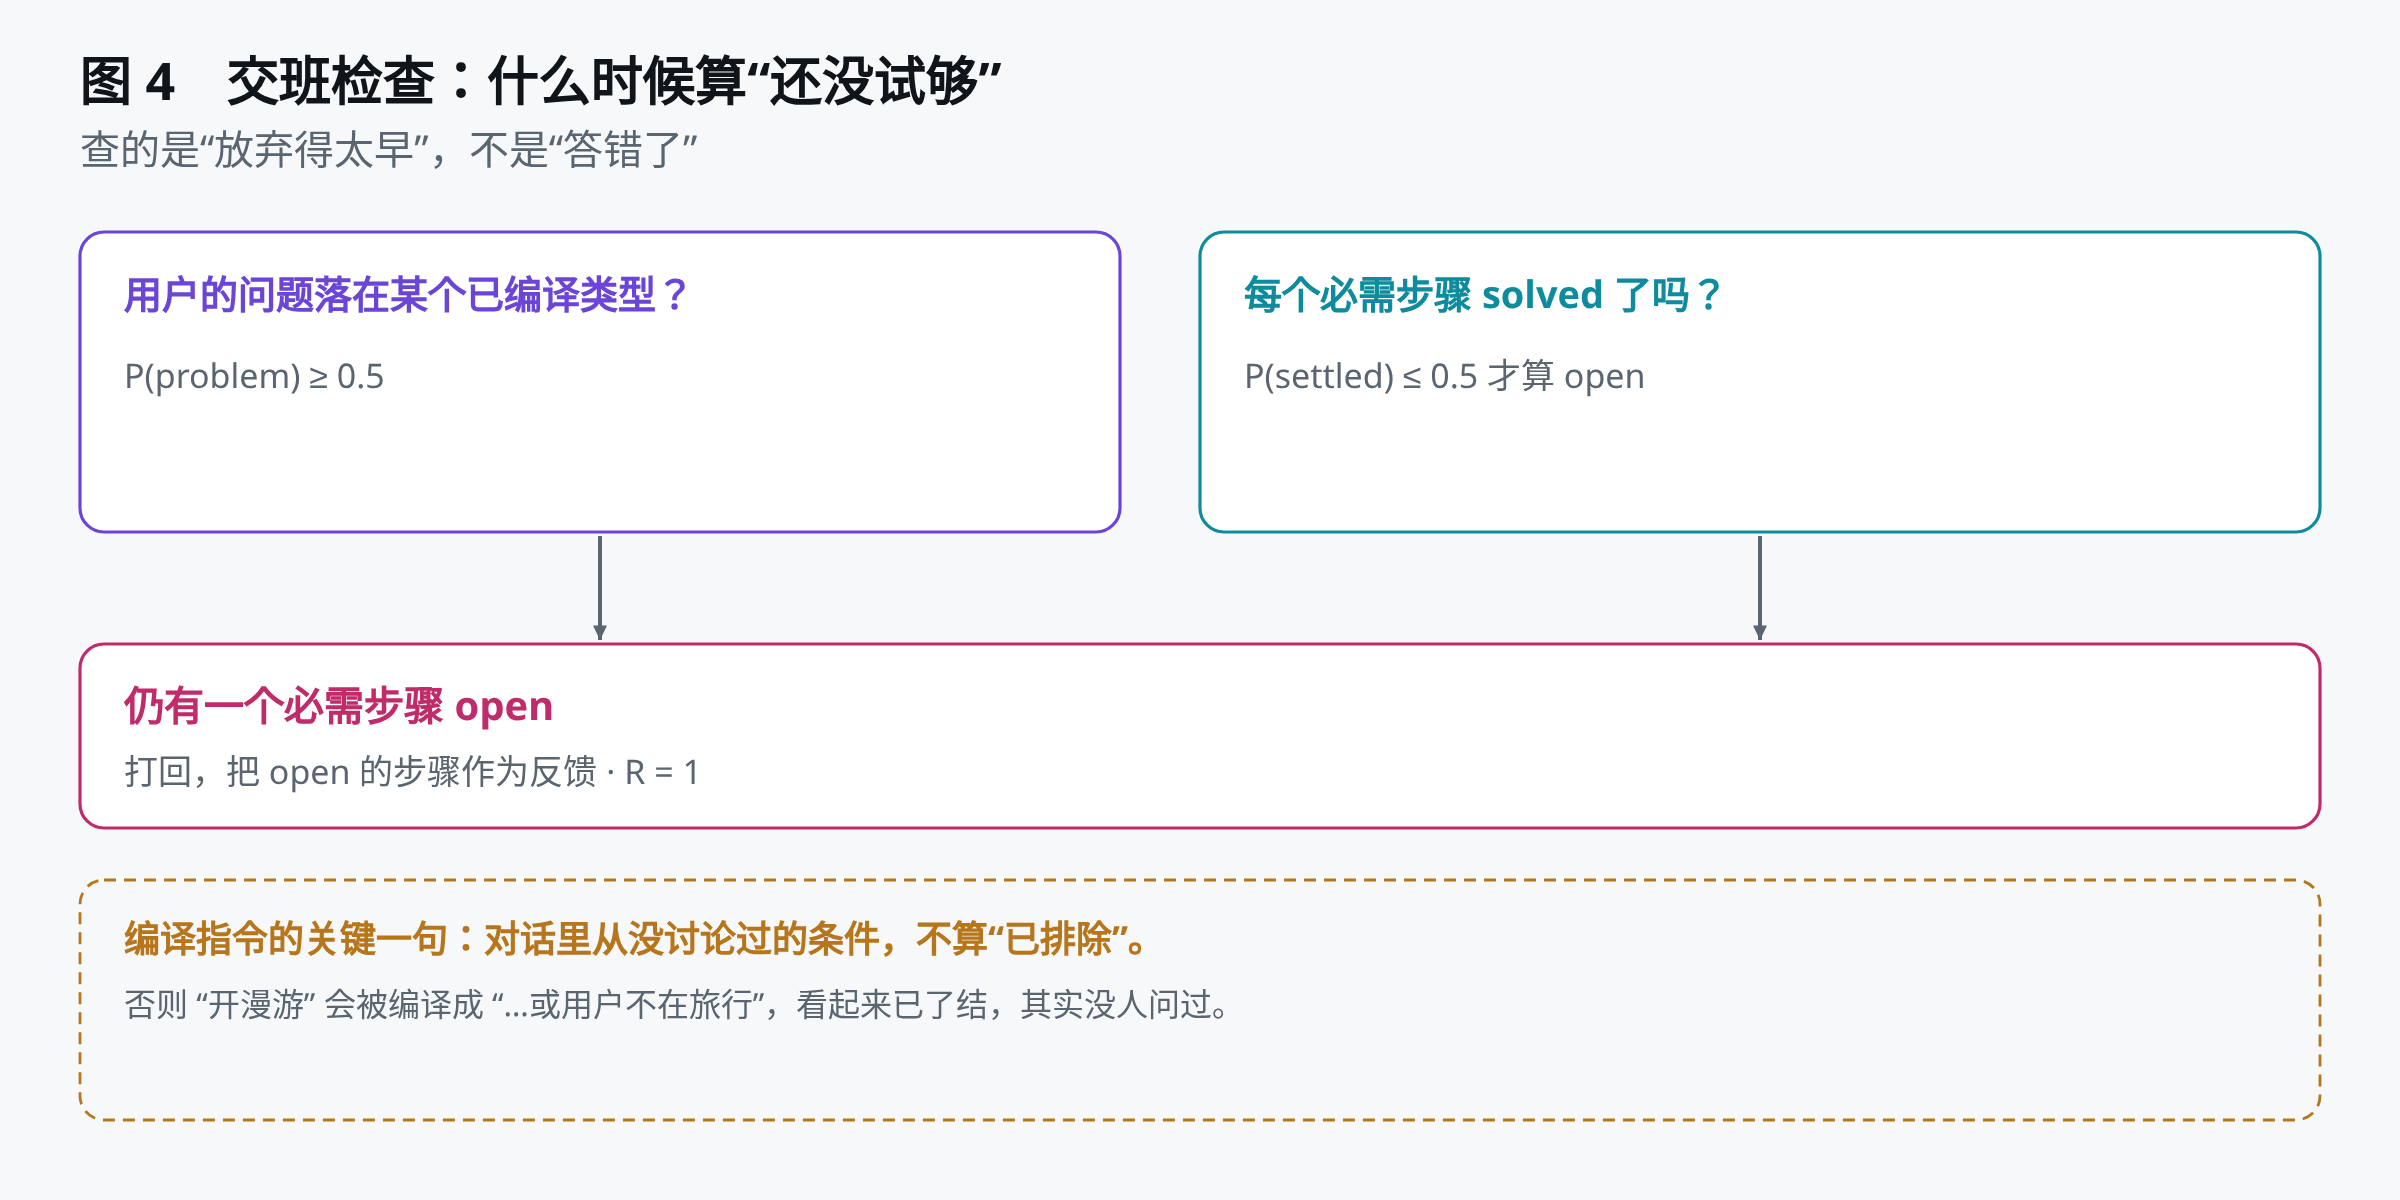
图 4 先判问题类型,再判每个步骤是否 settled;有一个必需步骤 open 就打回。
触发条件有两类,转人工的调用,以及**“我帮不了你”这类认输话术**(先用关键词筛出候选,再由判官确认)。
一次请求里,Kev 同时回答三件事,用户的问题属于哪个已编译类型(或“其他”)、用户是否说问题已解决、每个步骤的 settled 问法。
判定规则。
- 步骤必需。P(problem 需要它) ≥ 0.5;
- 步骤open。P(settled) ≤ 0.5;
- 问题没解决,且至少一个必需步骤 open → 打回,把 open 的步骤作为反馈。
交班检查只允许一次改(R = 1),而且只在 Telecom 启用。Airline 上关掉它是有依据的,离线测试里,它会把 26% 本已解决的回合里的交班打成违规(§4.5)。
七、没有策略时的两个通用检查
BFCL multi-turn 没有书面策略,用户轮次也是固定的,所以不能编译。原文按 BFCL 自己的调用循环跑,不写 system prompt,每个用户轮次最多 20 步(§4.1)。JevAct 在这里用两个通用检查。
- 回合结束检查(end-of-turn),当 agent 要结束这一轮,而工具报的需求类错误(措辞里有 “needs to”“must”)还没解决时触发。Kev 从工具列表里选出满足该需求的工具,或选 none;某个工具概率 ≥ 0.6 时,反馈直接要求 agent 去调它,而不是回头问用户。
- 请求校验(requested-action gate),每次状态变更调用之前,问“用户要求过这个动作吗,或者工具错误要求过吗”。P(yes) ≤ 0.05 就判为“未被请求”,反馈要求 agent 只做被要求或被要求补做的事。
八、实验设置
| τ²-bench Airline | 50 个任务,考策略合规的写调用(订票、取消、改签);按 τ²-bench 自己的口径打分,看最终数据库状态与必需沟通(§4.1) |
| τ²-bench Telecom | 114 个任务的 base split,考排障;主要失败是过早放弃 |
| BFCL multi-turn | 800 条,四类各 200(base、missing function、missing parameter、long context) |
| 用户模拟器 | GPT-4.1(与 τ²-bench 一致),temperature 0(§4.1) |
| Agent LLM | 11 个:GPT-4.1、Opus 4.6、gpt-oss-20b、gpt-oss-120b、Qwen3.8-27B、DeepSeek-V4-Pro(三者全测);Haiku 4.5、Opus 5.5(仅 Telecom);Llama 3.3 70B、Mistral Small 3.2 24B、Gemma 4 31B(仅 BFCL) |
| 对照 | 同一模型两臂只差 harness;agent 的 4096 输出 token、温度 0 |
| 判官/编译器 | Kev-27B 直接使用,全实验同一配置;Claude Opus 4.6 做离线编译 |
指标说明很重要。
- pass@3,三次里至少一次成功的任务比例;
- pasŝ3,三次全部成功的任务比例(可重复性);
- pasŝ1,单次运行的平均成功率。
主结果每任务跑三次,指标定义见 §4.4。单次试验的消融只看 pasŝ1,所以消融之间的差异要谨慎读。
九、主结果
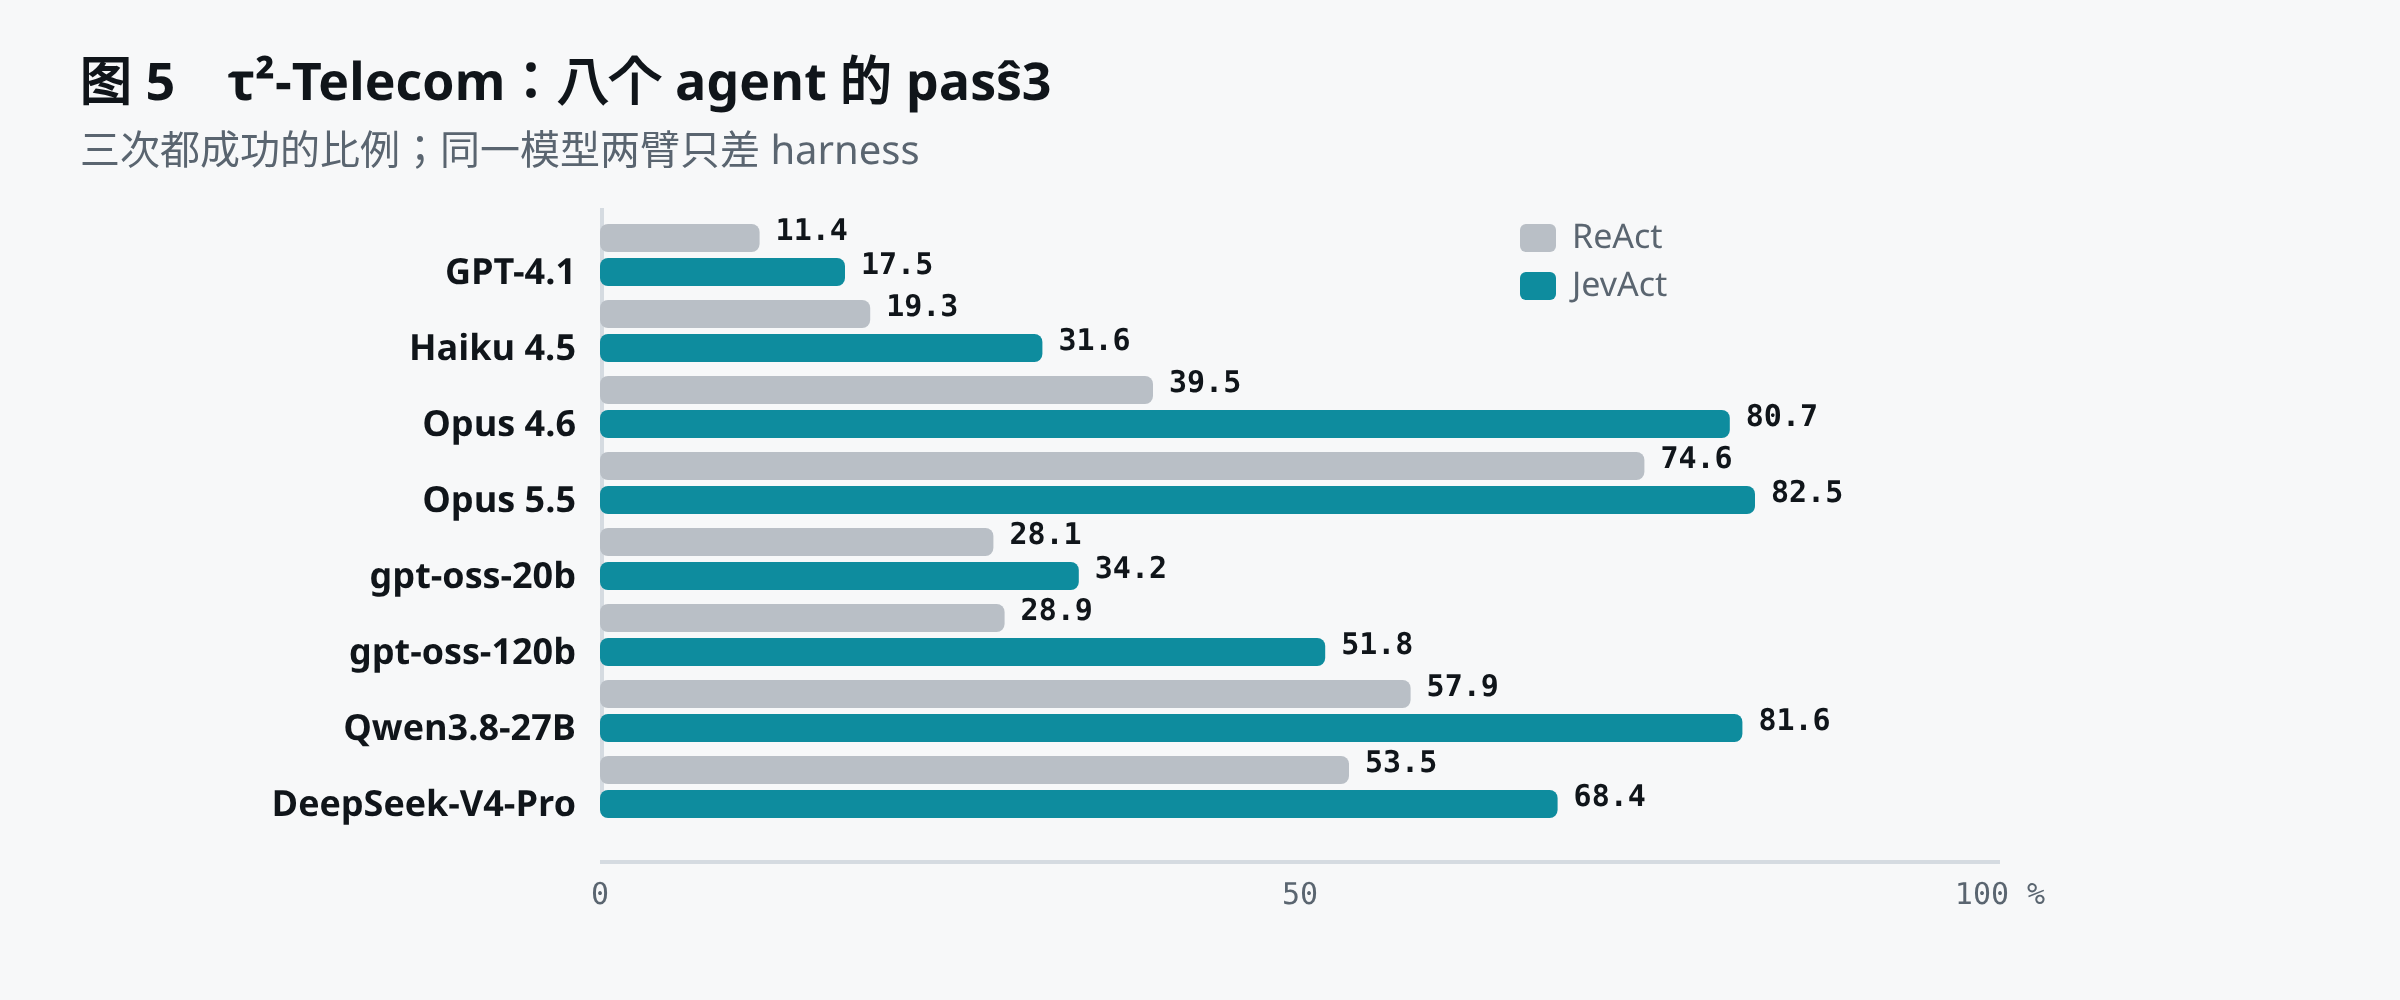
图 5 Telecom 上八个 agent 全部提升,Opus 4.6 从 39.5% 到 80.7%。数据来自论文表 2。
9.1 Telecom 上最一致的一组
八个 agent 两个指标全部改善,平均 pass@3 +16.0 个百分点、pasŝ3 +16.9 个百分点(表 2、图 1)。
| Agent | pass@3 ReAct → JevAct | pasŝ3 ReAct → JevAct |
|---|---|---|
| GPT-4.1 | 45.6 → 83.3 | 11.4 → 17.5 |
| Haiku 4.5 | 47.4 → 69.3 | 19.3 → 31.6 |
| Opus 4.6 | 72.8 → 100.0 | 39.5 → 80.7 |
| Opus 5.5 | 99.1 → 100.0 | 74.6 → 82.5 |
| gpt-oss-20b | 83.3 → 92.1 | 28.1 → 34.2 |
| gpt-oss-120b | 78.9 → 93.9 | 28.9 → 51.8 |
| Qwen3.8-27B | 91.2 → 98.2 | 57.9 → 81.6 |
| DeepSeek-V4-Pro | 86.8 → 96.5 | 53.5 → 68.4 |
连最强的 ReAct 基线(Opus 5.5,pasŝ3 74.6%)也涨到 82.5%(§5)。这个模式与“交班检查针对的是常见失败模式(过早放弃)”一致。但论文自己也提醒,这里比较的是整个 harness,并没有单独隔离交班检查的贡献。
9.2 Airline 上小而混合
看 pass@3,六个 agent 里四个改善、一个持平、一个下降。看 pasŝ3,四个改善、两个下降。GPT-4.1 的 pass@3 从 66.0 到 82.0,Opus 4.6 从 84.0 到 92.0。
读这组数字时记住两件事,50 个任务意味着一个任务就是 2 个百分点;写门在这几个 agent 上出手极少(0.03-0.08 次/运行)。
9.3 BFCL 可重复性变好,覆盖面没变宽
九个 agent 的 pasŝ3 全部提升(+0.1 到 +9.6 个百分点),但 pass@3 四个上升、五个下降(0.2 到 3.6 个百分点)。
这是一个容易被误读的地方,“三次都成功”变多,不等于“能解的任务变多”。更合理的解释是,门让某些任务上的表现更稳定,而不是扩大了能力边界。
十、三个反直觉的消融发现
10.1 代码检查的贡献大于判官
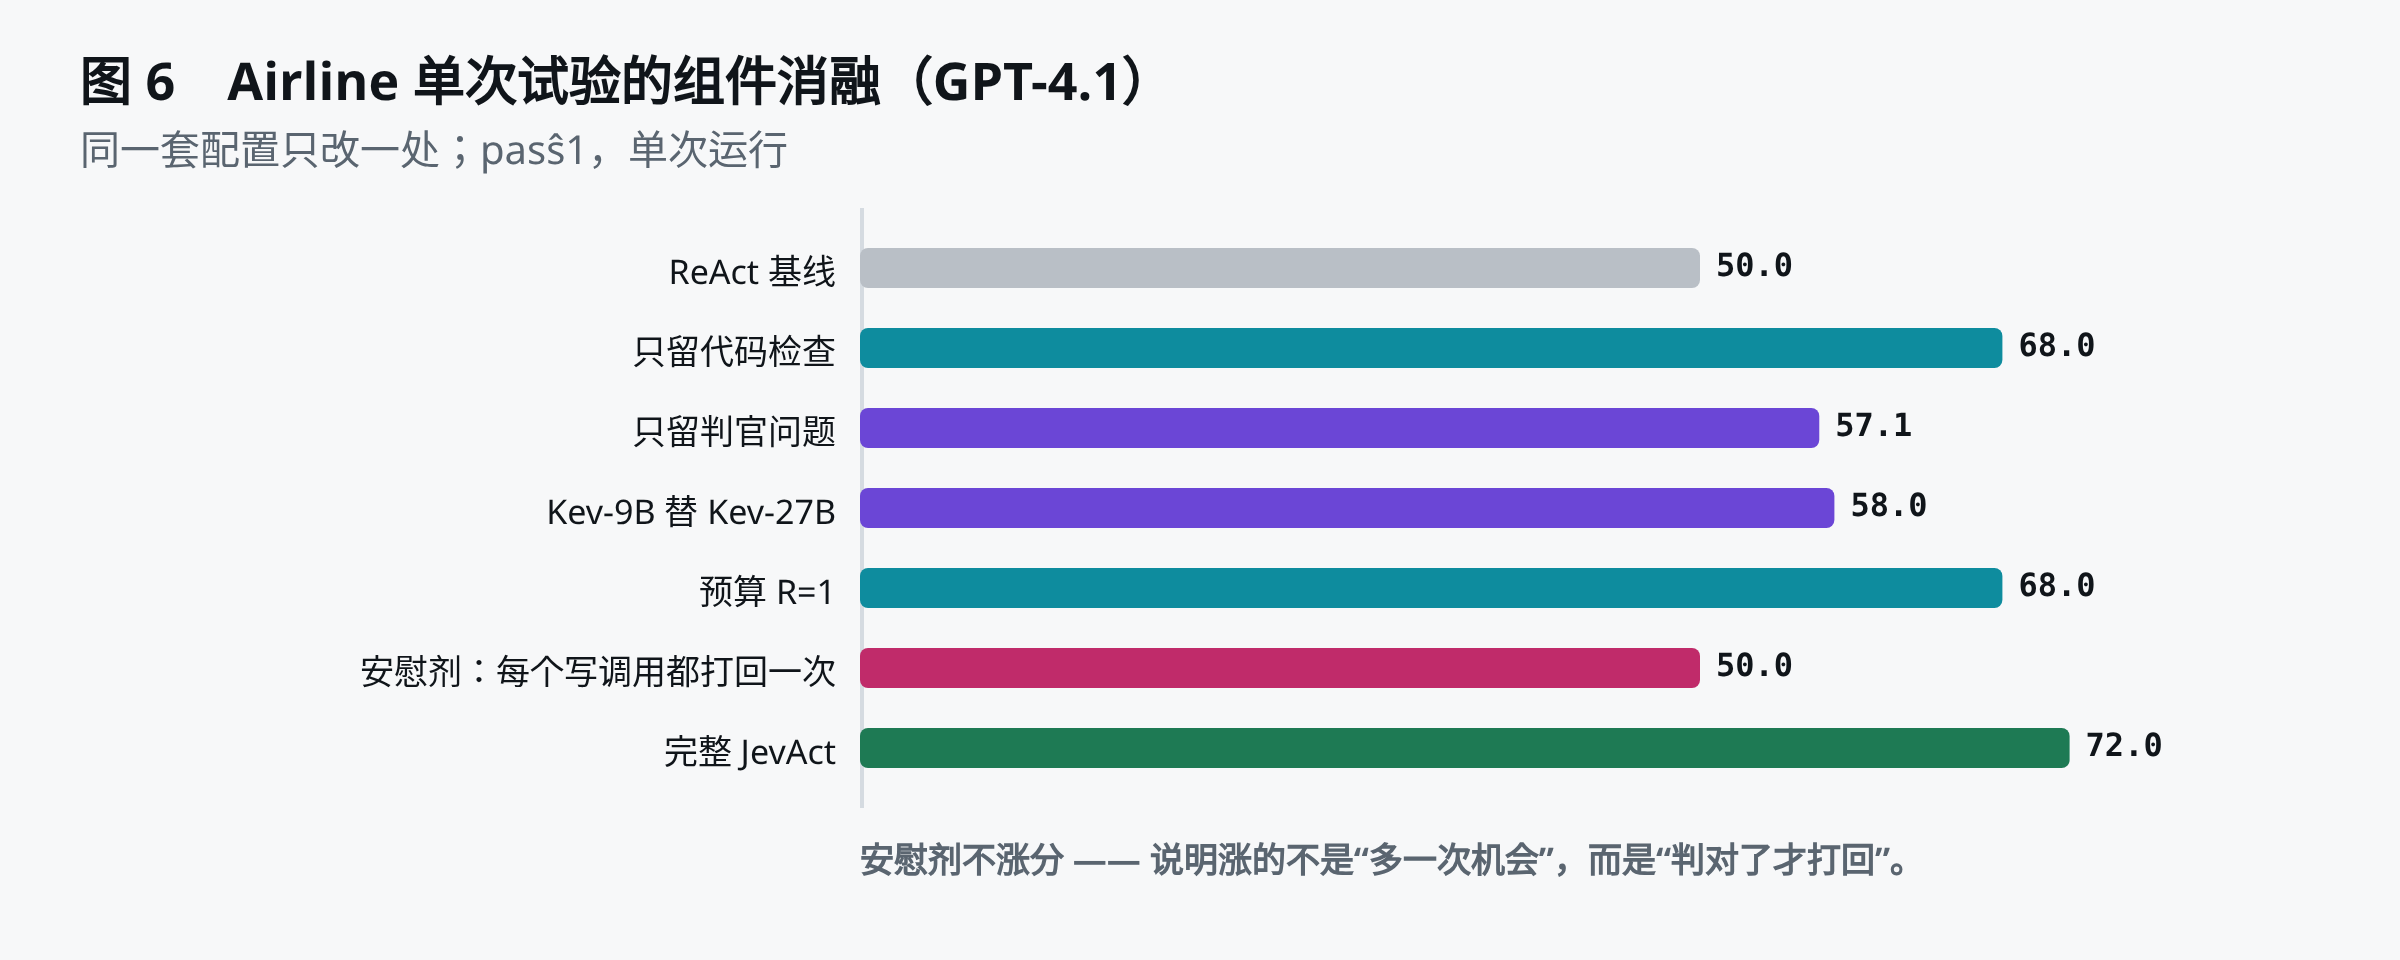
图 6 同一配置只改一处,pasŝ1。数据来自论文表 3。
| 配置 | pasŝ1 | 每任务打回次数 |
|---|---|---|
| ReAct | 50.0 | - |
| 完整 JevAct | 72.0 | 0.38 |
| 只留代码检查 | 68.0 | 0.28 |
| 只留判官问题 | 57.1 | 0.29 |
| 换 Kev-9B | 58.0 | 0.22 |
| 预算改成 R=1 | 68.0 | 0.32 |
| 安慰剂:每个写调用都打回一次 | 50.0 | 1.00 |
三点。
- 可执行的状态检查贡献了大部分收益(68.0),单靠判官问题只有 57.1。
- 换小判官会掉(58.0),说明判官的选择在这个设置里确实重要。
- 安慰剂完全没有收益。每个写调用无条件打回一次,还是 50.0。也就是说,起作用的是“判对了才打回”这件事,多给一次机会本身不值钱。
不过第 3 点有个重要的补丁,换 gpt-oss-120b 当 agent 时,同样的“无条件重检”就能把 pasŝ3 从 32.0 拉到 42.0,与完整门相同;换成按门的比例随机打回,也一样。也就是说,判官的裁决是否值钱,取决于 agent。对 GPT-4.1,完整门 40.0 对方无条件是 28.0(配对 95% CI,+2.0 到 +26.0 点);对 gpt-oss-120b,两者打平。
10.2 判官换谁都能提升,但成本差一到两个数量级
表 4 在 Airline 上把同一个写门换成各种判官(§5.1)。
| 判官 | 类型 | GPT-4.1 pasŝ1 | 每题成本 |
|---|---|---|---|
| ReAct 基线 | - | 53.3 | - |
| Qwen3.8-27B | 开源 LLM 27B | 68.0 | $0.0027 |
| Gemma-4-31B | 开源 LLM 31B | 72.0 | $0.0040 |
| Claude Haiku 4.5 | API | 72.0 | $0.0156 |
| GPT-4.1 | API | 67.3 | $0.0231 |
| Kev-0.8B | 决策模型 | 66.0 | $0.0003 |
| Kev-9B | 决策模型 | 63.3 | $0.0008 |
| Kev-27B | 决策模型 | 72.0 | $0.0017 |
所有“有判官”的配置相对各自 ReAct 基线都提升 9.4-18.7 个百分点,说明这套框架并不押注在某一种判官架构上。Kev 的位置是性价比。与生成式判官同档的成功率,成本低一个到两个数量级。
10.3 更大的判官不一定更好
表 5 把判官从 27B 换成 9B、0.8B(检查、阈值、丢弃清单都不动,§5.1)。
- Airline 上 GPT-4.1 确实偏好 27B(65.3 vs 59.3 / 58.0),但其余 agent 没有一致偏好;
- Telecom 上更小的判官经常追平甚至超过 27B,Opus 4.6 从 93.6 涨到 99.1(9B),DeepSeek 从 85.7 到 98.2(9B);
- 离线回放 609 个完全相同的交班状态,Kev-9B 与 Kev-27B 的决策一致率 97.0%,Kev-0.8B 90.6%。
为什么会这样?作者给了两条机制性解释。
- 输入长度。0.8B/9B 只验证到 8192 token,27B 到 65536。Airline 上 41% 的写检查输入超过 8192,Telecom 的交班输入只有 4% 超。长输入上 Kev-9B 的 AUROC 是 0.61,27B 是 0.85。
- 阈值校准。把 Kev-9B 的阈值从 0.05 调到 0.10(短输入),抓到的坏调用从 8 个升到 16 个(27B 是 21 个),误报不增加。
所以更准确的说法是,判官的选择要同时看上下文长度、阈值和验证任务的类型,而“更大的模型更好”只是一个粗略的近似。下线任务成功率还取决于 agent 怎么响应反馈,所以不能把表 5 读成“判官准确率排名”。
十一、代价
表 9 给了 token 用量(每运行,千 token,附录 A.5)。
- agent 侧基本不变。Airline 上 GPT-4.1 从 58.4k 到 60.1k 输入;Telecom 上因为打回更多,输入涨 10-35%(GPT-4.1 130.6k → 167.3k)。
- 判官侧很小。Kev 输入 3.2k-24.1k/运行,取决于 benchmark 与 agent。
- 打回次数。Airline 0.03-0.39,Telecom 0.10-1.91,BFCL 0.02-0.13。
自托管判官的延迟(A100-80GB,bf16,四并发,附录 A.6),Kev-0.8B 0.53 s、Kev-9B 1.22 s、Kev-27B 2.72 s、Qwen3.8-27B 4.02 s、Gemma-4-31B 6.10 s(每秒请求)。成本按 $2/GPU 小时、满载估算,且只算判官,不含 agent 自身的推理、用户模拟器与一次性编译(附录 A.6)。
十二、论文自己写明的四件事
这一段是全文最值得细读的部分。
- 对用户模拟器敏感。把 Telecom 的用户模拟器从 GPT-4.1 换成 gpt-oss-120b,增益消失。pasŝ3 变化 −1.8 个百分点(95% CI −7.9 到 +4.4)。也就是说,Telecom 上的一致性提升与“模拟用户的行为”有关系。
- 问题编码的是策略,不是意图。在 260 个带标签的开发写调用里,101 个是错的,其中 42 个不违反任何已编译的问题。因为问题来自策略,而错误来自“用户到底想要什么”。
![图 7 门槛在哪 代价、判断力、覆盖缺口]()
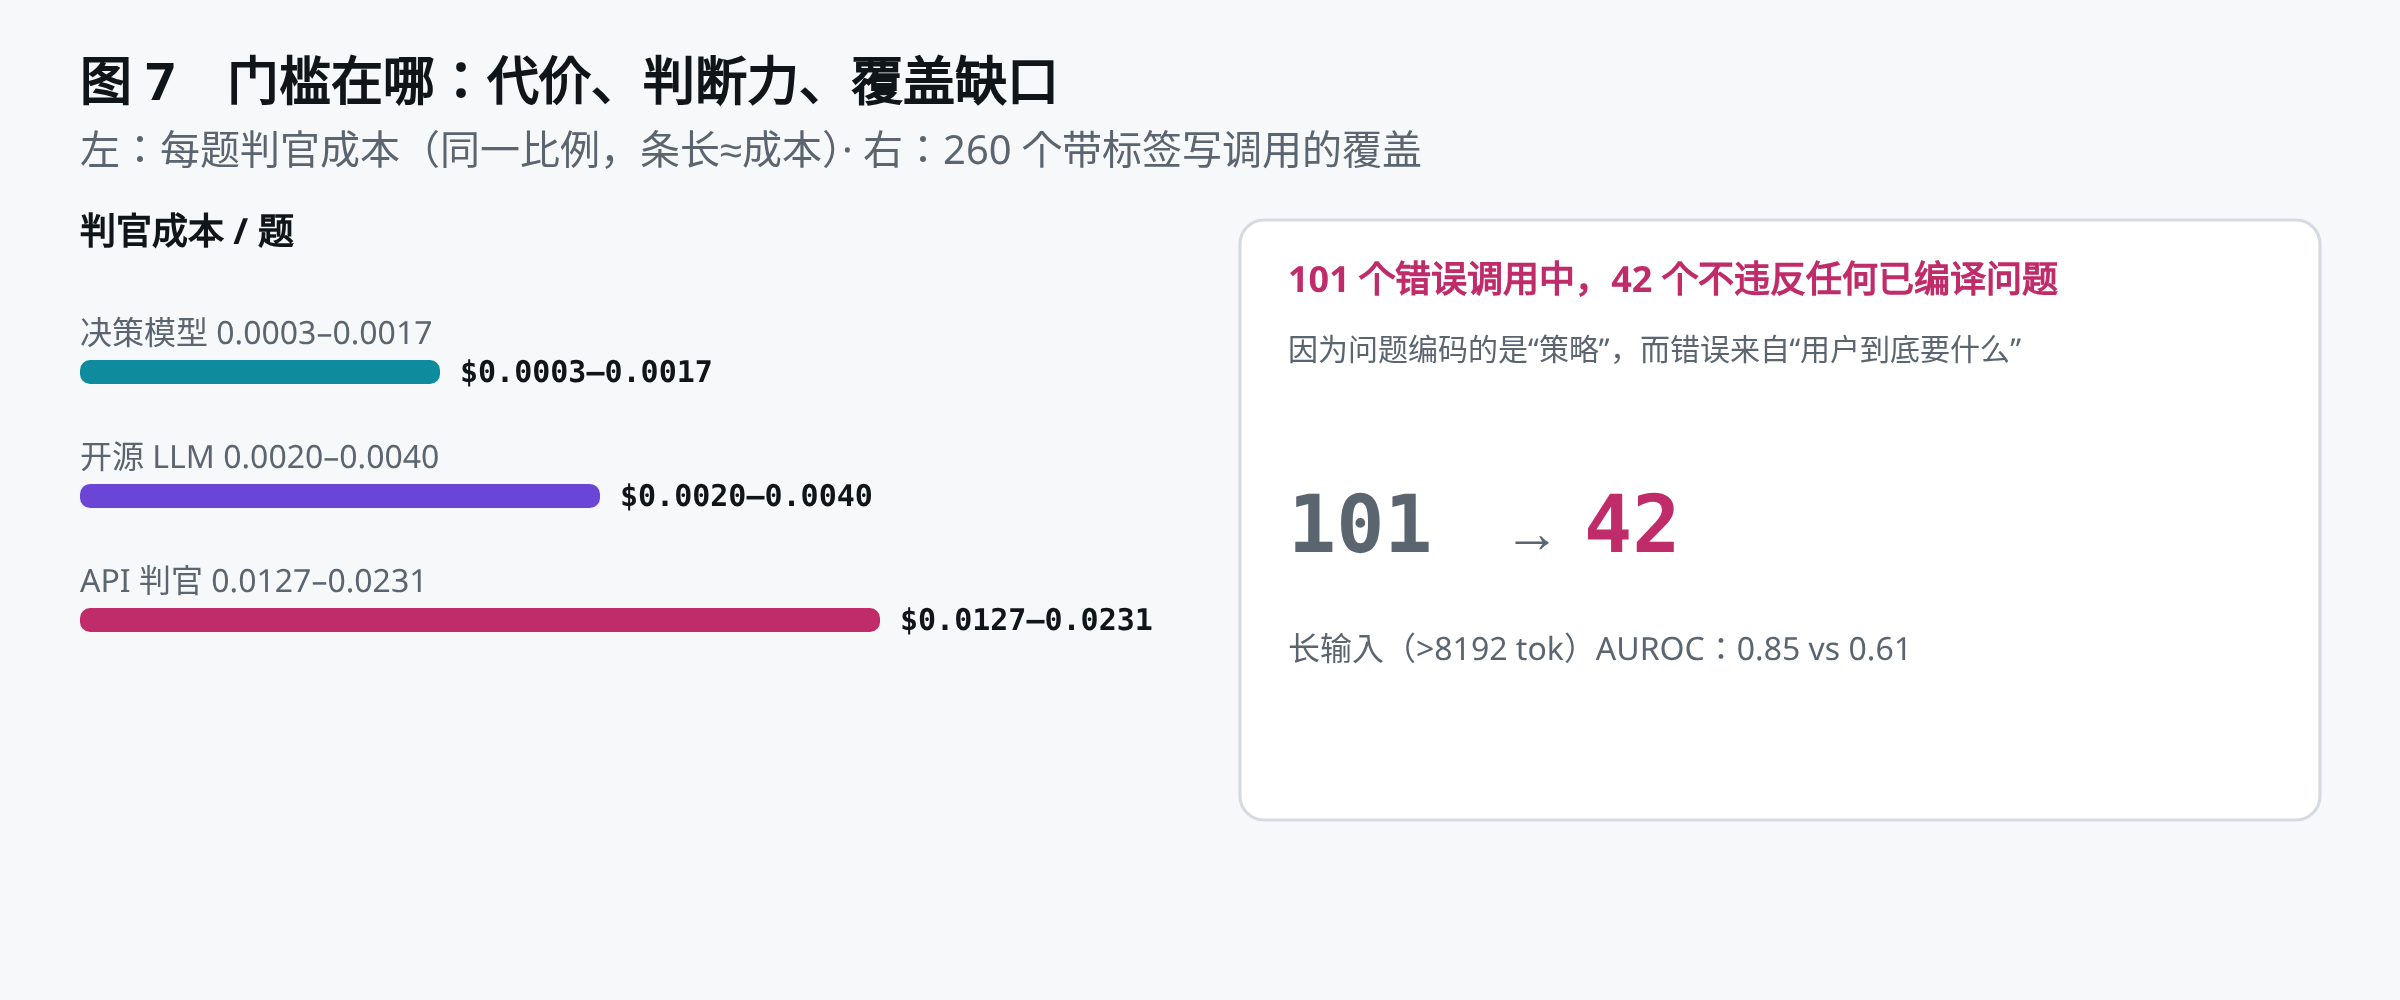
图 7 判官成本比生成式低一到两个数量级;但 260 个带标签的写调用里,42 个错误调用不违反任何已编译问题。
- 消融是单次试验。表 3、表 4、表 5 的差异要谨慎读;主结果是三次运行。
- 评测的是整个 harness。包含编译的检查、反馈机会与预算,因此不能把结果归给判官单独的贡献。
还有两个工程依赖,编译用 Claude Opus 4.6,阈值与丢弃清单用 Kev-27B 在 Airline 上定死;换领域要重新编译。
十三、放在已有工作里看
| 一族 | 代表 | JevAct 的位置 |
|---|---|---|
| 测试期反馈 | ReAct、Self-Refine、Reflexion | 它们改“下一轮”,JevAct 查“这一条” |
| 运行期策略约束 | GuardAgent、Zwerdling 等、AgentSpec、ShieldAgent、CUGA、ToolSafe、PolicyGuard、PolicyGuide、ToolFence、CaMeL | 同样在执行前介入;JevAct 强调固定选项决策模型 + 可执行状态检查的组合 |
| 生成式评审 | MT-Bench 式 LLM-as-a-judge、G-Eval | 它们评审已完成输出;JevAct 在执行前介入,且不生成解释 |
| 决策模型 | Jev / Kev;JevLoop | JevLoop 让决策模型选动作;JevAct 只让它验证别人的提案 |
十四、实践上怎么用
适合用的场景
- 动作不可逆、策略可写成条件(客服、订单、运维变更);
- 你能拿到工具 schema 和一段开发日志(编译和过滤都需要);
- 你愿意接受“保守阈值”,即宁可放过一些坏动作,也不误杀好动作。
不适合 / 需要额外工作
- 策略本身模糊、靠人判断的场合;
- 输入很长(>8k token)时用小的决策模型;
- 期望它替你想“用户到底要什么”。那 42/101 的缺口说明这条路走不通,得从意图层另加检查。
把门做成跨 harness 的通用接口(提案、工具状态、执行结果三样东西的统一表示);把编译、代码验证、阈值与预算的选择尽量自动化;评测里同时报端到端延迟、成本与安全结果。
参考
- Shoham, David, Akrabi, Bilgory, Levy, Marreed, Zeltyn, Shlomov. 《Think Before You Act》,副标题 Decision Gate for LLM Agents. arXiv 编号 2610.38620, 2026. 原文见 arXiv 页面,PDF 见 PDF。
- 相关,τ²-bench (Barres et al., 2025)、BFCL multi-turn (Patil et al., 2025)、ReAct (Yao et al., 2022)、Reflexion (Shinn et al., 2023)、Self-Refine (Madaan et al., 2023)、AgentSpec (Wang et al., 2026)、ShieldAgent (Chen et al., 2025)、ToolFence (Li et al., 2026)、Jev (TypeSafe AI, 2026)、Kev (Palmer, 2026)、JevLoop (ZJUNLP, 2026)。
配套视频,中文版与英文版各一支,逐节讲解这套门是怎么编译、怎么判、在哪里失效。