多教师蒸馏按 token 分账
TRL 的多教师在线蒸馏示例跑了 60 步,指令跟随拿了 20% 的 prompt,训练 token 只分到 1% 到 3%。Open-MOPD 那篇论文把这件事叫 token 预算错配,修完之后可回收的上限从 35.6% 提到 83.4%。
TRL 的多教师在线蒸馏示例跑了 60 步。指令跟随拿了 20% 的 prompt,训练 token 只分到 1% 到 3%,它是三科里唯一没学动的。Open-MOPD 那篇论文把这个现象叫 token 预算错配,修完之后可回收的能力上限从 35.6% 提到 83.4%。
片子一分五十八秒,中文配音,字幕烧在画面里。
一、六十步之后,只有一条线没动#
2026 年 11 月,Hugging Face 的 Sergio Paniego 把 Open-MOPD 放出的三个专家接到 TRL 的 AsyncDistillationTrainer 上。学生是 SmolLM3-3B 的 SFT 检查点,三个教师分别用 GRPO 在数学、代码、指令跟随上训过。跑 60 步,大约是论文训练量的百分之一。
训练日志里出现两件事。teacher_token_frac 显示指令跟随每步只拿到 1% 到 3% 的训练 token,而它在 prompt 里占 20%。teacher_jsd 显示学生到数学、代码两个教师的距离一路往下,到指令跟随那个几乎是一条平线。
评测端跟着这个形状走。
| 模型 | AIME24 | AIME25 | IFEval |
|---|---|---|---|
| MixSFT 起点 | 17.5 | 19.2 | 67.5 |
| 60 步 MOPD | 24.2 | 22.5 | 73.0 |
| 论文终版 | 19.2 | 25.0 | 75.8 |
AIME24 那一列有一处要说明。60 步的 24.2 比论文终版的 19.2 高,看着像短训赢了长训。每题只采四个样本,这个量级下几个点的差距在噪声里,读不出结论。稳的信号在 IFEval,起点 67.5,60 步到 73.0,离论文终版还差 2.8 个点,而它正是 token 最少的那一科。
二、三阶段配方,第三段只打分#
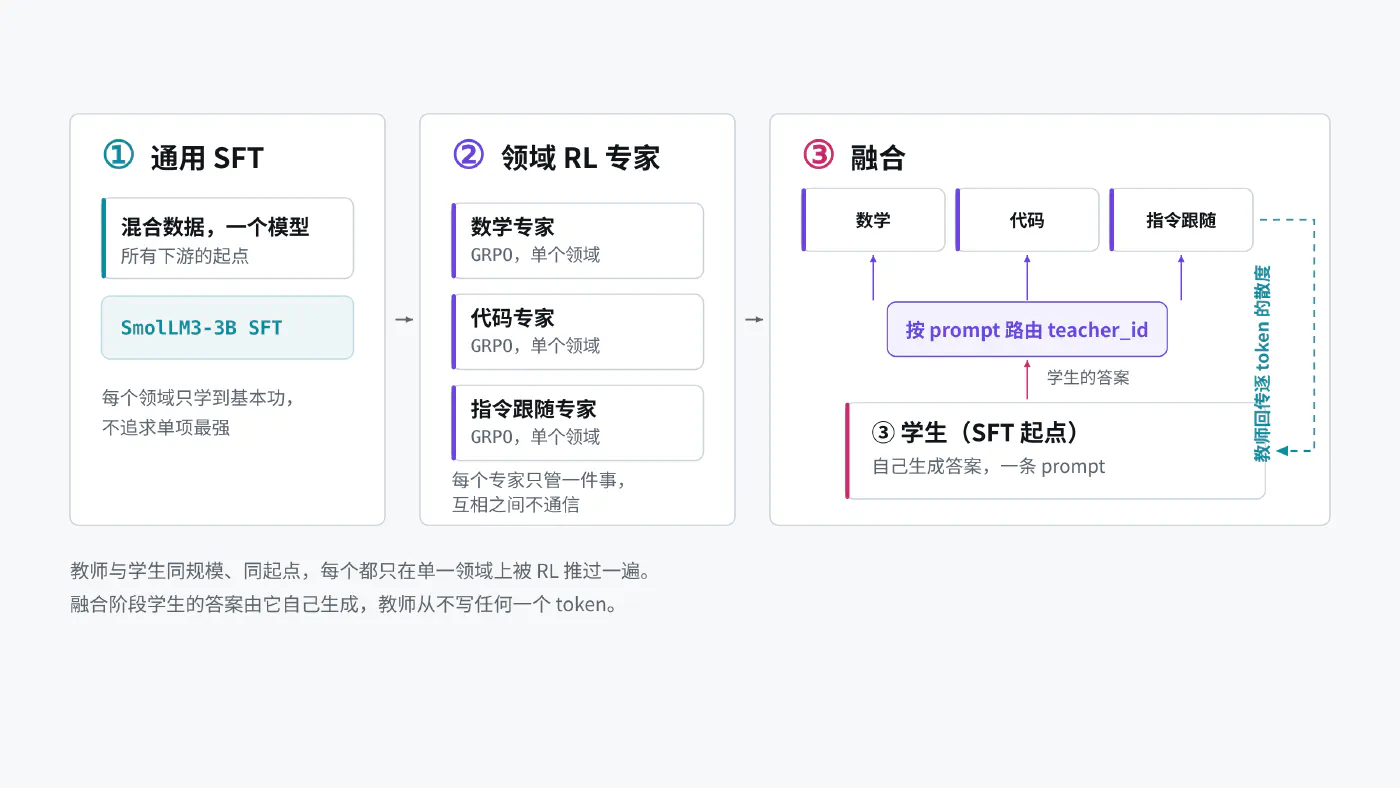
多教师在线蒸馏(MOPD)是一条三段式的后训练配方,名字来自小米 2026 年 1 月给 MiMo-V2-Flash 写的那篇技术报告。
第一段是通用 SFT,一个模型在混合数据上把每个领域的基本功学会,这一份检查点是后面所有东西的起点。第二段按领域各训一个 RL 专家,数学一个、代码一个、指令跟随一个,谁也不管别人的活。第三段是融合,学生重新回答各个领域的 prompt,每条 prompt 由它自己领域的那个专家逐 token 打分,学生朝那个分布挪。
三个性质决定了它为什么成立。
| 性质 | 后果 |
|---|---|
| 样本由学生自己生成 | 教师评的是学生真正写出来的话。拿教师输出做 SFT,学生只在教师写的文本上训过,推理时却要续自己的文本,早期一个错误就把它带到训练里没见过的分布 |
| 每个 token 都有信号 | RL 一条答案一个 reward,这里每个位置都拿到教师的分布,loss 是学生与教师在学生 token 上的散度 |
| 一条 prompt 只进一个教师 | 数学 prompt 只由数学专家打分,不做平均,也不做集成 |
教师通常与学生同规模、同一起点,它们有用的原因是在单一领域上被 RL 推过一遍。它换来的是排期,多领域一起训被拆成分别训好再合成。
产业侧已经这么干了一阵。Kimi K3 用了九个专家,按领域和推理档位切开。Nemotron 3 Ultra 用十多个教师,跑两轮 MOPD,第一轮合成之后从合成模型重新训教师。DeepSeek-V4 用十多个领域教师替掉了 V3.2 里那个混合 RL 阶段。Mistral Large 4 的切法不一样,按推理档位高中低分三个教师,领域不再是切分依据。
三、论文把病因定在预算#
Open-MOPD(arXiv 2608.19098,8 月 19 日)做了一件很少见的事,它把路由问题先摘掉。基准建在 SmolLM3-3B-Base 上,用 oracle routing,保证每条 prompt 都送到正确的专家手里。剩下的差距只能来自融合本身。
结论是一对数字。相对一个按领域路由的 oracle 集成,标准 MOPD 只回收了 35.6% 的可用上限,加上论文的三个修法之后到 83.4%。同一个学生、同一批教师,差出来的 47.8 个点全在训练过程里。
论文对病因的判断很直接,问题出在 token 层级的优化预算分配,不是梯度冲突。作者拆出三个原因。各领域的序列长度差得太远,写数学的答案几千 token,写指令跟随的几百 token。各领域的收敛速度不一样,学得快的先占住梯度。异步管线里的 reward 会陈旧,旧样本配新策略,权重还会漂。
对应的三个修法分别是 token 份额平衡、按差距动态分配预算、给学生刷新 reward。名字听着抽象,前两条处理的是同一件事,谁产出多少 token,谁就在 loss 里占多大份额,这个份额可以调。
四、按 token 平均,等于按答案长度投票#
原因在 loss 的形状。散度在每个 token 上算,最后在 token 上求平均,一个领域的话语权就等于它产出的训练 token 数除以总 token 数。
prompt 份额和 token 份额因此可以差一个数量级。示例数据按 40/40/20 切数学、代码、指令跟随,指令跟随出了五分之一的题,却只出百分之一到三的字。数学和代码的答案是一条长推理链,几千 token 起。指令跟随的答案常常是「写两段话,中间用星号隔开」,几百 token 就完了。60 步之后数学和代码的答案还在变长,指令跟随的份额还会继续掉。
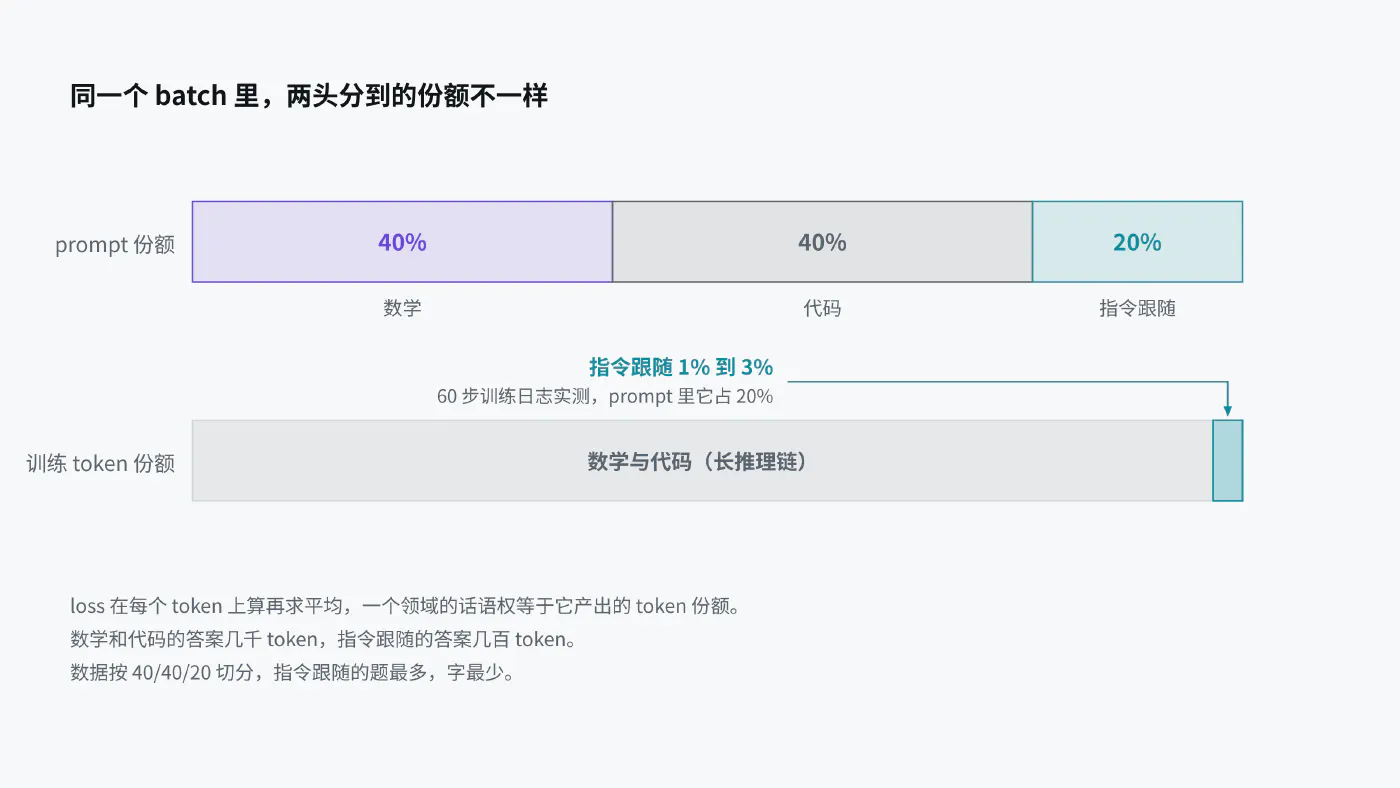
TRL 的文档把这件事写进了指标说明。teacher_token_frac/<id> 记录每个教师拿走的 token 份额。文档的注释说,被饿着的教师照样报一个健康的 teacher_jsd/<id>,所以路由偏斜不看这个指标就发现不了。只盯着 loss 的绝对值,指令跟随那一科看起来一直在学,实际每一步只分到几十条样本的梯度。
五、TRL 里三个默认值#
在 TRL 里跑 MOPD,配置里有三个默认值决定了这笔预算怎么记。
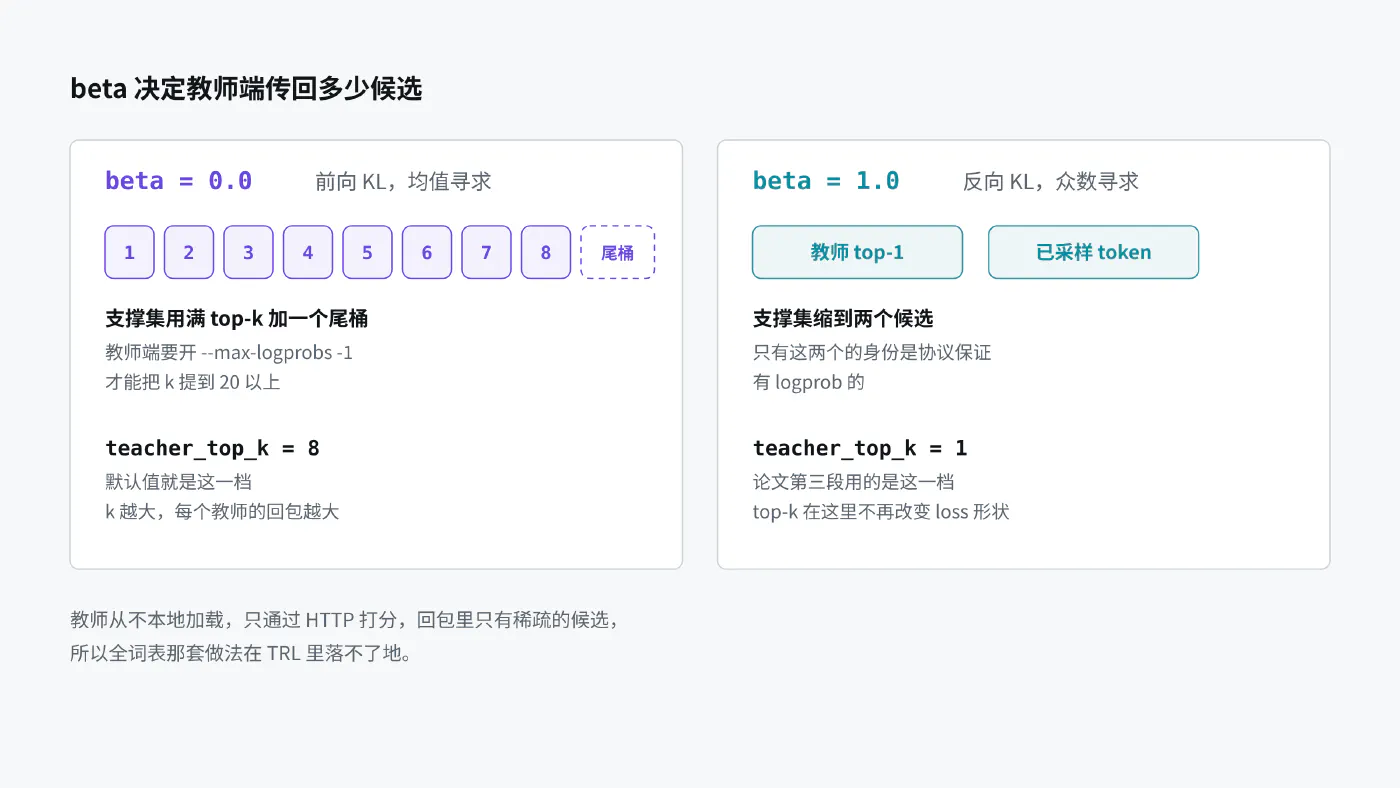
beta 默认 0.0,也就是前向 KL,均值寻求。MOPD 论文第三段用的是 1.0,反向 KL,众数寻求。文档把这个差别单独写了一段。直接抄官方示例、删掉 beta 这一行,跑的就是另一个目标函数,日志照样在降。
teacher_top_k 默认 8,但只在 beta=0.0 时决定形状。beta 非零时,支撑集缩到两个候选,教师的 top-1 和完成序列里的真实 token。HTTP 协议只保证这两个身份有 logprob。示例里写 teacher_top_k=1 就是为了让每个教师的回包小一点,它在这个 beta 下不再影响 loss 的形状。
第三个要单独说,它是一条硬约束,每个教师必须与学生共用分词器。学生的完成序列以原始 token id 发给教师,教师回来的候选 id 被直接用来索引学生自己的词表。教师的词表不一样,训练就在对的分布上算错的 token,而且只在教师词表比学生大时才报错。
# examples/async_distillation_mopd/async_distillation_mopd.py
config = AsyncDistillationConfig(
    teacher_server_urls={
        "math": "http://localhost:8001",
        "code": "http://localhost:8002",
        "if":   "http://localhost:8003",
    },
    beta=1.0,         # 反向 KL,与论文第三段一致;默认值是 0.0
    teacher_top_k=1,  # beta 非零时支撑集已经只有两个候选,这项只影响回包大小
    max_completion_length=16384,
    vllm_server_timeout=3600,
)
六、五个进程,四张卡#
融合阶段同时要跑五样东西。学生自己的 vLLM 服务负责生成,教师的 vLLM 服务只做打分,训练进程在中间拉队列。示例把五样东西摊在 4 张 H200 上。
| 卡 | 跑什么 | 为什么这么放 |
|---|---|---|
| 0 | 学生的 vLLM | 每 weight_sync_steps 步要接收一次新权重 |
| 1 | 数学与指令跟随两个教师 | 两个小模型共享一张卡,先起一个再起另一个 |
| 2 | 代码教师 | 代码 prompt 最长,单独一张 |
| 3 | 训练进程 | 只做前向反向和优化器 |
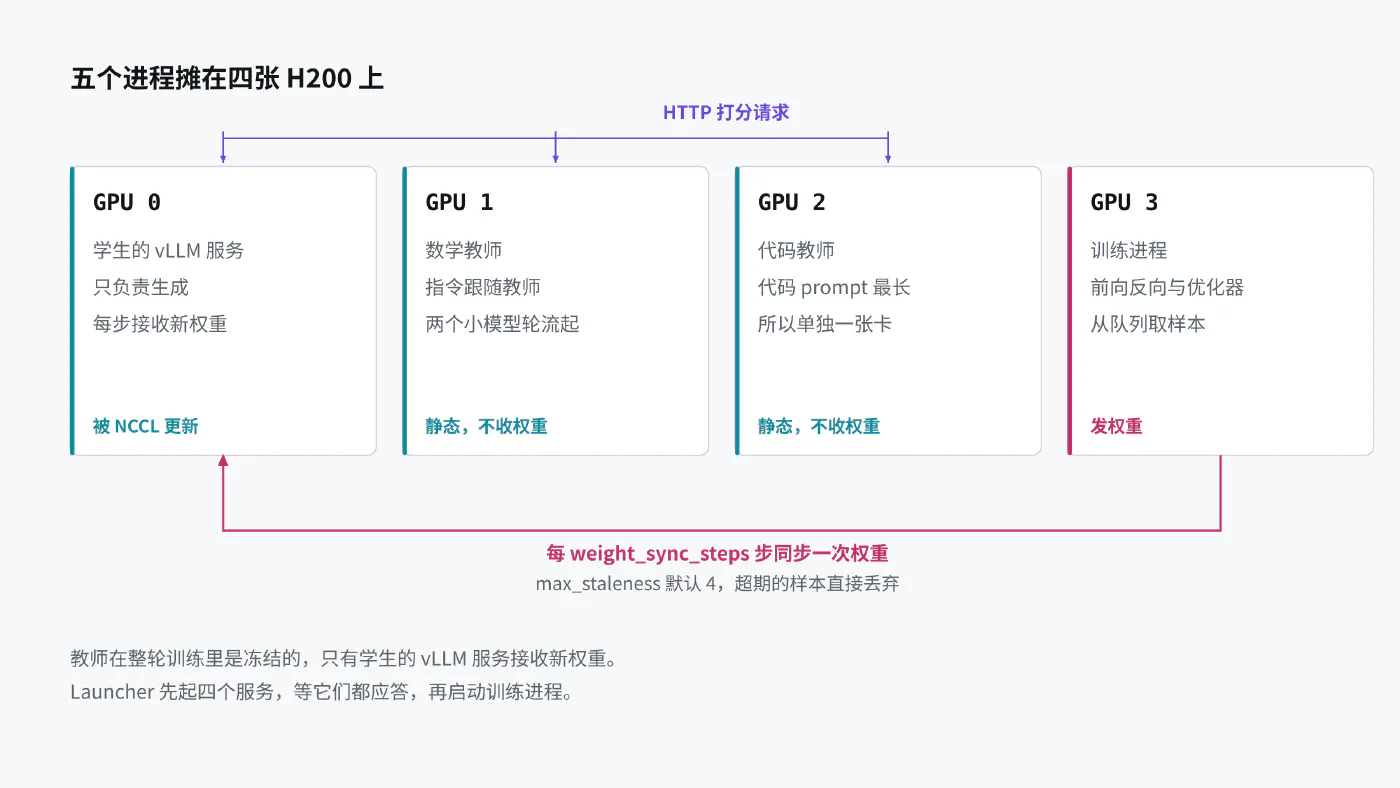
异步管线的代价藏在两个默认值里。weight_sync_steps 默认 1,每一步都把学生的新权重推给 vLLM。max_staleness 默认 4,样本如果在队列里待了超过四次权重更新还没被训练,就直接丢掉。这两个数字一起决定了队列能跑多深,也决定了旧样本在梯度里占多少。
LoRA 那条路要单独算账。默认的权重同步会把适配器合并进基础模型再整份发过去,7B 模型一次大约 15 GB。让学生端用 --enable-lora 起,一次只发适配器,r=32 时约 160 MB。省下来的带宽有代价,vLLM 服务 LoRA 适配器时每 token 生成慢 1.33 到 1.39 倍,而生成通常就是墙钟时间的主要部分。
七、数字与来源#
| 指标 | 值 | 来源 |
|---|---|---|
| 上限回收,标准 MOPD | 35.6% | 论文摘要(arXiv 2608.19098) |
| 上限回收,Open-MOPD 三个修法 | 83.4% | 同上 |
| 指令跟随的 prompt 份额 / token 份额 | 20% / 1% 到 3% | Hugging Face 博客,60 步训练日志 |
| MixSFT 起点 AIME24 / AIME25 / IFEval | 17.5 / 19.2 / 67.5 | 同上,每题 4 个样本,IFEval 用严格 prompt 级准确率 |
| 60 步 MOPD 同上三项 | 24.2 / 22.5 / 73.0 | 同上 |
| 论文终版同上三项 | 19.2 / 25.0 / 75.8 | 同上 |
beta 默认值 / 论文第三段取值 | 0.0 / 1.0 | TRL 文档 |
teacher_top_k 默认值 | 8 | TRL 文档 |
teacher_top_k 超过 20 的前提 | 教师端加 --max-logprobs -1 | TRL 文档 |
| 邻近框架的稀疏支撑 | miles 16,EasyOPD 64 | TRL 文档 |
| LoRA 权重同步,7B,r=32 | 15 GB / 160 MB | TRL 文档 |
| LoRA 服务的生成开销 | 慢 1.33 到 1.39 倍 | TRL 文档 |
两栏的来路不同。35.6% 与 83.4% 是论文自己报的,没有第三方复现。60 步那一组是博客作者的实测,只有一次,只有 60 步,样本量不支持任何关于「短训优于长训」的结论。
八、读者能自己核什么#
这四件事都能在一小时内复现,不需要额外的机器。
| 要核什么 | 去哪里 | 看什么 |
|---|---|---|
| 路由偏斜真的存在 | 训练日志的 teacher_token_frac/<id> | 指令跟随的份额是否远低于它的 prompt 占比 |
| 方向被默认值改掉了 | AsyncDistillationConfig 文档里 beta 那一条 | 默认 0.0 是前向 KL,论文第三段是 1.0 |
top-k 在 beta 非零时不起作用 | 同一条文档的支撑集说明 | 支撑集缩到两个候选的那句话 |
| 分词器不一致会静默错 | teacher_server_urls 的注释 | 词表小的时候不报错 |
九、两个我答不上来的问题#
一是教师比学生大的时候,这笔预算该怎么记。论文和示例里教师与学生同规模、同起点,token 份额与参数份额大致等价。换成大教师带小学生,一个 token 的信息量不一样了,还按 token 平均是否仍然公平,没有人测过。
二是路由本身。Open-MOPD 用 oracle routing 把路由的模糊性摘掉,才把差距归到预算上。线上没有 oracle,prompt 属于哪个领域由分类器判断,判错的 prompt 会被记到另一个教师的账上,这个误差会以什么方式混进 token 份额,论文里没有答案。
参考#
- Paniego, Sergio. 《MOPD in TRL》. Hugging Face blog, 2026-11. https://x.com/sergiopaniego/status/2117599953153294341
- 《MOPD, Multi-Teacher On-Policy Distillation for Capability Integration in LLM Post-Training》. arXiv 2606.30406. https://huggingface.co/papers/2606.30406
- 《Open-MOPD》. arXiv 2608.19098. https://huggingface.co/papers/2608.19098
- 《Async Distillation》. TRL 文档 v1.17.1. https://huggingface.co/docs/trl/async_distillation_trainer
- 《async_distillation_mopd.py》. TRL examples. https://github.com/huggingface/trl/blob/main/examples/async_distillation_mopd/async_distillation_mopd.py
- 《launcher.py》. TRL examples. https://github.com/huggingface/trl/blob/main/examples/async_distillation_mopd/launcher.py
- 《NVIDIA Nemotron 3 Ultra Technical Report》. 2026. https://research.nvidia.com/labs/nemotron/files/NVIDIA-Nemotron-3-Ultra-Technical-Report.pdf
- 《MiMo-V2-Flash Technical Report》. arXiv 2601.02780. https://huggingface.co/papers/2601.02780
- 《DeepSeek-V4》. arXiv 2606.19348. https://huggingface.co/papers/2606.19348
- 《Kimi K3》. arXiv 2607.24653. https://huggingface.co/papers/2607.24653
- Open-MOPD 模型与数据合集. https://huggingface.co/collections/BytedTsinghua-SIA/open-mopd-multi-teacher-on-policy-distillation