本体构建的分水岭不在模型大小
六篇 2025 到 2026 年的论文放在一起,指向同一件事。本体构建的瓶颈已经从「谁来写」移到「谁来验」,每个数字都标了出处和位置。
2025 年 12 月到 2026 年 11 月,六篇论文从三个方向收口到同一个结论。本体构建的瓶颈已经从「谁能把本体写出来」移到「谁能证明写出来的东西是对的」。下面每一个数字都能回到原文的某一节或某一张表。
片子两分十九秒,中文配音,字幕烧在画面里,也可以用播放器关掉。
一、同一个事故,现在可以量了#
一支队伍把 40 张表的关系库交给模型,生成一版本体。人工审了两天,改掉三分之一,剩下的签了字。三个月后有人问,某条 subclass 关系是哪来的,没人答得上来。它可能是从外键推出来的,也可能是从邻表名字猜的,区别在事后无法分辨。
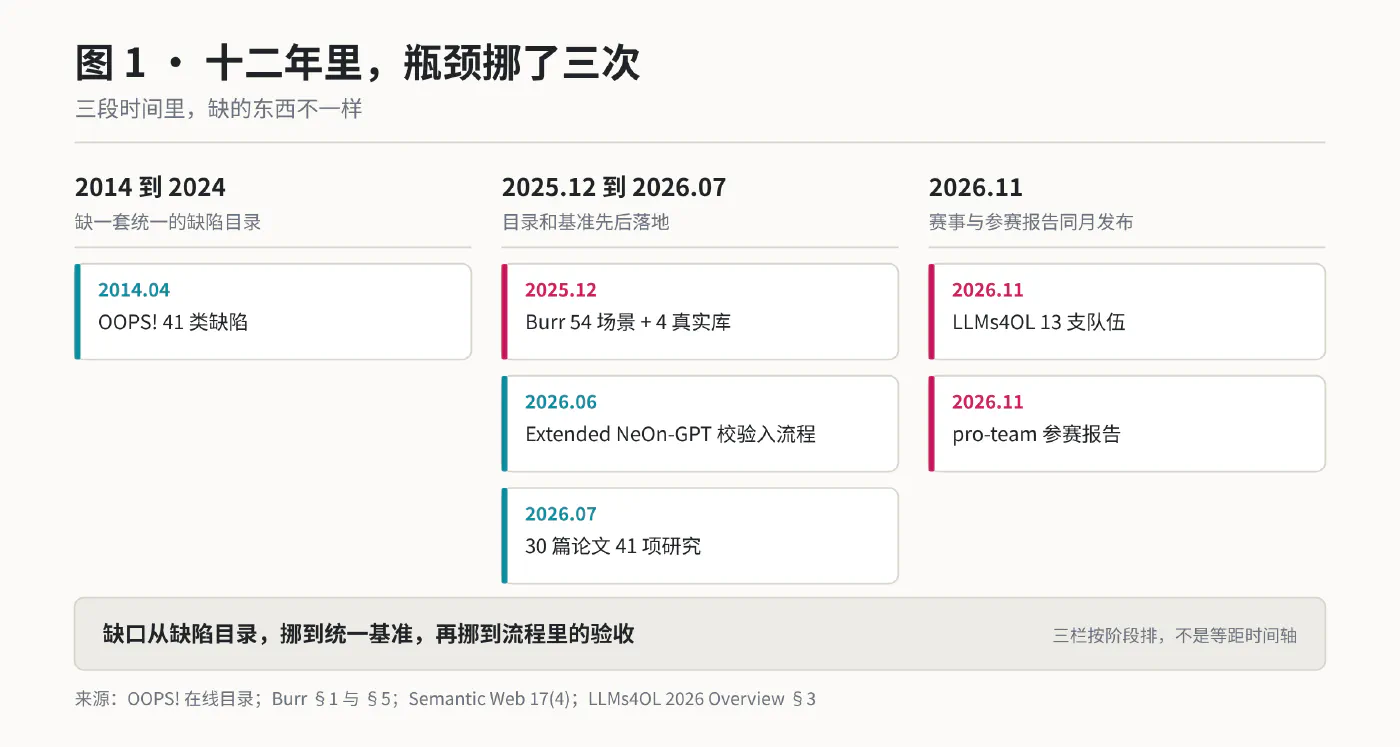
这件事过去只能靠经验描述。2025 年 12 月,Burr 给了第一套统一的度量,54 个手工场景加 4 个真实数据库(PACMMOD 3(6) 第 305 篇)。2026 年 7 月,一份系统综述数完了这个方向的 30 篇论文、41 项研究(Semantic Web 17(4))。2026 年 11 月 2 日,LLMs4OL 第三届的赛道报告发布,13 支队伍上榜。三份材料的规模差得很远,指向的问题一样。
二、第一个统一基准打碎了模型通吃这条说法#
Burr 的 §1 先算旧账。作者按 Mosca 等人的方式复查了十个本体学习系统,结论是多数论文根本不评测,或者只做词法比对,连 F1 怎么算都不写。
他们的解法是把评测绑到 mapping 上(§4)。一个本体光有类名不算数,还得说清它对应数据库的哪张表、哪一列,真阳性按 mapping 算。这个改动把「名字像」和「指对了」分开,也顺手把词法 F1 的虚高暴露出来。
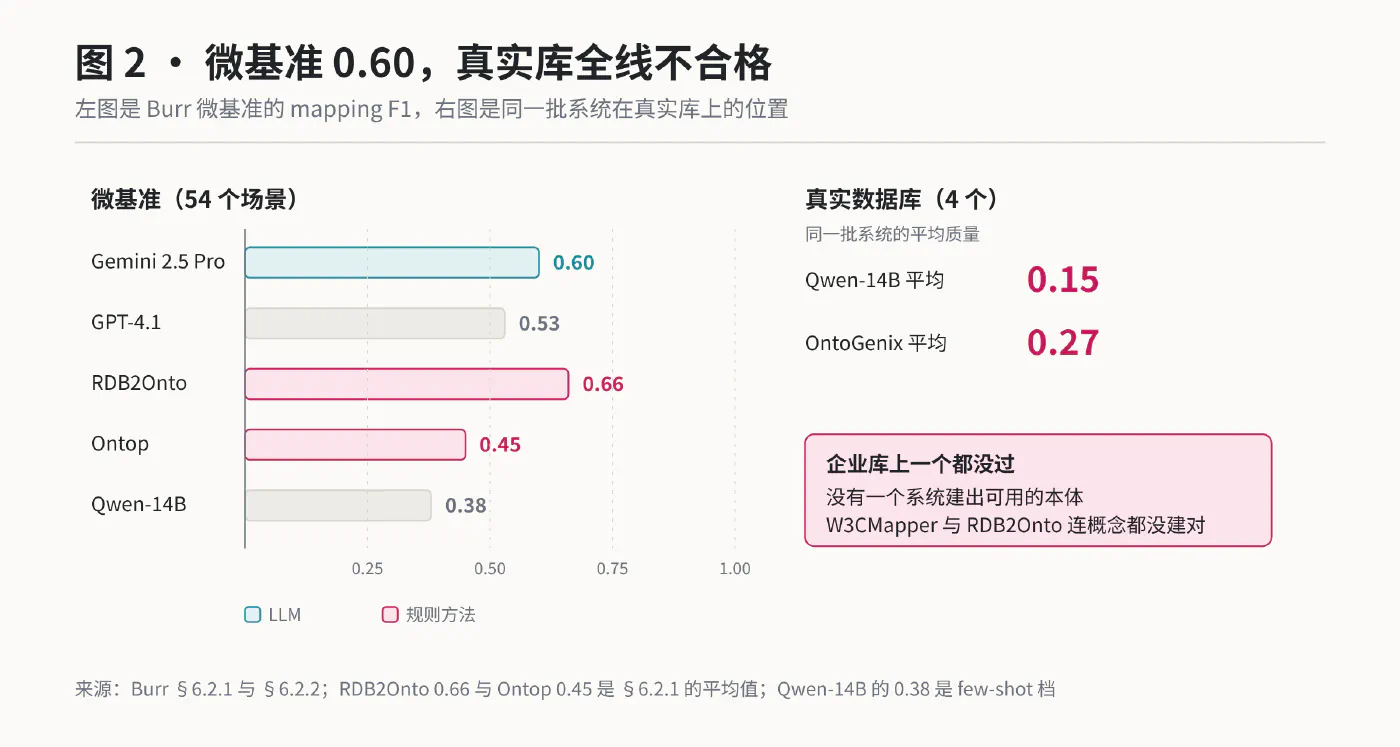
微基准(§6.2.1)的结果是这样。
| 系统 | 微基准 mapping F1 | 备注 |
|---|---|---|
| Gemini 2.5 Pro,checklist 提示 | 0.56,加 few-shot 到 0.60 | 全场最好 |
| GPT-4.1 | 0.53 | 第二 |
| Qwen-14B | 0.00 到 0.38 | simple 提示下输出几乎无法解析,给例子才到 0.38 |
| RDB2Onto | 0.66 | 规则系统,N-to-M 表处理更细 |
| Ontop | 0.45 | 规则系统 |
| 组合场景,所有系统 | 0.61 | 两个简单场景一叠加就到顶 |
真实数据库换了一幅图景(§6.2.2)。作者原话是 all systems perform poorly,Qwen-14B 平均 0.15,OntoGenix 0.27。在 NPD 库上,规则方法的质量高于所有 LLM。企业场景那个库更大也更反规范化,没有一个系统建出合适的本体,W3CMapper 和 RDB2Onto 连概念和关系都没建对。
外键实验的数字更清楚。给 Mondial 补上外键约束之后,Ontop 的关系类指标从 0.00 涨到 0.35,RDB2Onto 从 0.00 涨到 0.24。Gemini 几乎没受益,作者的解释是提示词随约束变长,反而压住了质量。运行时间也拉得很开,除 OntoGenix 外的系统 11 秒内跑完,OntoGenix 因为多次调用模型要 45 分钟。
这里有一处需要纠正的地方。Burr 的摘要说规则方法仍有优势,读起来像「纯 LLM 打不过规则」,但 §6.2.1 的微基准里 Gemini 是赢的。规则方法的胜场有明确条件,外键齐全、schema 规范、库的建模习惯和规则对得上。准确的说法是规则方法在结构清楚的地方更稳,LLM 在反规范化、需要语义理解的地方更强,而两边都过不了真实企业库。RIGOR 后来引 Burr 时写成 LLM 方法在 mapping 上不如规则方法,也是这个简化。
三、三十篇论文的共同缺口#
系统综述那篇(Li、Garijo、Poveda-Villalón)把 30 篇论文拆成 41 项研究,按本体开发阶段分类。
| 阶段 | 研究数 | 说明 |
|---|---|---|
| 实现(概念化、编码、匹配、评估) | 27 | 绝大多数工作挤在这里 |
| 需求规格(含 CQ 生成、SPARQL 形式化) | 12 | 第二密集 |
| 发布(文档生成) | 4 | 少 |
| 维护 | 1 | 只有一篇 |
评测的情况是这样(§4.3)。41 项研究里有 11 项没有做实验,9 项没有任何评测,27 项带实验的研究里有 3 项连访问链接都没有。作者在 §5.3 写得很直白,这些评测打的是整条流水线,不是某个 LLM 部件,所以跨论文比较很少公平;连提示词设计或语料选择这种小改动都能显著改变结果。
这份综述的建议是模块化评测框架。生成方法已经够多,缺的是可以互相比较的验收。
四、把骨架放在模型前面#
RIGOR(arXiv 2506.01232v2)是 2026 年这条线上最完整的一份工程答案。它的流程按外键逐表推进,每一步做四件事(§3.1、Abstract)。先生成确定性的直接映射,保证 schema 覆盖不靠模型;再从三处检索上下文,本表的 schema 与文档、已经建好的核心本体、外部领域本体;然后让 Gen-LLM 产出带溯源标注的 delta 片段;最后交给独立的 Judge-LLM 校验,不合格就改。
缺陷这块用的是 OOPS!,41 类模型缺陷(§4.6)。eICU-CRD 库上,直接映射产出 665 个缺陷,基线方法全部超过 400 个,RIGOR 降到个位数,DeepSeek 那版 26 个。Chinook 上三个 RIGOR 变体全部 0 缺陷。它还是唯一产出 owl:disjointWith 公理的方法,Chinook 配 Mistral 时出了 13 条,其他方法一条都没有。
更关键的是它接上了 Burr 的账。在 Burr 的 ISWC 库上,RIGOR 的 class F1 是 0.73,relation F1 0.67,attribute F1 0.52。作者自己在 §4.7 写了一句 RIGOR reverses this finding,意思是前面那个「LLM 不如规则方法」的结论被反过来了,靠的是模型生成加 schema 接地的溯源标注。
十位本体工程与知识表示方向的专家给了旁证。四项评比里 RIGOR 拿了 28 次第一,40 次中的 70%,专家之间的一致性 Kendall’s W 在 0.39 到 0.72 之间(§4.7)。消融实验(§4.8)显示三路检索里去掉任何一路,跨源对齐都会掉,只留文档那一路的文档 F1 最高但整体最差。
五、公理是天花板#
如果本体构建有一道天花板,位置在公理层。OntoAxiom 这份基准(arXiv 2512.05594)用 9 个中等规模本体、17,118 个三元组、2,771 条公理,把 12 个模型、3 种 shot 设置、2 种提示策略全跑了一遍。
| 公理类型 | 平均 F1(Table 5) |
|---|---|
| subclass | 0.359 |
| subproperty | 0.106 |
| disjoint | 0.095 |
| domain | 0.038 |
| range | 0.030 |
提示策略不是主要变量。Axiom-by-Axiom 最好的一档 0.130,Direct 最好的一档 0.126,差别很小(Table 7)。作者在 §6 的判断是模型表现受任务难度约束,不受提示设计约束。领域效应倒是很大,FOAF 的 subclass 能到 0.642,音乐本体只有 0.218。domain 和 range 最差,因为这两个公理的含义随上下文变,同名属性在不同领域里的定义域不一样。
这份预印本有一处不一致。§5.4 的正文写 o1 的 F1 是 0.164,同一页 Table 9 写的是 0.197。差得不多,但这正是上一篇综述说的问题,一个数字在正文和表格里对不上,读者就没法复现。
六、决定分数的是标签空间#
LLMs4OL 2026 的总览(OCP 第 11 卷,2026-11-02)把三个任务的结果摆在一起,结论写在摘要第一句,约束标签空间比模型规模更重要。
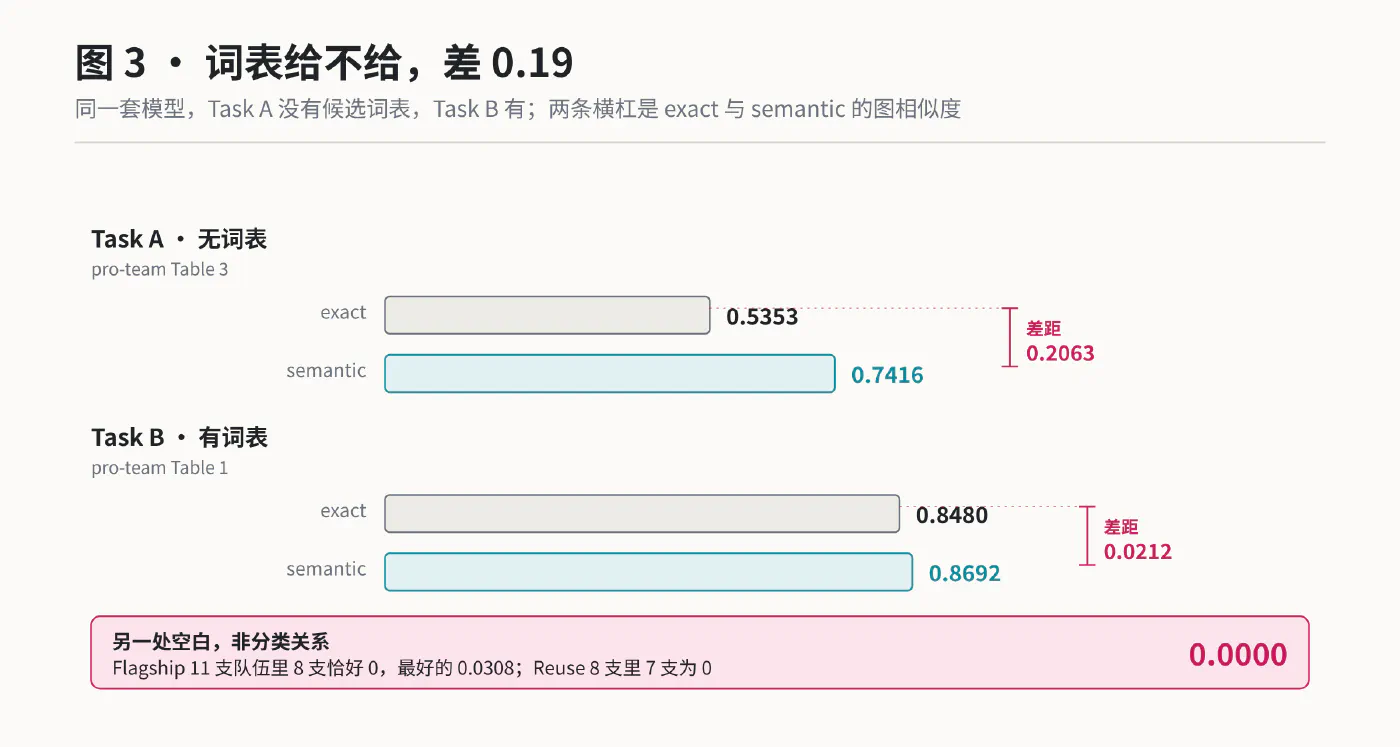
先看数字。Flagship 任务从文本直接建本体,11 支队伍,图相似度从 0.4167 到 0.7762。每支队伍的 exact 匹配到 semantic 匹配都是单调上升,差 0.13 到 0.19,说明相当一部分预测是词形或改写差异,不是错。任务导向的 F1 低得多,最高 0.4903。Reuse 任务给定了部分本体和候选词表,8 支队伍里 5 支超过 0.85,术语类型 F1 最高 0.9989。
非分类关系是另一回事。Flagship 11 支队伍里 8 支恰好 0.0000,最好 0.0308;Reuse 8 支里 7 支 0.0000,唯一非零的 0.1818。
pro-team 那篇参赛报告给了同一条结论的另一种测法。同一套 Qwen2.5-14B 加检索,Task B 有词表约束,exact 0.8480、semantic 0.8692,两个只差 0.0212;Task A 没有闭集可约束,exact 0.5353、semantic 0.7416,差 0.2063,作者自己叫它 20 个点的落差。
| 任务 | exact 图相似度 | semantic 图相似度 | 差 | 出处 |
|---|---|---|---|---|
| Task B(有词表) | 0.8480 | 0.8692 | 0.0212 | pro-team Table 1 |
| Task A(无词表) | 0.5353 | 0.7416 | 0.2063 | pro-team Table 3 |
同一支队伍、同一个模型,两个任务的差距不在理解力,在有没有一张给定的词表。词表由人定好,交给模型照着用。
七、验收清单已经是工程产物#
把这些线索接起来,验收这件事并不缺工具。
OOPS! 从 2014 年就在做缺陷目录,现在是 41 类(P01 到 P41),每类标 critical、important 或 minor(在线目录,2023 年 4 月修订)。RIGOR 直接拿它当评测项之一,eICU 库上从 665 个缺陷压到个位数,两头接得上。
Extended NeOn-GPT(Semantic Web 17(4),2026-06-26)把校验和修复编排进了流水线,草稿生成之后调第三方工具检查,再由模型提修复建议,还加了显式的本体复用步骤。四个领域、闭源和开源的四种模型都跑了,多数实体与三元组相似度落在 0.5 到 0.8。
工业侧的信号来自 QDB'25 那篇。BNDES 用小型语言模型审计 400 个生产 schema、10 TB 数据,模型生成的检查脚本推动解决了 58.7% 的已报告问题。数据治理和建模这两件事在合流,审计的对象就是 schema 本身。
需求侧也有现成的锚。OE-Assist 攒了 1,393 条能力问题,配上本体和场景说明,覆盖 33 个领域。能力问题一直是最像验收标准的东西,因为它问的是「这个本体能不能回答这个问题」,而这个问题有唯一答案。
八、我们落在哪,以及四个没填的洞#
我们这边的做法是 32 条验收规则,设计时对着 OOPS! 的 41 类逐条取舍,验收标准在动手之前定好再跑生成。这是设计选择,不是测量结果,所以这里不报分数。它对应的正是上面那条线最缺的环节,先写验收,再让模型交作业。
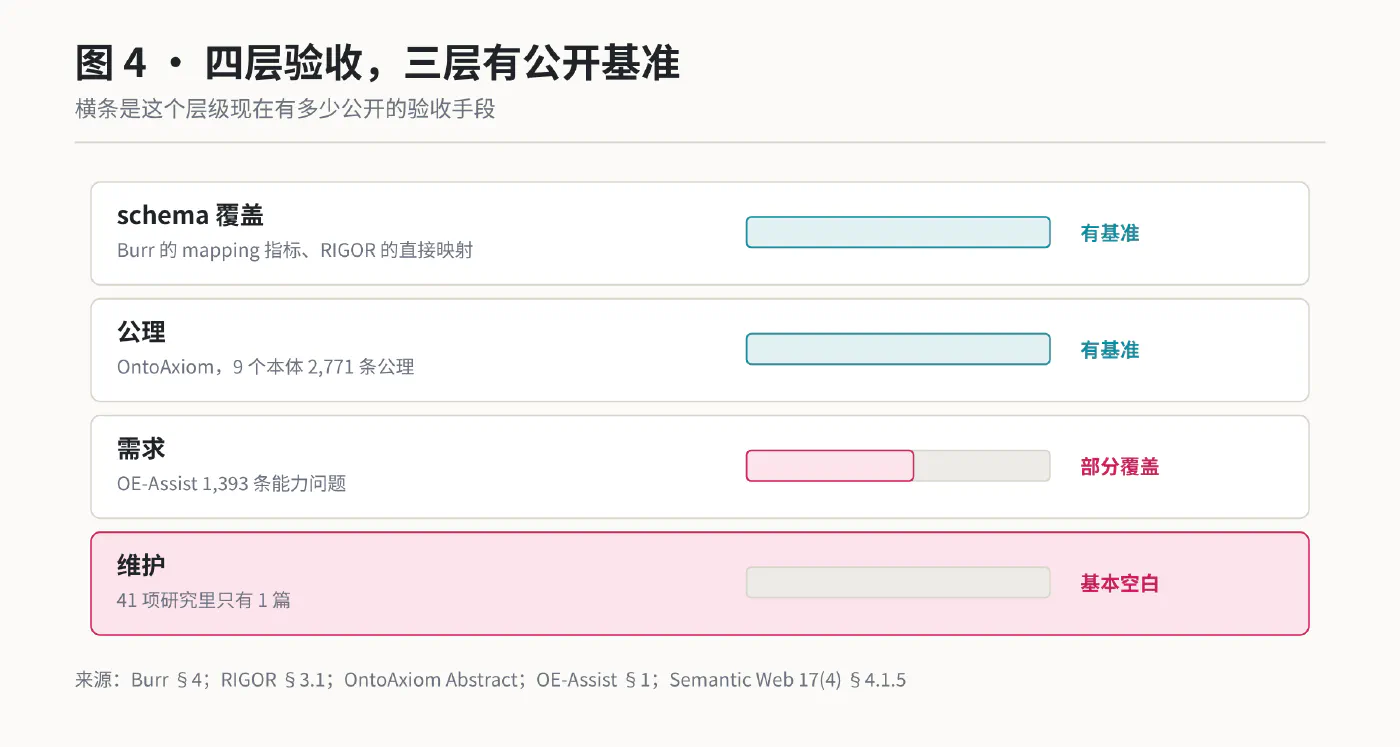
图 4 把验收分成四层,标出每层现在有没有公开基准。schema 覆盖层有 Burr 和 RIGOR,公理层有 OntoAxiom,需求层有能力问题集,维护层基本空着。
四个没填的洞,按证据强弱排。
一是非分类关系,两个任务里大面积为 0,最好的 0.0308。二是 domain 和 range 公理,F1 在 0.030 到 0.038。三是维护,41 项研究里只有 1 篇碰过。四是词形保真,exact 与 semantic 之间那 0.13 到 0.19 的距离,说明模型经常知道意思却写不对词,而下游要的是能对齐的 URI。
九、为什么是现在,以及怎么自己核#
产业侧的判断来得比论文早。Gartner 在 2026 年 8 月 26 日、9 月 2 日、11 月 6 日各发了一份,讲 agent 缺少可信上下文、讲最小可行本体、讲十一家企业怎么落地本体治理(文档号 8304653、8340117、8609137)。三份都只有摘要页,没有公开方法和数据,所以它们能回答的只有为什么现在做,回答不了怎么做才对。
论文这边可以自己核。下面五处是我核过的,都能在一两分钟内复现。
| 要核什么 | 去哪里 | 看什么 |
|---|---|---|
| 微基准与真实库的落差 | Burr §6.2.1、§6.2.2 | 0.60 与 all systems perform poorly 同在一篇里 |
| 缺陷数怎么降下来的 | RIGOR §4.7 | 665 与个位数的对照 |
| 公理层有多低 | OntoAxiom Table 5 | domain 0.038、range 0.030 |
| 正文与表格不一致 | OntoAxiom §5.4 与 Table 9 | 0.164 与 0.197 |
| 词表的作用 | LLMs4OL 2026 Table 2 | Task A 与 Reuse 的 exact 列 |
十二年里,这个领域换过三次难问题。先是缺一套缺陷目录,OOPS! 补上了。然后是缺一个统一基准,Burr 补上了。现在缺的是把验收放进流程,而这一步没有论文能替你做,它取决于你手上那批数据的口径。
参考#
- Laskowski, Hladik, Portisch, Panse, Naumann. 《Burr, a Benchmark for Ontology Learning from Relational Databases》. PACMMOD 3(6), 2025. https://doi.org/10.1145/3769770
- Li, Garijo, Poveda-Villalón. 《Large Language Models for Ontology Engineering, a Systematic Literature Review》. Semantic Web 17(4), 2026. https://doi.org/10.1177/22104968261465514
- Fathallah, Nayyeri, Yogi, Thapa, Tautenhahn, Schnurpel, Staab. 《RIGOR, Retrieval-Augmented Generation of Ontologies from Relational Databases》. arXiv 2506.01232v2. https://arxiv.org/abs/2506.01232
- Bakker, Di Scala, de Boer, Raaijmakers. 《Ontology Learning with LLMs, a Benchmark Study on Axiom Identification》. arXiv 2512.05594. https://arxiv.org/abs/2512.05594
- Babaei Giglou, Auer, D’Souza. 《LLMs4OL 2026 Overview》. OCP 11, 2026. https://doi.org/10.52825/ocp.v11i.3728
- Mishra, Meena, Ojha, Singh, Singh. 《pro-team at LLMs4OL 2026 Tasks Flagship and Reuse》. OCP 11, 2026. https://doi.org/10.52825/ocp.v11i.3663
- Fathallah et al. 《Extended NeOn-GPT》. Semantic Web 17(4), 2026. https://doi.org/10.1177/22104968261453138
- Poveda-Villalón, Gómez-Pérez, Suárez-Figueroa. 《OOPS!, the OntOlogy Pitfall Scanner》. IJSWIS 10(2), 2014. https://doi.org/10.4018/IJSWIS.2014040102
- Seabra, Cavalcante, Ruberg, Lifschitz. 《Towards an SLM-based Auditing of Relational Schemas and Data Quality》. QDB'25 @ VLDB 2025. https://www.vldb.org/2025/Workshops/VLDB-Workshops-2025/QDB/QDB25_7.pdf
- Lippolis et al. 《OE-Assist》. arXiv 2507.14552. https://arxiv.org/abs/2507.14552
- Gartner. 《Build and Govern Ontologies to Ground Trustworthy AI Agents》, 2026-09-02. https://www.gartner.com/en/documents/8340117
- Gartner. 《How to Enable the Context Layer With a Minimum Viable Ontology》, 2026-08-26. https://www.gartner.com/en/documents/8304653
- Gartner. 《Consult the Board, Establishing, Governing, and Operationalizing Enterprise Ontologies》, 2026-11-06. https://www.gartner.com/en/documents/8609137