Open Responses:把 N×M 套适配器换成一份契约,代价写在每个字段的 MUST 里
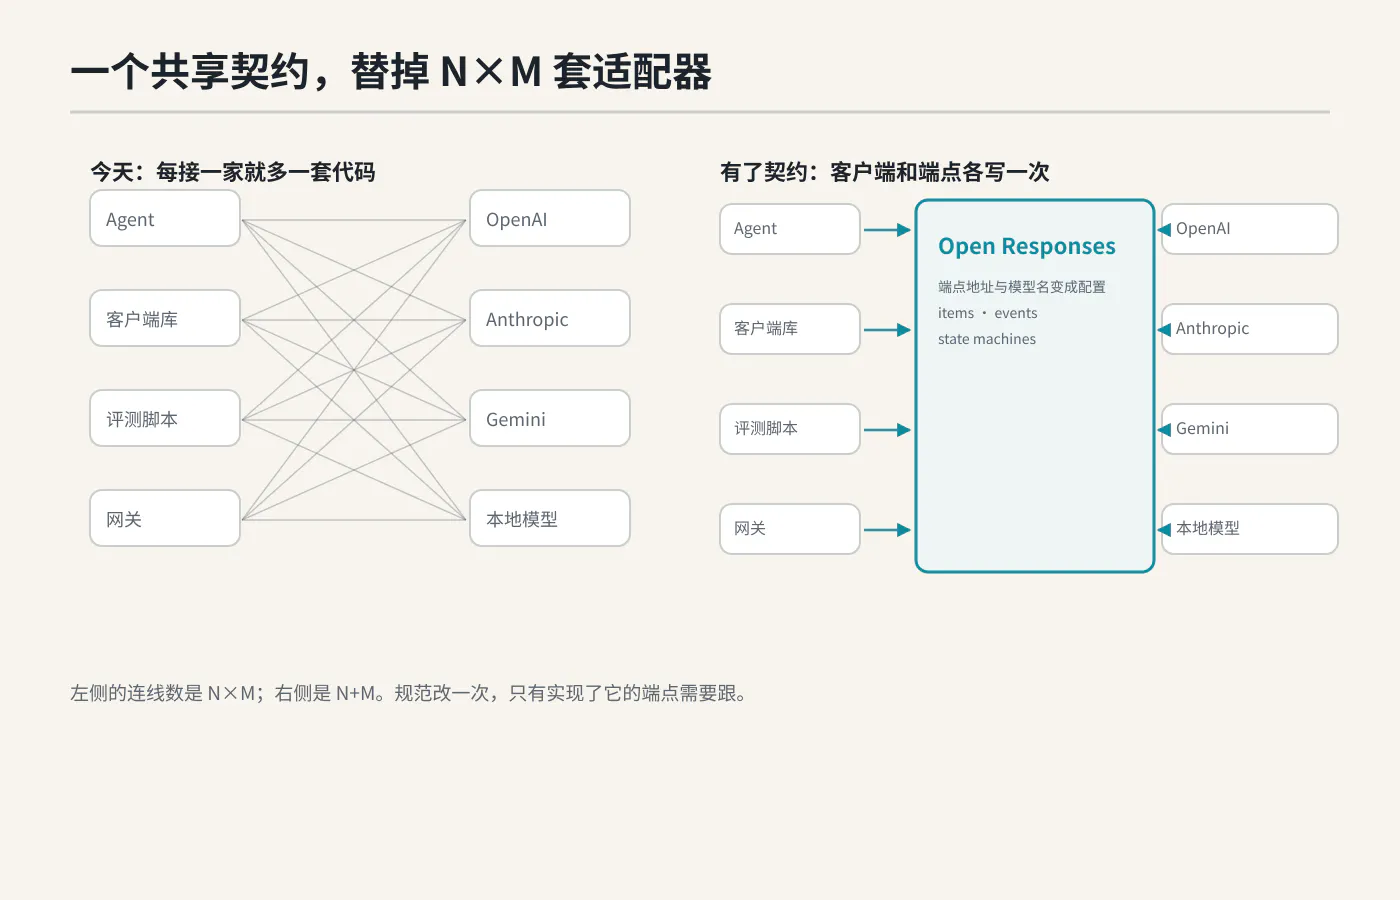
一份以 OpenAI Responses API 为基础、规定请求与响应格式的共享规范,能替掉一堆供应商适配器。真正值得读的不是字段名,而是条目状态机、语义事件、以及 allowed_tools、truncation、previous_response_id 这几个字段背后那句 MUST——它们把「谁能替你决定什么」写清楚了。
一句话 它把「消息」换成双向的条目、把流式换成状态机事件、把扩展做成有名字的旁路;于是端点地址和模型名从代码分支变成配置,而代价从适配器转移到了每个字段的语义细节上。
材料来自三处,都读过:规范全文(含 2026-01-15 与 2026-04-24 两个版本)、它的 TypeSpec schema 与仓库、以及 Databricks 与 Vercel 两个已上线实现的文档。数字分两类标注:仓库里数的,和 GitHub API 给的。
一、它规定的到底是什么#
一句话:以 OpenAI 的 Responses API 为底,定义 /v1/responses 这类端点上收发的请求与响应格式。规范自己划的范围很克制——只到 API 层,不碰模型,也不需要重新训练。
它真正定义的是三样东西,而不是一堆 JSON 字段:
| 零件 | 规范怎么说 | 为什么这么定 |
|---|---|---|
| 条目(Items) | 上下文的最小单位,双向:既能作为输入给模型,也能作为输出返回 | 一次推理产出的是「若干个原子事件」,不是一段字符串 |
| 语义事件 | 流式不是文本增量,而是一系列有意义的状态迁移 | 客户端要能重建结构,而不是拼字符串 |
| 扩展 | 任何实现者可以做真超集;新类型必须带自己的 slug 前缀 | 供应商要有推出自研功能的空间,又不能互相撞车 |
它对「合规」的定义也写在里面:直接实现本规范,或者是它的一个真超集,都算合规。这句话很关键——它允许实现者往前加东西,只禁止把标准字段的含义改掉。
二、三个零件:条目、事件、状态机#
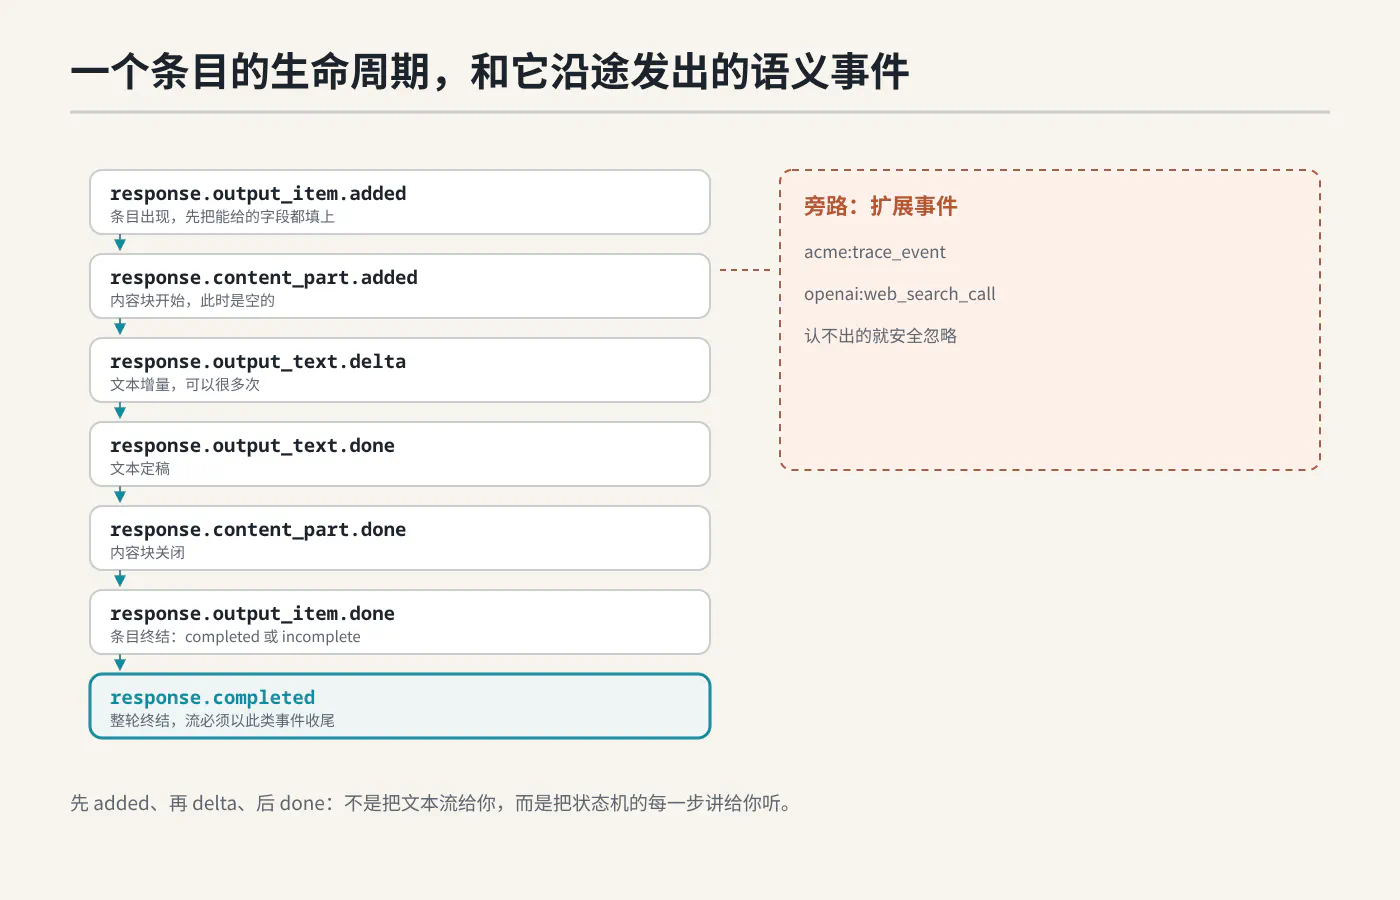
条目有四个性质,每一条都在解决具体问题:
- 多态:靠
type判别。message与function_call形状不同,客户端按类型分派,不再猜。 - 状态机:
in_progress/incomplete/completed。有一条硬规矩——如果某个条目以incomplete结束,它必须是最后一个条目,且整个响应也必须是incomplete。这就杜绝了「半截话后面又接了一句」的歧义。 - 可流式:第一个事件必须是
response.output_item.added,此时能给的字段都要给(消息至少给role,函数调用至少给name),其余字段用零值占位。这样客户端可以先把骨架画出来,再往里填。 - 可扩展:非标准条目必须以实现者 slug 打头,比如
openai:web_search_call。
内容还做了一次不对称切分:UserContent 与 ModelContent 是两个顶层联合类型。用户输入可以是文本、图片、音频等多种模态,模型输出在基础协议里只保证文本。这个不对称是有意为之——它让供应商以后加 output_image 之类的东西时,不用把用户那一侧也跟着泛化。
推理(reasoning)条目更值得注意:content(原始推理)、encrypted_content(加密、客户端只能当不透明串)、summary(可展示给终端用户的摘要)三个字段全部可选。规范不要求供应商暴露思维链,只要求它讲清楚自己给了哪一种。这在同类规范里算少见的克制。
三、四个字段,四种代价#
| 字段 | 规范的要求 | 落在谁头上 |
|---|---|---|
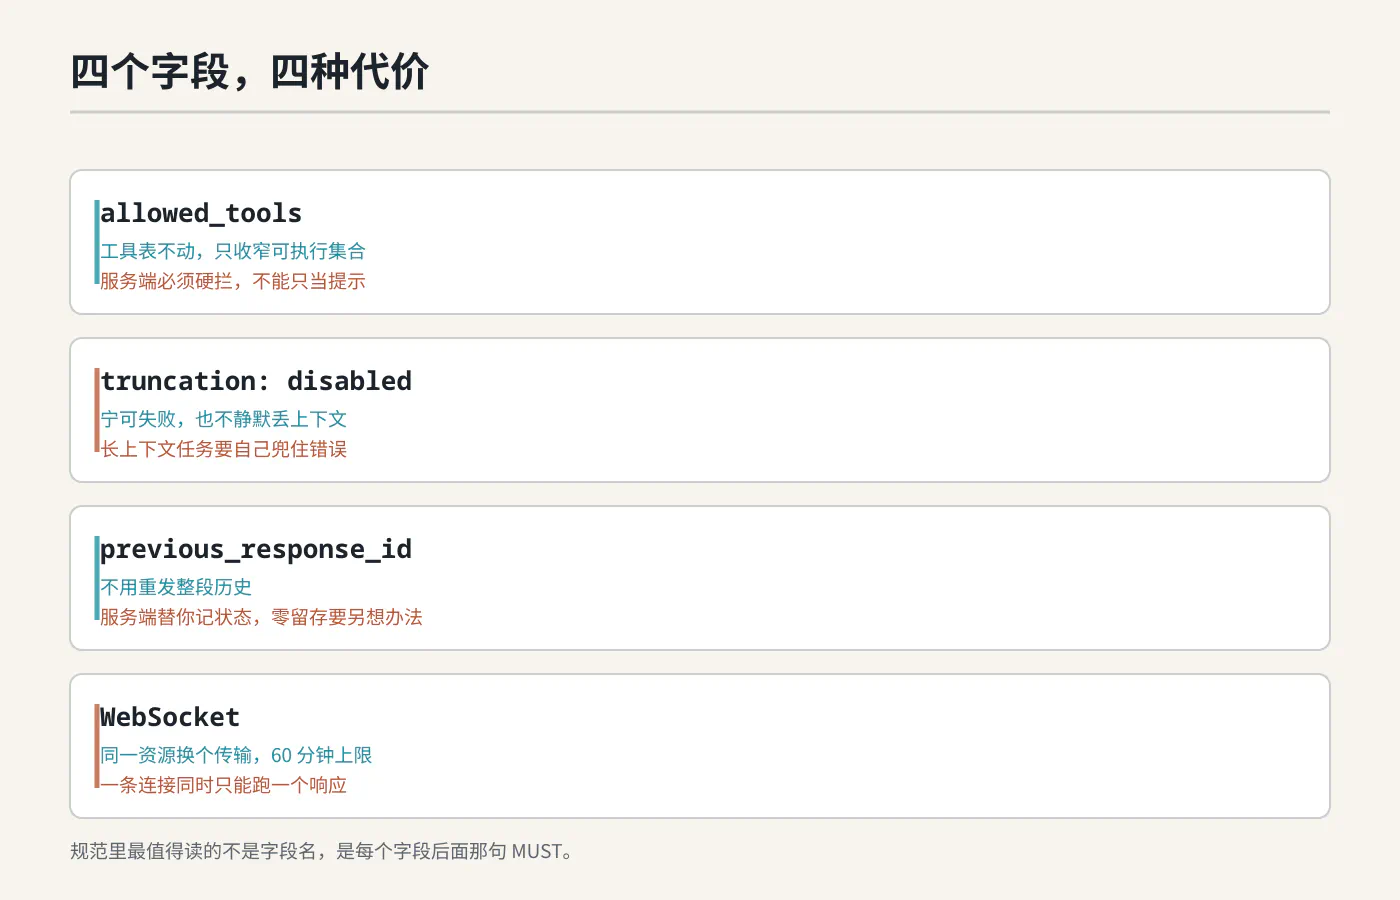
previous_response_id | 服务端必须把上一轮的输入与输出一起读出来,按 输入 → 输出 → 新输入 的顺序拼 | 服务端记状态;零留存部署要另想办法 |
allowed_tools | 工具表照旧全给模型看,但执行时只许调用被列出的子集,服务端必须硬拦 | 服务端;好处是不破坏提示词与工具 schema 的缓存 |
truncation | disabled 时不许截断,超长就报错 | 客户端要自己接住错误,而不是拿到悄悄缺了上下文的结果 |
service_tier | 只是「请求优先级」的提示,允许多档 | 实现者自行映射队列与计费 |
allowed_tools 是这套规范里设计感最强的一处:想收紧工具权限时,传统做法是改 tools 数组,而那会让提示词缓存全部失效;这里改成「表不动、可执行集合变」,把治理动作和缓存经济性解耦。
四、流式与传输#
SSE 侧的规矩不多但都很硬:响应头 Content-Type: text/event-stream,每个 data 是 JSON 字符串,event 字段必须与体内 type 一致,且必须有终止事件(response.completed、response.failed 或 response.incomplete);[DONE] 是可选的,客户端也必须接受不带 [DONE] 的结束。规范还写了「服务端 SHOULD NOT 使用 id」——把排序交给 sequence_number,避免和 SSE 自带的 id 语义打架。
2026-04-24 这一版加了个有意思的东西:WebSocket 传输。同一个 /v1/responses 资源,每轮以 {"type":"response.create"} 开始,事件对象与 HTTP 流式完全一致。几条限制写得很明白:
- 一条连接同一时刻只处理一个进行中的响应,要并行就多开连接。
- 连接上限 60 分钟,到点返回
websocket_connection_limit_reached。 - 续接沿用
previous_response_id,但服务端可以把它放在连接本地内存里——这正好让store=false(零数据留存)的部署也能连续对话;取不到就返回previous_response_not_found,而不是悄悄降级。 - 另有一个
/responses/compact,返回的是压缩后的输入窗口,不是新的响应 id;压缩之后要么省略previous_response_id,要么显式置空。
这几条合起来是同一件事,状态放在哪成了可选项。零留存部署就是这种取舍,上下文跟着连接走,连接断了就没了。
五、扩展:超集即合规#
扩展机制有三层,一层比一层宽:
- 宿主工具(hosted tools):实现者自己的搜索、检索、编排工具,用
implementor_slug:tool_name命名,执行在实现者自己的环境里。规范要求这类工具必须配一个对应的 item 类型,把「模型怎么调的、状态如何、结果是什么」作为回执返回,并且这条回执要能原样回传给服务端做无损续接。 - 扩展条目与扩展事件:必须以 slug 打头,扩展事件至少要有
type与单调递增的sequence_number;认不出的实现必须能安全忽略。 - 扩展已有 schema:允许加字段,但不得改变标准字段的含义,且建议只加可选字段——文档直说这会削弱可移植性。
最后是一条治理路径:被前沿模型广泛采用的特性,提交 TSC 考虑标准化。规范、实现、治理三者第一次连成了一条通路。
六、生态现状#
| 项 | 值 | 来源 |
|---|---|---|
| 规范版本 | 2026-01-15、2026-04-24 | 站点的版本目录 |
| 许可证 / star / fork | Apache-2.0 / 1,197 / 70 | GitHub API |
| 建仓时间 | 2026-01-15 | GitHub API |
| 未结 issue | 47 | GitHub API |
| 主要语言(字节) | TypeScript 269K、MDX 92K、Python 90K、TypeSpec 61K | GitHub languages API |
| schema 源文件 | 9 个 .tsp(items、events、tools、responses、content、configuration、routes、helpers、main) | 仓库 schema/ |
| 一致性测试 | bin/compliance-test.ts 等脚本,站点有 compliance 页 | 仓库 bin/ |
| 已上线实现 | Databricks Model Serving(Claude、Gemini、托管开放模型)、Vercel AI Gateway | 两家文档 |
| 治理 | AAIF 下的 TSC | 规范页 |
规范本身不是手写 OpenAPI,而是用 TypeSpec 写一份源,再生成客户端与 schema。这是「规范即代码」的常见做法,好处是客户端与文档不会各自漂移;代价是贡献门槛抬高——想提字段提案,先要会写这份 DSL。
七、真正变了什么,以及没变什么#
变了的:
- 适配器从代码变成配置。端点地址 + 模型名是两行设置,不再是
if (provider === …)的分支;网关(Vercel)与托管平台(Databricks)都能吃同一份请求体,由它们替你做向下的翻译。 - 评测与路由有了共同底座:同一份请求可以打给四家,日志、计费、耗时在同一个 schema 下对齐。
- 工具调用与流式有了统一的语义层:调用是条目,执行权仍在 Agent 手里(外部工具),或者明确交给平台(宿主工具)。
没变的:
- 合规不等于语义等价。规范保证「请求能被理解、事件能重建」,不保证四家的推理质量、截断策略、宿主工具集一致。
- 扩展字段不可移植。用了
acme:telemetry_chunk的客户端,换一家端点就得自己判空。 - 规矩能不能落地,要看实现者的纪律。
allowed_tools写着 MUST 硬拦——但「有没有真的拦」只能自己试。
八、四条能自己验的检查#
- 用
curl打一个流式请求,看最后一条是不是终止事件(而不是连接直接断掉)。 - 把
allowed_tools收窄到一个工具,然后诱导模型调用另一个;服务端应该拒绝或抑制,而不是照跑。 truncation: "disabled"下塞一个超长输入,看它报错,还是悄悄截断。- 往客户端塞一条不认识的
acme:*事件,看它是否安全忽略、继续把标准事件处理完。
九、开放问题#
- WebSocket 一条连接只跑一个响应,与网关层常见的连接复用、多路复用模型正面冲突。真要做低延迟多轮 Agent,是每个会话开一条连接,还是在网关里做一层连接池?规范没说。
- 「超集即合规」让供应商能自由扩展,但也让「Open Responses 兼容」这句话的含金量取决于实现者的自觉。要不要一份按字段打勾的兼容性矩阵,而不是一个布尔值?
参考#
- 规范全文:https://www.openresponses.org/specification
- 代码仓库:https://github.com/openresponses/openresponses
- Databricks Model Serving:https://docs.databricks.com/aws/en/machine-learning/model-serving/query-open-responses-models
- Vercel AI Gateway:https://vercel.com/docs/ai-gateway/sdks-and-apis/openresponses