一段提示词怎么长成公司大脑:拆 Recall 的四代、一条管道、四个工具
一个检索 skill 的四代演化,和它背后的两条硬决定:原样存储在上游、其余全是可重建的投影;服务器只负责不漏,判断交回给调用它的那个模型。附四组实测数字与可抄的四步。
一句话 它把「记住」做成了检索契约:上游只存原文、永不改写,索引与沙箱全是可重建的投影;服务器对召回负责,精确与引用交回给调用它的那台前沿模型。
材料是作者那篇长文,加上开源的 skill 仓库(Apache 之外的部分没开源,MIT,13 个 skill)。文中数字分两类:作者实测的,和我在仓库里数的,各自标注。
一、四代:每一代都被上一代的故障推着走#
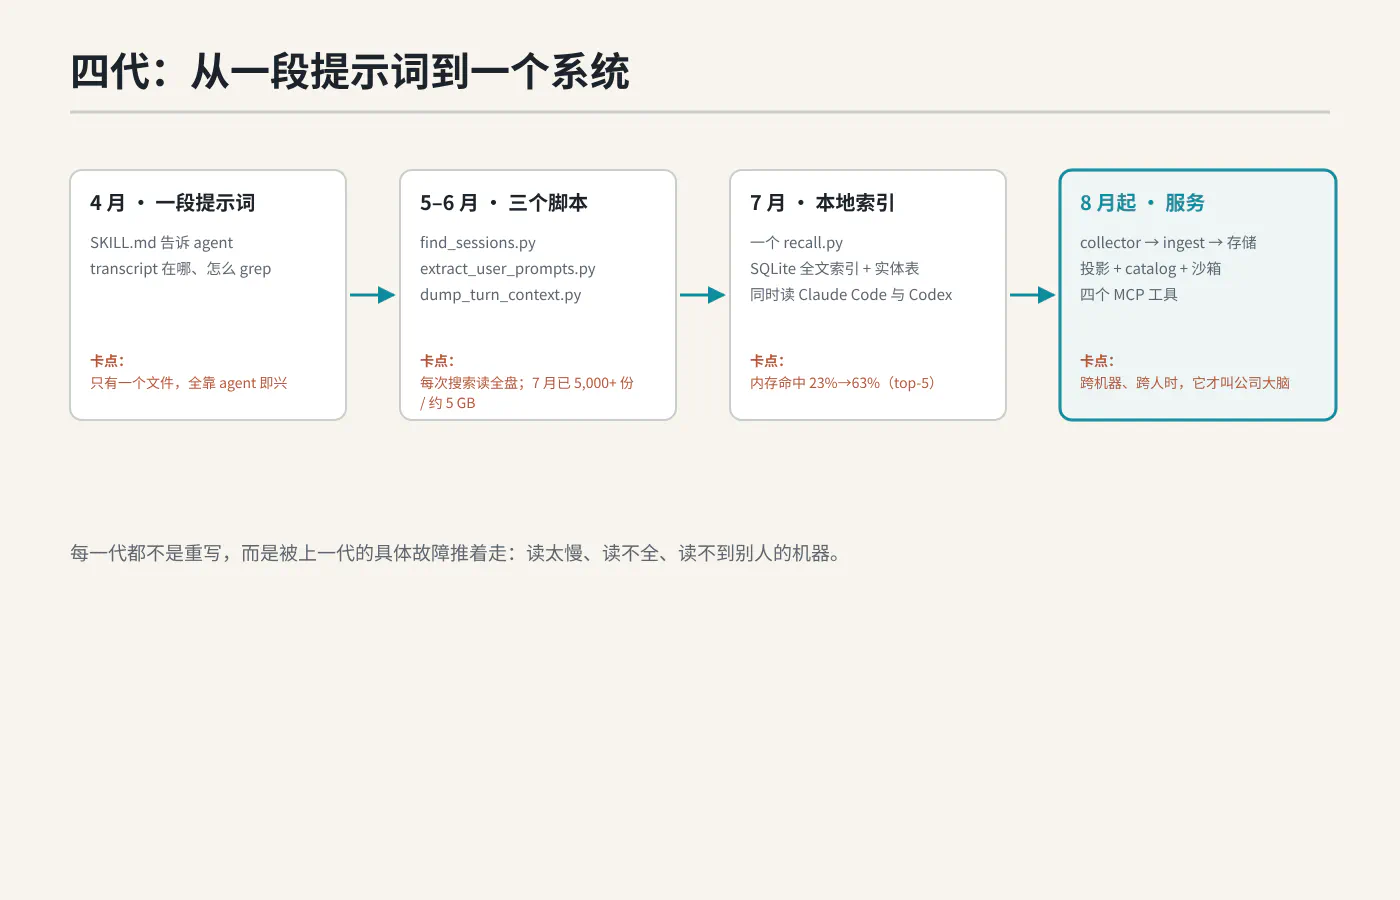
| 阶段 | 形态 | 触发的故障 | 关键数字 |
|---|---|---|---|
| 4 月 | 一段 SKILL.md,告诉 agent 转录在哪(~/.claude/projects 下每会话一个 JSONL)、怎么 grep | 全靠 agent 即兴,慢且不稳定 | 只有一份文件 |
| 5–6 月 | 三个脚本:find_sessions.py、extract_user_prompts.py、dump_turn_context.py | 每次搜索读全盘,且读不了 Codex | 7 月已 5,000+ 份、约 5 GB |
| 7 月 | 一个 recall.py:SQLite 全文索引 + 实体表(PR 号、文件路径、job id),两种 harness 都读 | 单机、单人的上限 | 57 题冻结集上 top-5 从 23% → 63%,搜索 15.7s → 0.16s |
| 8 月起 | 服务:collector → ingest → 存储 → 投影 → 沙箱,外挂四个 MCP 工具 | 需要跨机器、跨人 | 见下文 |
脚本写出来之后,agent 仍然大约每用一次脚本,就手动 grep 九次。工具没被采纳,不是因为不好用,而是因为它比「直接翻文件」还慢。
二、为什么叫 recall,而不是 answer#
作者把命名当设计:服务器的职责是别漏,精确是调用方的事。原话是让负责执行的那部分专注于精确——serverless 执行和 grep 都归精确一侧。
落到接口上,就是每个工具只返回指针 + 收据:会话 ID、命中的片段、以及这个片段在原文里的位置。agent 必须打开那个会话再引用。这条约束挡掉了检索系统最常见的堕落方式:把一段摘要喂给模型,模型把摘要当事实。
三、管道:原样存储在上游,其余全是投影#
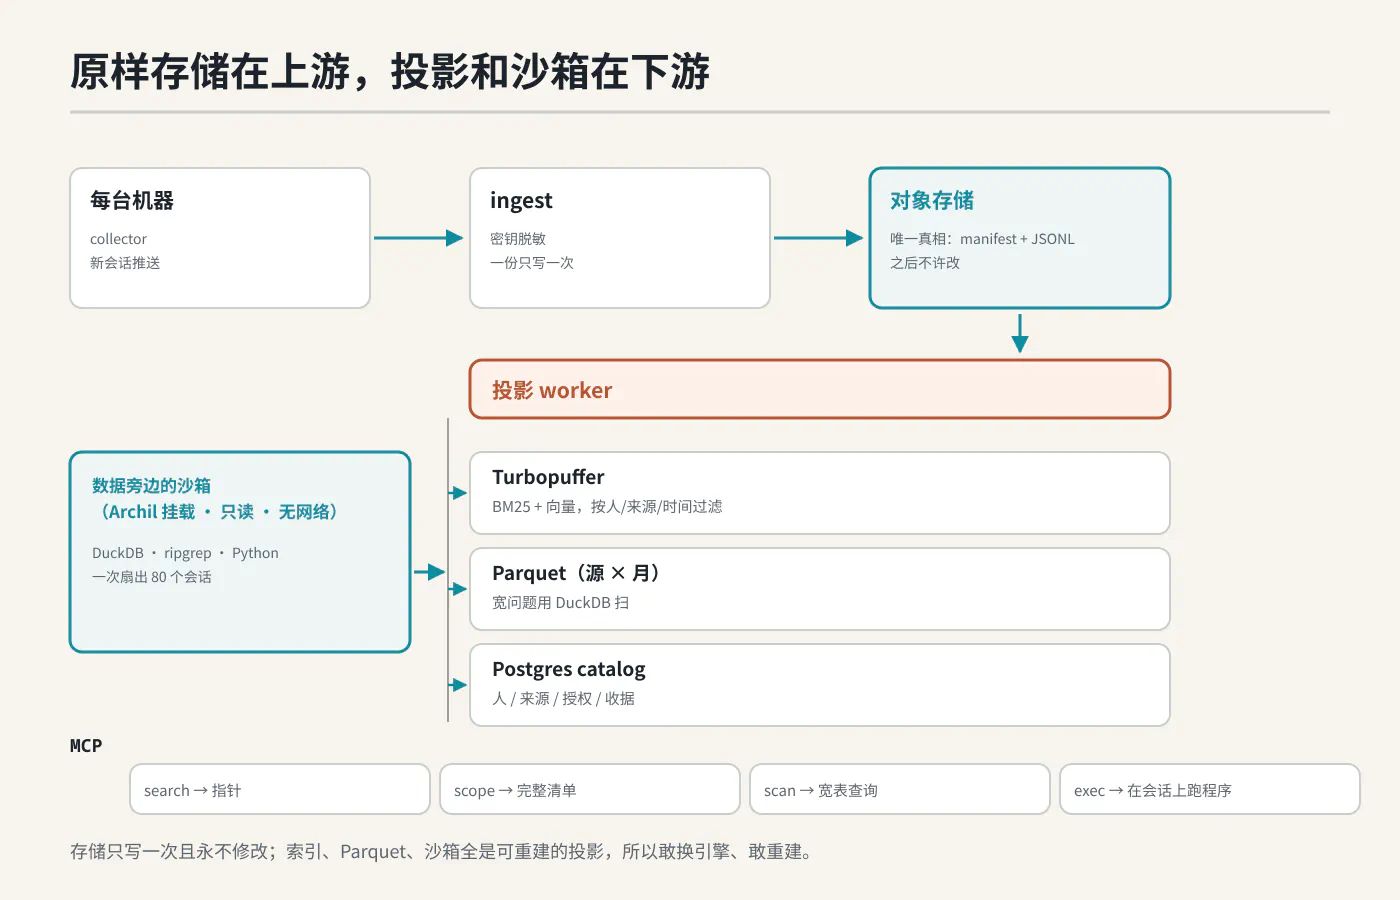
六个部件,每一个都能对上一个具体问题:
| 部件 | 为什么存在 | 代价 |
|---|---|---|
| collector(每台机器、每个账号) | 会话散在多台机器上 | 每台机器都要装、都要管凭据 |
| ingest:脱敏 + 一份只写一次 | 下游全从它派生,所以脱敏必须在这里 | 幂等要靠自己去重,写错一次就洗不掉 |
| 对象存储(manifest + JSONL) | 选它而不是 gbrain 的页面模型、也不是托管记忆 API,因为那些存的是摘要,他们要原文 | 存得多、扫得慢,靠下游补 |
| Turbopuffer 投影(BM25 + 向量,按人/来源/时间过滤,自己算嵌入) | 词与义要一起查 | 一个月 $800 的嵌入账单,逼他们把检索搬过去;索引重建要几小时 |
| Parquet(按来源 × 月) | 宽问题不该开会话 | 多一套管道要维护 |
| Postgres catalog(人/来源/授权/收据) | 每个工具调用前先查它,决定看得见什么 | 一个额外的、必须绝对正确的服务 |
| 沙箱(Archil 挂载,只读、无网络) | 把代码送到数据旁边,而不是把几 GB 会话搬到 agent 旁边 | 没有网络,能用的只有 DuckDB、ripgrep、Python |
这张表的重点是方向:所有会变的东西都放在下游。索引可以换引擎,Parquet 可以重刷,沙箱可以重开——因为上游那一份永远不会被改写。
四、四个工具,对应四类问题#
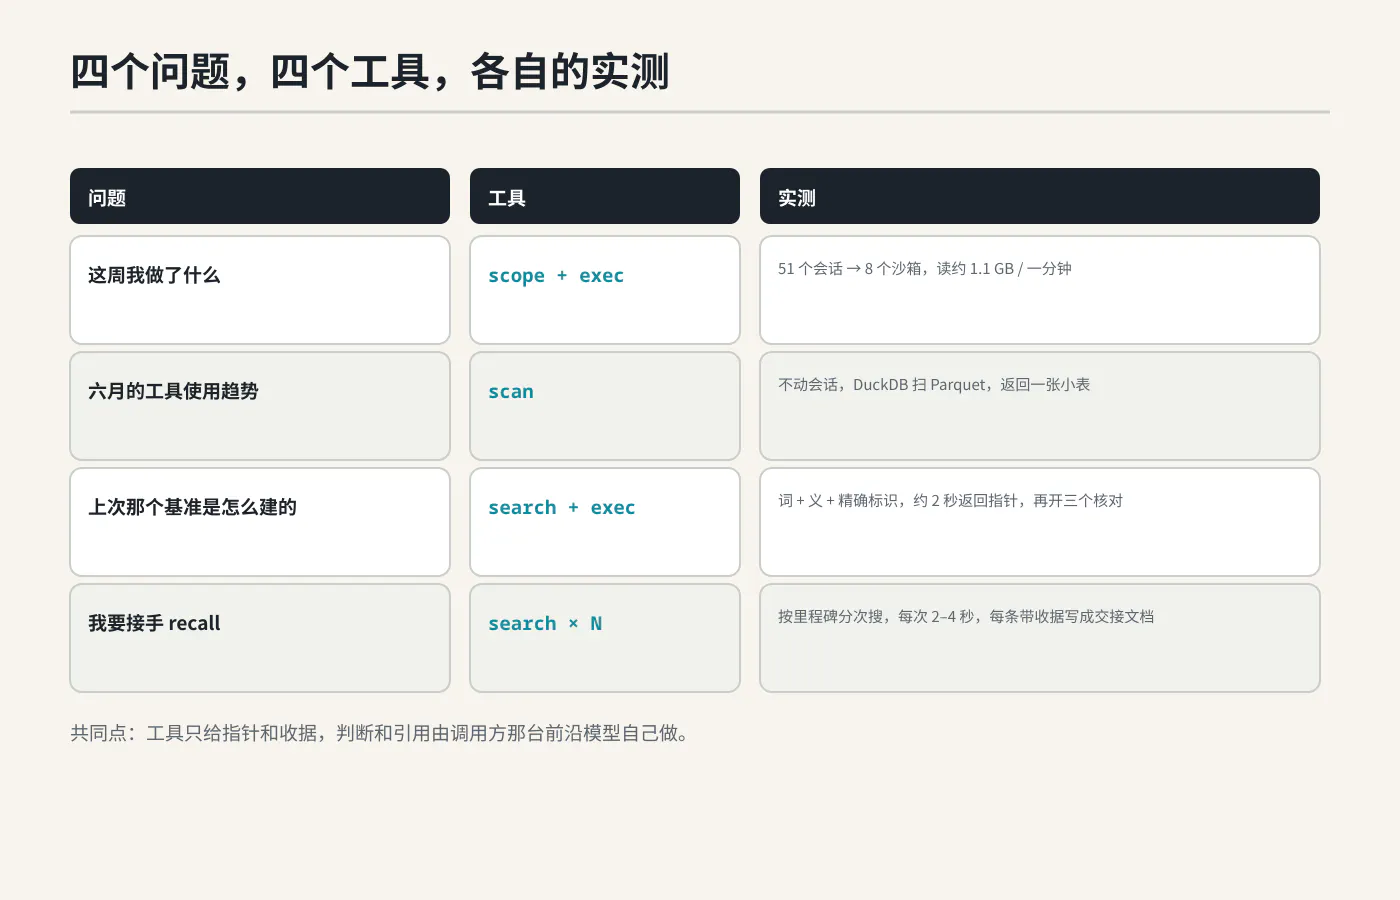
| 问题 | 工具 | 实际发生了什么 |
|---|---|---|
| 这周我做了什么 | scope + exec | 51 个会话,8 个沙箱并行,读约 1.1 GB 用了一分钟,没有数据离开存储,回到 agent 的只有几 KB |
| 六月的工具使用趋势 | scan | 一个会话都没打开,DuckDB 扫 Parquet 返回一张小表:Codex 从六月的小份额涨到九月中占多数,十月又回到约三分之一 |
| 上次那个基准怎么建的 | search + exec | 词、义、精确标识一起查再重排,约 2 秒返回指针;打开前三个核对,各带收据 |
| 我要接手 recall | search × N | 按里程碑分次搜,每次 2–4 秒;结果偏了就把时间窗收窄再搜。最后写成交接文档,每条结论都带脚注——这份文档直接成了下一个 agent 的 system prompt |
最后那条是全文最实用的技巧:把「交接」从「让下一个人重读会话」换成「产出一份带收据的文档」。作者说这甚至更好,因为文档里有会话之外的信息(决策、放弃的方案、从哪儿开始)。
五、把中间那个 agent 拿掉#
第一版服务里塞了一个 recall agent:你的 agent 问它,它搜完再回答。后来他们把它删了。理由很干脆:调用方本身就跑在前沿模型上,已经擅长拉证据、自己搜、自己总结;中间再放一个 agent,只会重复同样的工作,还顺手把证据藏起来。
这条决定反直觉,因为它省掉的是「看起来更智能」的那一层。但代价很清楚——如果检索层自己给答案,调用方就失去了核对的机会。
六、把它当产品来爬坡#
代码大部分是 agent 写的,作者把时间花在架构上。跑通之后他们开始「爬坡」:选指标、定目标、让 agent 朝目标改。
| 指标 | 之前 | 一周后 | 现在的及格线 |
|---|---|---|---|
| 搜索 p95 | 20 秒 | 1.4 秒 | < 2 秒 |
| 正确会话进 top-20 | 54% | 88% | — |
| 正确会话进 top-5 | 63%(本地索引期) | — | ≥ 90% |
这套东西后来也成了他们自己的观测工具:到十月底,53% 的 agent 会话读了记忆,26% 调了 skill;作者本人在 Claude 消息里的占比从夏天约 4% 降到 1% 以下。
七、代价与坑#
| 坑 | 具体表现 | 怎么绕 |
|---|---|---|
| 嵌入费失控 | 某个月 $800 | 把检索搬进托管索引,索引当投影、可重建 |
| 工具没人用 | 脚本 vs 手 grep 约 1:9 | 先量采纳率,再谈能力;慢了就是没用 |
| 摘要取代原文 | 托管记忆 API、页面模型都存摘要 | 只把原文当事实,摘要留作投影 |
| 权限散落 | 每个工具各自的过滤逻辑 | 统一走 catalog:调用前先解析授权 |
| 只有 skill 开源 | 仓库里只有 SKILL.md 与插件清单,实现与部署在其中 | 想复现得自己补后端;作者另开了 AgentRun 的 DSL 仓库 |
最后一条要说清楚:parcha-skills 里 13 个 skill、18,466 行 Python,但 recall 的引擎部分不在里面——recall/README.md 直说实现、安装器与部署配置另行维护。所以这不是「clone 下来就能跑」的开源项目,而是一份可读的设计加一层可用的 skill 接口。
八、想自己抄,按这四步#
- 先把原文存干净。对象存储 + manifest,写进去就不再改。没有这一层,后面每次换索引都要重来。
- 建一个 57 题式的冻结集。作者只用 57 个问题就量出了 23% → 63%。你自己的问题集大概也就是这个量级,别等有了评测平台再开始。
- 量一次「工具 vs 手动」的比例。他们发现 9:1 才动的手。你如果不知道这个数,就不知道新工具是不是白做。
- 工具从
scope和exec开始,别从search开始。前者只需要「范围 + 完整清单 + 能在数据旁边跑代码」,不需要先有好的排序质量。
九、开放问题#
- 沙箱无网络、只读,安全性好,但也意味着 agent 不能在里面装包、打补丁。遇到「需要新依赖才能解析」的会话,这条边界要不要开一个受控缺口?
- 原文在上游、投影在下游,代价是投影重建要几小时。如果团队到了上百人、会话量再上一个量级,这个重建窗口还够用吗,还是要做成增量的?
- 把交接写成带收据的文档,本质是把「人」的隐性知识变成可引用的对象。如果每件事都这么做,文档会不会变成第二种没人读的日志?
参考#
- 原文:https://x.com/miguelriosen/status/2118075831780340092
- skill 仓库:https://github.com/Parcha-ai/parcha-skills
- gbrain(他们仿过的项目):https://github.com/garrytan/gbrain
- AgentRun:https://github.com/Parcha-ai/agentrun