不建向量库:SAG2 用一个 25.87 MiB 的 SQLite 索引拿到 86.62 召回
SAG2 把语义判断从建库挪到提问之后。一个 SQLite 索引加 BM25 与 JEV 判断,在 MuSiQue、2WikiMultiHopQA、HotpotQA 上拿到对比方法里最高的 R@5 与 R@10,建库 2.36 秒、零次模型调用。消融把增益拆成两轮扩张与共享上下文两块,代价写在最后一节。
语义判断可以挪到提问之后。索引只留词与词频,一个 SQLite 文件,建库 2.36 秒,MuSiQue 的 R@10 从 54.41 抬到 86.62。
原文是《SAG2: Embedding-Free Multi-Hop Retrieval with BM25 and JEV》,Zleap AI 的 Yuchao Wu,arXiv 编号 2610.22588,全文 15 页(arXiv 页面 ,PDF )。代码在 Zleap-AI/SAG-Benchmark 。它是同一位作者前作 SAG 的续篇,SAG 用 MySQL 存事件与实体、用 Elasticsearch 存向量,这篇把两者都去掉。下面每个数字都能回到原文的表号,凡是我自己除出来的都标「我算」。
一、埃里克·霍特的出生地#
附录 A 里有一道具体的题,问埃里克·霍特出生在哪。语料里有一段讲霍特本人,它直接命中问题,也进了 BM25 的前一百。另一段讲蒙特贝洛,纽约州的那个地方,只有在知道「霍特出生在蒙特贝洛」之后才有用,而它和原问题的词重叠几乎为零,前一百里没有它。
SAG2 的流程是这样转的。种子只能从高分段落里取,霍特那段正好在里面。种子正文里的「蒙特贝洛」被当成一个可用的词,权重按四个因子算出来,然后拿这个词单独去查一遍索引,蒙特贝洛那段就进来了。最后十条里两段都在,这道题的召回从 50% 变成 100%。
这道题不是孤例。一千道 MuSiQue 题里,有 389 道的最终结果包含至少一段不在初始 BM25 前一百里的证据,这样补进来的段落一共 433 段。BM25 的 R@10 是 54.41,套上这套流程是 86.62。
| 指标 | BM25 | SAG2 | 差 |
|---|---|---|---|
| MuSiQue R@10 | 54.41 | 86.62 | +32.21 |
| MuSiQue 全证据率 AE@10 | 17.40 | 69.50 | +52.10 |
| 2WikiMultiHopQA R@10 | 71.50 | 97.43 | +25.93 |
| HotpotQA R@10 | 86.90 | 99.00 | +12.10 |
差的这 32 点里,没有一次向量运算。
二、之前到哪一步了#
多跳检索的老问题是「中间那段怎么找」。三族做法各自卡在一个位置。
| 一族 | 代表 | 天花板在哪 |
|---|---|---|
| 稠密召回 | Contriever、BGE、GTE-Qwen2、NV-Embed-v2 | 编码器建库时定死,查询只能改写,不能改候选 |
| 结构化增强 | SAG、HippoRAG 2 | 建库要抽实体或建图,抽错就永久少一条边 |
| 伪相关反馈 | RM3、BERT-QE、GAR | 反馈文本靠启发式挑,或要预先算好邻居图 |
第二族在这篇的表格里最强。同一张表上,NV-Embed-v2 在 MuSiQue 的 R@10 是 77.27,SAG 是 83.37,SAG2 是 86.62。结构带来的提升比换更大的编码器更明显,这也是它值得继续走的原因。
SAG 的代价在准备阶段。它要用大模型把语料抽成事件与实体记录,再单独算一遍向量,两个数据库各存一半。作者在附录 D 里给了前作的建库账,4.57 小时、28.26 百万 token。这个数字和 SAG2 的 2.36 秒不在一个量级上,硬件与模型配置也不同,论文特意写明这不是同口径的测速。
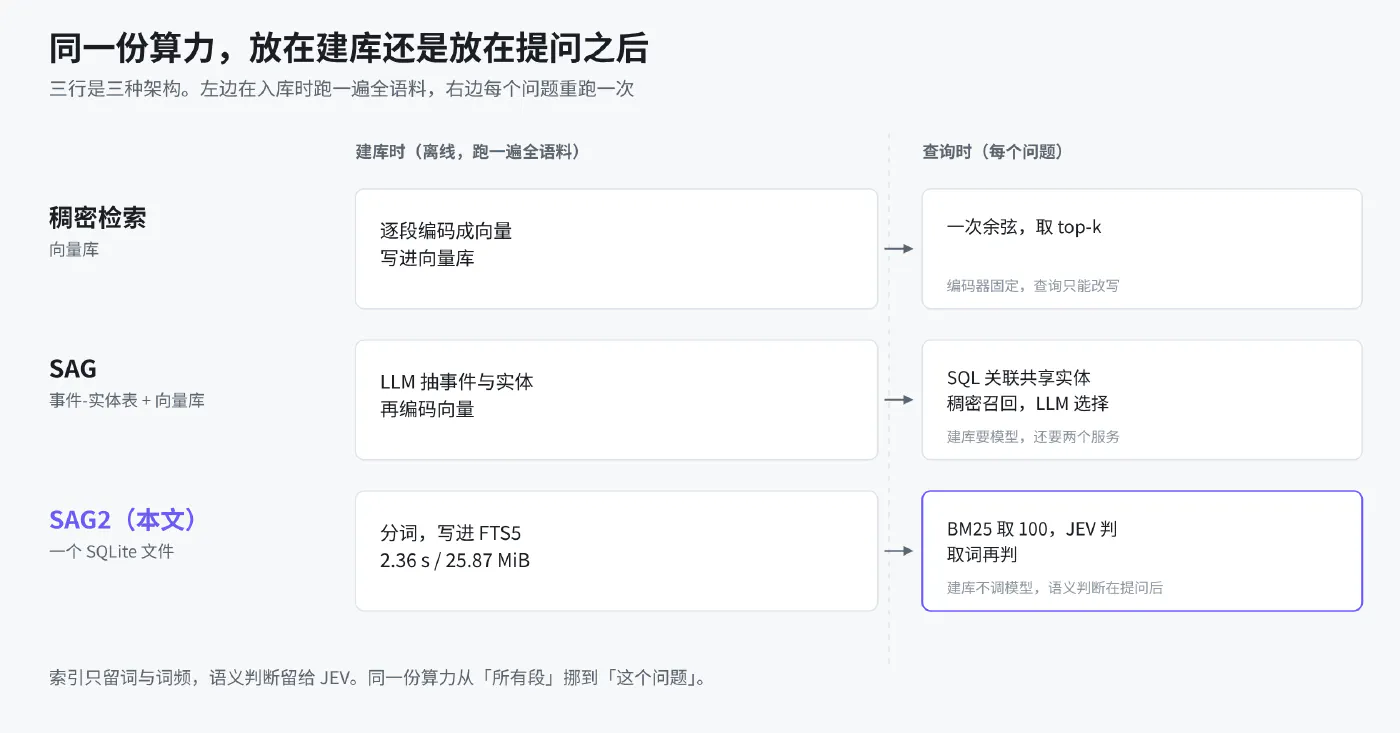
SAG2 换掉的正是这一段。它保留 SAG 的原则,把关联放到查询时按问题算,但索引里只放原文和词频。
三、一个文件,三次打分#
索引阶段只有本地文本处理。语料按相邻段落合并到 2,200 字符左右,超长段落保持完整,然后分词写进 SQLite 的 FTS5,字段是标题、小标题、正文,BM25 权重 2、2、1。MuSiQue 的 11,656 段全部进库用了 2.36 秒,文件 25.87 MiB,模型调用零次,费用零。
查询阶段是三次打分,两次扩张。
第一轮用问题分词后最多 80 个词做 OR 查询,取前 100 条,交给 JEV 逐条判一次,此时上下文为空。判完取前十名里还没扩张过的 10 段当种子,从种子正文里选 20 个扩张词,每个词单独查一次索引,按词的优先级交错合并,攒够 100 条新候选。候选池是受保护的初始 5 段、累计种子、新候选三块的并集,去重后 115 条,全部重判一次。
第二轮重复同样的动作,但新候选只放开 20 条,剩下的名额用历史分数靠前的旧候选填满,池子 125 条。默认最多两轮扩张,也就是三次打分,之后不再调模型,只做一次本地重排,把前十名用 TF-IDF 余弦加行列式点过程调一下顺序,第一位不动。
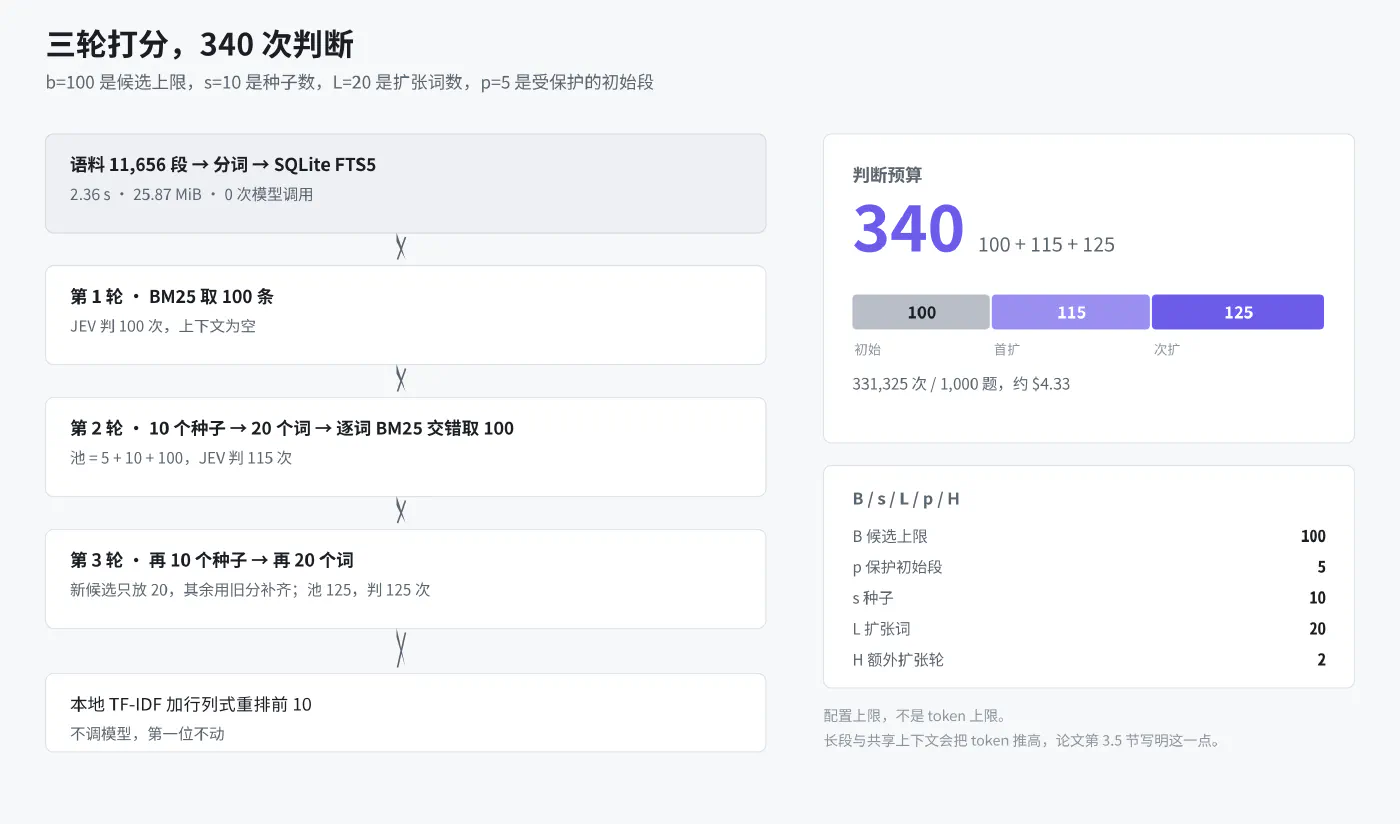
340 这个数是配置算出来的(我算,论文第 3.5 节给了同样的分解)。它数的是判了多少条,不是发了多少 HTTP 请求,也不是花多少 token。一条长段落、一段十段的共享上下文,都会让单次判断变贵,论文自己把这句话写在了上限旁边。
四、判据是一条是非题#
整篇最值得抄走的东西是那段提示词。JEV 的 Noul 接口接收一段自然语言上下文和若干问题,返回每个问题答 yes 的概率,不生成推理过程。SAG2 用它问一件事,这条候选本身是不是一条完整答案链里必需的事实。
四句限定把这件简单的事说得比较严。
- 中间环节的识别事实也算,霍特出生在哪这种中间答案要判 yes。
- 上下文只能用来连接事实,不能把只出现在上下文里的事实算到候选头上。
- 只要沾边、或者只是可选背景,都不算。
- 不许用外部知识。
第三句是防止判断模型被自己的上下文骗。第四句是防止它用常识补齐语料里没有的桥。这两条一加,同一条候选在不同轮次可以拿到不同的分数,分数是带状态的。
| 轮次 | 上下文 | 判多少条 | 候选池 |
|---|---|---|---|
| 第一次 | 空 | 100 | 初始 100 |
| 第二次 | 种子加前 10 条新候选 | 115 | 5 + 10 + 100 |
| 第三次 | 上一轮前十与它们的暂定分,并要求对着引用的事实重估 | 125 | 5 + 20 + 100 |
扩张词的挑选也不是随手取高频词。每个词的优先级是四个因子的乘积,取所有种子里的最大值。
a_r(t) = max over seeds d [ (1 + log tf(t,d)) · I(t) · (1 + g_q(t,d)) · w_r(d) ]
I(t)   = log(1 + (N - df(t) + 0.5) / (df(t) + 0.5))
w_r(d) = 0.5 + 0.5 · s_r(d) / max_s          (区间 0.5 到 1)
四项分别管频率、稀有度、与原问题的连接、种子自身的证据分。w 的下界是 0.5,分数低的种子降权而不丢弃。g_q 那一项是个细节,一个词可能出现在种子的好几个句子里,取与原问题共享稀有词最多的那个句子,这样「蒙特贝洛」这种出现在关键句里的词会浮上来。
五、三个基准的召回#
一千道题的开发集,语料是题目自带的支撑段与干扰段。三个数据集上 SAG2 的 R@5 与 R@10 都是九种方法里最高的,SAG 与 HippoRAG 2 跟在后面。
| 方法 | MuSiQue R@1 | R@5 | R@10 | 2Wiki R@10 | HotpotQA R@10 |
|---|---|---|---|---|---|
| BM25 | 28.53 | 47.47 | 54.41 | 71.50 | 86.90 |
| NV-Embed-v2 | 34.02 | 68.84 | 77.27 | 80.75 | 97.70 |
| HippoRAG 2 | 30.65 | 65.13 | 73.76 | 93.40 | 97.15 |
| SAG | 36.82 | 80.36 | 83.37 | 93.57 | 97.70 |
| SAG2 | 34.30 | 80.68 | 86.62 | 97.43 | 99.00 |
MuSiQue 的 R@1 和 R@2 是 SAG 更高,36.82 对 34.30,63.62 对 62.18,SAG2 的优势要把截断放宽到 5 和 10 才出现。HotpotQA 上 SAG 与 NV-Embed-v2 的 R@10 都是 97.70,SAG2 的 99.00 只多 1.30 点,这道题的语料本来就容易。
按标注跳数拆开看,结论更清楚。跳数越多,第二次扩张带来的增量越大,2 跳加 2.32 点、3 跳加 3.27 点、4 跳加 6.17 点(最后一项逐项相减是 6.18,论文写 6.17,差在小数进位)。
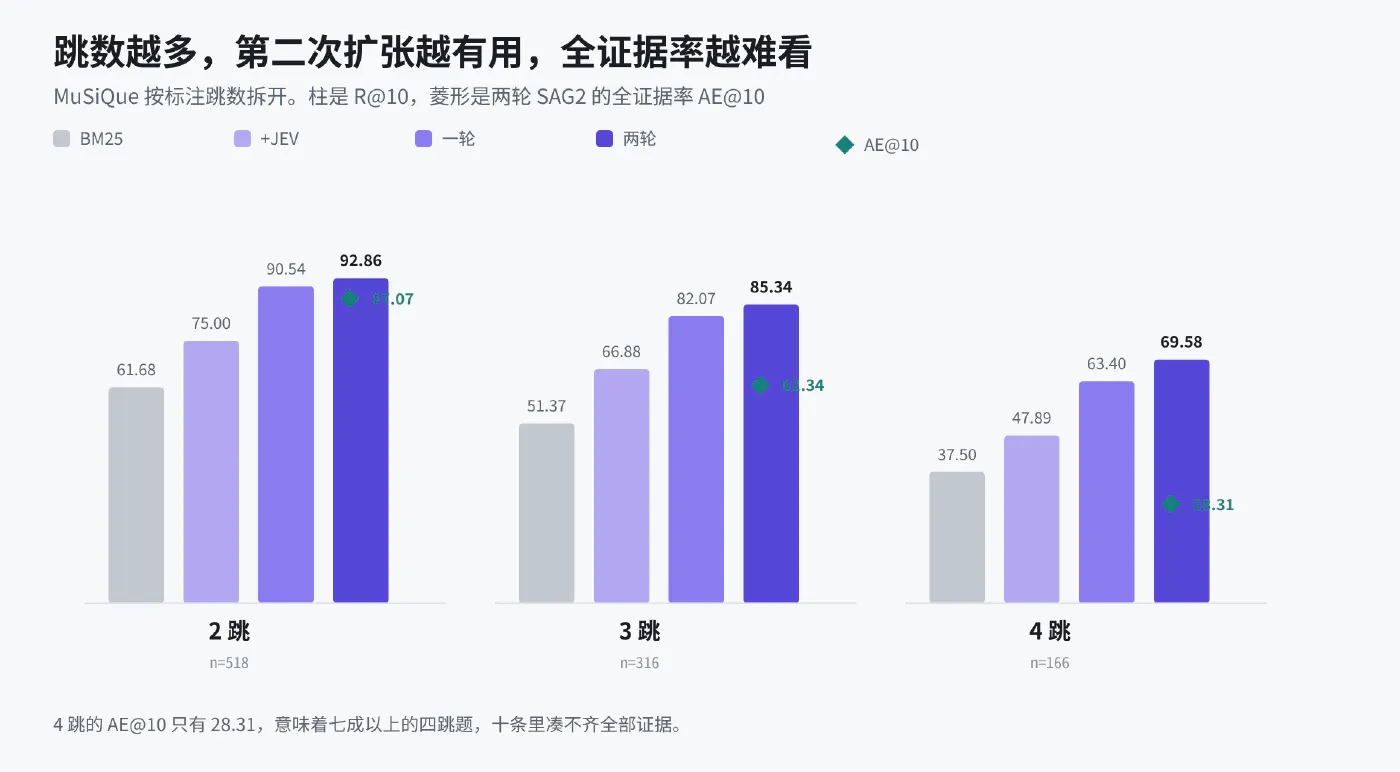
四跳的 AE@10 只有 28.31。全证据率按整条证据链算,比召回率严格,七成以上的四跳问题,十条结果里凑不齐全部证据。词法入口补得上中间那一段,补不上从头到尾的四段。
六、五十万篇企业文档#
第二个实验换了场景。EnterpriseRAG-Bench 是合成的企业内部通信集合,51.2 万篇文档,包括消息、邮件、工单、会议记录。切片约 1,000 字符,上限 1,200,参数一个没改,按源文档去重后取前十。
| 题型 | n | BM25 | 向量 | Bash Agent | SAG2 |
|---|---|---|---|---|---|
| 基础问答 | 175 | 77.7 | 48.6 | 61.7 | 86.86 |
| 语义改写 | 125 | 43.2 | 24.8 | 29.6 | 58.40 |
| 文内推理 | 40 | 90.0 | 57.5 | 75.0 | 100.00 |
| 项目相关 | 40 | 65.5 | 49.2 | 43.2 | 83.58 |
| 带约束 | 30 | 85.0 | 83.3 | 78.3 | 96.67 |
| 信息冲突 | 20 | 82.5 | 55.0 | 72.5 | 92.50 |
| 完整性 | 20 | 46.5 | 33.4 | 59.0 | 76.24 |
| 杂项 | 20 | 90.0 | 75.0 | 100.0 | 100.00 |
| 总体 | 470 | 68.4 | 46.0 | 55.8 | 81.10 |
这张表最刺眼的是向量那一列。46.0 不但低于 BM25 的 68.4,还在每一类上都低,语义改写那类只有 24.8。论文引的是基准发布方给出的数,我没有复现。一个解释是内部语料里全是产品名、工单号、人名,向量把这些专有串磨平了,词法反而原样匹配。
SAG2 在这一列上到 81.10。项目相关 83.58 与完整性 76.24 两行是扩张真正帮上忙的地方,这两类问题的共同点是答案分散在多份文档里,只看一份不够。语义改写只有 58.40,词法入口救不回一个共同词都没有的问法。
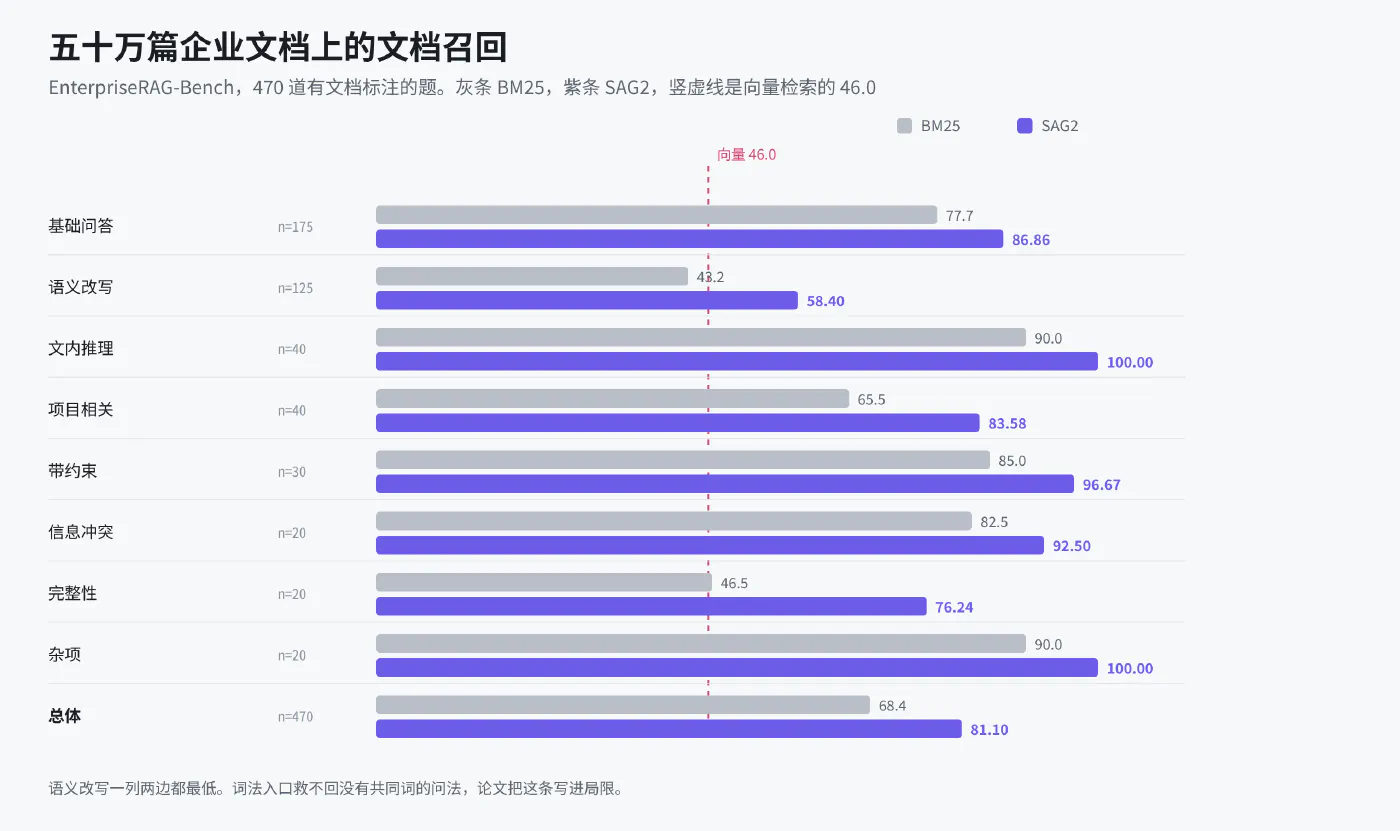
Bash Agent 的 55.8 那一列不能直接比,它的输出集大小不固定,不是固定取十篇。论文自己写了这一条,也没有给三者对齐算力预算。
七、增益不在候选池#
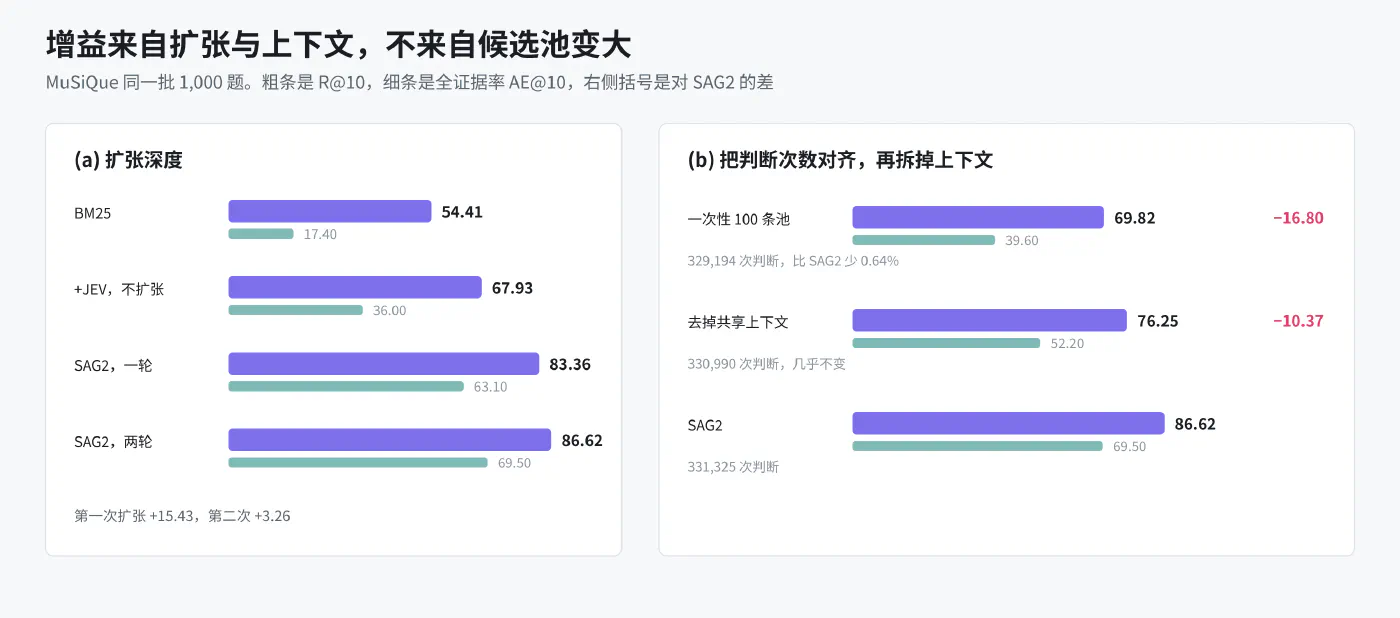
这套东西最容易被误读成一件事,就是把候选池做大。论文用三个对照把这件事拆开了,三组都在同一千道 MuSiQue 题上跑。
| 对照 | 改动 | R@10 | 与 SAG2 的差 | 判断次数 |
|---|---|---|---|---|
| 扩张深度 | BM25 直接排 | 54.41 | −32.21 | 0 |
| 加 JEV 但不扩张 | 67.93 | −18.69 | 99,925 | |
| 扩张一轮 | 83.36 | −3.26 | 211,081 | |
| 扩张两轮 | 86.62 | 0 | 331,325 | |
| 判断预算 | 一次性 100 条池,判满同样的次数 | 69.82 | −16.80 | 329,194 |
| 共享上下文 | 保留扩张策略,去掉共享证据 | 76.25 | −10.37 | 330,990 |
不扩张、只让 JEV 重排一次,拿到 67.93,判断模型本身值 13.52 点。第二行到第三行值 15.43 点,来自一轮扩张。第三行到第四行值 3.26 点,边际收益掉下来了,作者把一轮的配置标成更便宜的工作点,少 36.29% 的判断(我算)。
判断预算那一组最能说明问题。对照组把每条题目的一次性候选池拉到 331 条左右,判满 SAG2 用掉的次数,池子比单轮的 100 条宽三倍多,R@10 只有 69.82,差 16.80 点,两者判断次数只差 0.64% 我算。剩 984 道题做成严格等次数的子集,差 16.62 点,结论不变。把预算换成容量不管用,把预算换成「分两轮花」才有用。
上下文那一组拆的是另一半。保留扩张策略、去掉共享证据,R@10 掉到 76.25,全证据率从 69.50 掉到 52.20,判断次数几乎没变。这 10 点来自后一轮看得见前一轮读过什么,和判多少条无关。
论文还比了三个替代方案。RM3 单独用比 BM25 差,47.83 对 54.41。GAR-BM25 加上末轮 JEV 到 73.11,判断次数只有 10 万,比 SAG2 少 69.82%,召回低 13.51 点。这两个数是这套架构与已有反馈方法的真实距离,也说明钱花在中间的每一轮是有回报的。
八、代价#
| 项 | 数值 | 性质 |
|---|---|---|
| 建库时间 | 2.36 秒 / 11,656 段 | 论文实测 |
| 索引体积 | 25.87 MiB | 论文实测,约 2.27 KiB 一段(我算) |
| 建库模型调用 | 0 次,$0 | 论文实测 |
| 查询模型费用 | 100 题 $0.433769,1,000 题 $4.326379 | 论文实测,单题约 $0.0043(我算) |
| 单次判断费用 | 约 1.3e-5 美元 | 我算,按 331,325 次除 |
| 判断次数上限 | 340 每条问题 | 配置推出,不计 token 与延迟 |
| 在线延迟 | 未报告 | 论文说明并发混在一起,没法分离 |
| JEV 权重 | 未公开 | 只有托管 API,模型版本 typesafe/jev-1.13-20260917 |
最后两行是这套东西真正的门槛。索引在本地,判断在别人的服务上,问题与候选正文都要出网。企业内部语料碰上数据不出域的规矩,这套架构就停在图纸上。作者把这个风险写在局限一节,也把「可本地部署的判断模型」列为下一步,没有给出可行的时间表。
第二处代价在索引侧。新证据必须和某个扩张词有字面匹配,而扩张词是从上一轮证据的正文里选出来的。同义词、别名、缩写,以及完全没有共同词的说法都进不来。附录 A 那个蒙特贝洛的例子成立,是因为那段正文里恰好写着这个词。语义改写那一列 58.40 就是这个缺口的价格。
第三处是可比性。SAG 那一行用的是 BGE-Large 加 Qwen3.6-Flash,SAG2 用的是 JEV,两个完整系统各自带着自己的判断模型比,差出来的 3.25 点不能全记在架构头上。论文在局限里承认了这一点。
九、怎么自己核,以及两个还没答案的问题#
能在一小时内复现的部分不多,能核的部分不少。
| 要核什么 | 去哪里 | 看什么 |
|---|---|---|
| 340 怎么来的 | 第 3.5 节与表 C1 | 100 + 115 + 125,池子三块并集 |
| 增益是不是预算 | 附录 B.1 | 329,194 对 331,325,差 0.64% |
| 上下文值多少 | 图 5 右半与表 A1 | 86.62 到 76.25 |
| 扩张词怎么算 | 第 3.3 节公式 | 四项乘积,种子权重下界 0.5 |
| 判据原文 | 附录 C | 四句限定,尤其「上下文只用来连接」 |
| 建库账 | 表 3 与表 D1 | 2.36 秒、25.87 MiB、零模型调用 |
想动手的话,取一份自己的语料,用 SQLite FTS5 建索引,把前一百条的标题与正文拼成一条是非题,问一个便宜模型「这条是不是答案链里必需的一步」,拿到概率重排。这一步不需要 JEV,任何能给 yes 概率的模型都能试。如果重排之后的召回比 BM25 高出十几点,第二步的扩张就值得写。
第一个还没答案的问题是扩张的边际收益在哪停。一轮值 15.43 点,两轮值 3.26 点,曲线在这里已经很平,第三轮会不会变成负数,论文没跑。340 次判断那条上限是按两轮算的,如果真实语料的段落更长、候选更多,这个上限会先被 token 顶破。
第二个问题在索引规模上。MuSiQue 的语料只有 11,656 段,BM25 前一百条里已经包含大部分相关证据。换成五百万段的私有语料,前一百条的起点会更差,第一轮的种子质量会跟着掉,整套流程依赖「种子还不错」这个前提。企业那一组做到 51.2 万篇,拿到的是文档级召回,没有回答第一轮种子质量下降多少。这个数决定了它在真实库里能不能用同一套参数。
参考#
- Wu, Y.《SAG2: Embedding-Free Multi-Hop Retrieval with BM25 and JEV》,arXiv:2610.22588,2026 年 10 月。https://arxiv.org/abs/2610.22588
- Wu, Y. 等《SAG: SQL-Retrieval Augmented Generation with Query-Time Dynamic Hyperedges》,arXiv:2606.15971,2026。https://arxiv.org/abs/2606.15971
- Sun, Y. 等《EnterpriseRAG-Bench: A RAG Benchmark for Company Internal Knowledge》,arXiv:2605.05253,2026。https://arxiv.org/abs/2605.05253
- 代码与评测脚本。https://github.com/Zleap-AI/SAG-Benchmark
- TypeSafe,Jev 的 Noul 接口文档。https://typesafe.ai