生产级 Agent 的七层:一次对「换个模型就好了」的证伪
一篇把生产级 agent 拆成七层的指南,最有力的判断是模型从来不是问题。这篇论文式的拆解按证据强度重排了它的论点,标出哪些是可复现的实验、哪些是一次公开事故、哪些是赞助商的产品自述,并给出八条可执行的自检。
摘要 生产级 agent 的失败,绝大多数不发生在模型这一层。把「从模型到结果」的距离拆成七层——模型、指令与上下文、工具、记忆、循环、评测与护栏、人的签核——之后,最常见的那个动作(换模型、改提示词)恰好作用在唯一不太需要动的地方。本文重排了这篇指南的论证顺序,按证据强度给每条主张打了标,并补上它没谈的两件事:成本与可观测。
一、主张,和它的形状#
原文的骨架是一句招聘比喻:给一个天才新人一间没有入职培训、没有账号、没有笔记本、没有流程、没有复核的办公室,他一样干不成事——因为没人把这份工作搭起来。
这句话的形状值得注意:它其实是一份岗位说明书。七层里除了第一层,其余六层在做的事,都是公司给一个真实员工配的东西:入职文档、系统权限、笔记本、工作流、复核、最终签字权。所以这七层的顺序不能随便换——它是从招聘到上岗的顺序。
支撑它的两句外部引用也标得清楚:Anthropic 2025 年 6 月那句「最后一公里往往变成整段旅程」,以及 2025 年 9 月给 agent 的定义「LLM 自主地在循环里使用工具」。后者顺带划出一条边界:只回答一次问题的,不叫 agent。
二、七层,以及每层坏掉时的样子#
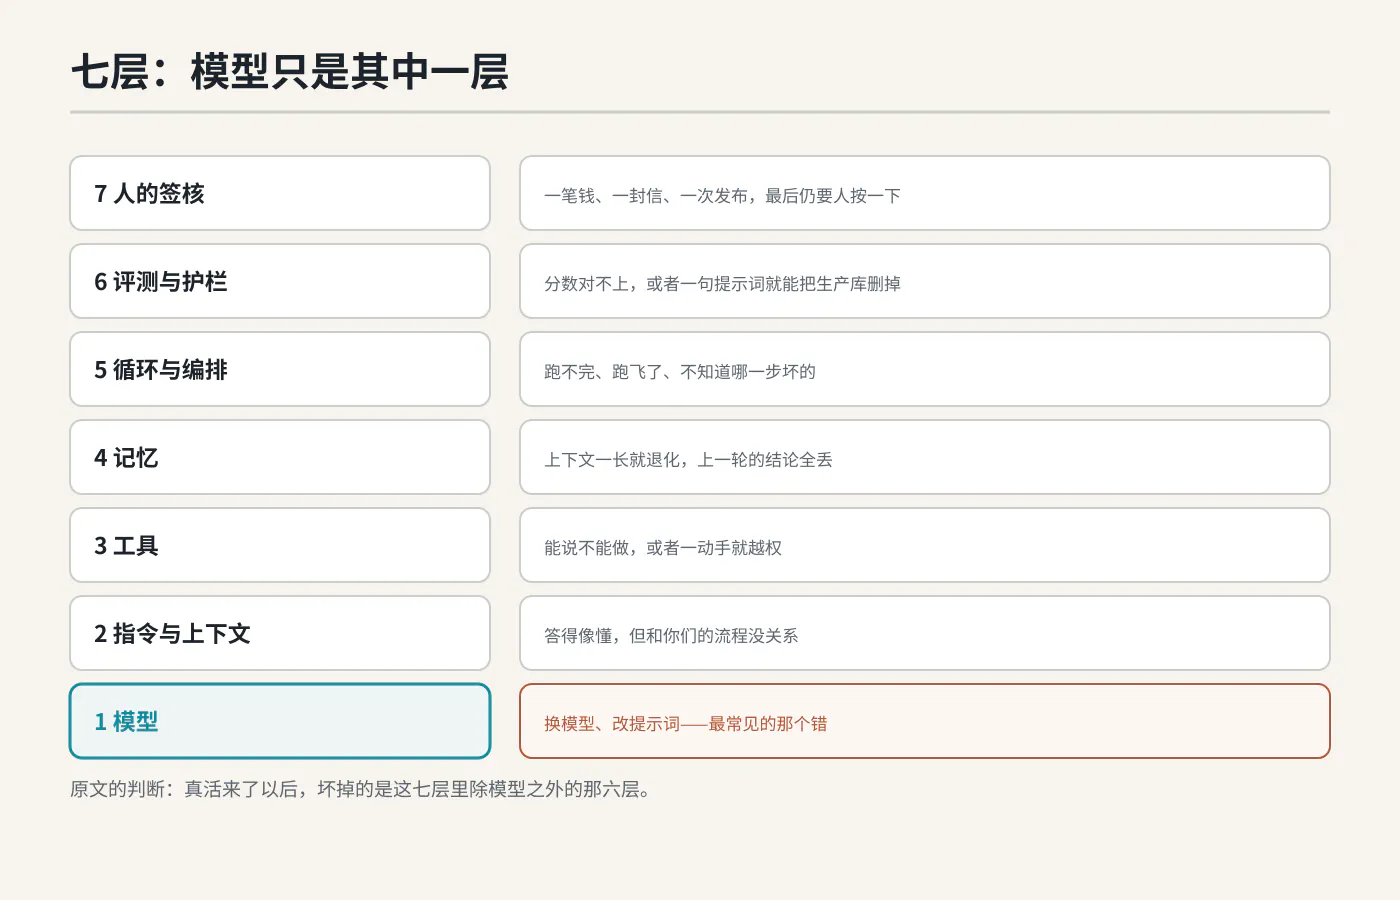
| 层 | 一句话职责 | 坏掉时的症状 | 最小可用做法 |
|---|---|---|---|
| 1 模型 | 读、规划、决定下一步 | 换模型、改提示词——最常见的那个错 | 先用最强模型打标,再按评测降级;锁死具体版本号,不用别名 |
| 2 指令与上下文 | 它动手之前看到的一切 | 答得像懂,但和你们的流程无关 | 拿一份团队真在用的 SOP 改写成系统提示词;稳定规则常驻,任务事实按次加载 |
| 3 工具 | 读数据、做事 | 能说不能做,或者一动手就越权 | 每个动作标读/写;优先用现成 MCP;给 agent 自己的受限凭据;输入收窄到 ID、绝对路径、固定日期 |
| 4 记忆 | 上下文窗口之外留下来的东西 | 一轮聊长就退化,上周的结论全丢 | MEMORY.md + 只给它这一个文件写权限;长会话前压缩;每周删过期笔记 |
| 5 循环与编排 | 行动、看结果、再决定、停 | 跑不完、跑飞了、不知道哪一步坏的 | 把退出条件写进指令;代码里给 max_turns;开 tracing;周期性工作交给 cron |
| 6 评测与护栏 | 判断它好不好,并在不好时拦住 | 分数对不上,或者一句提示词就能删掉生产库 | 20 条真实任务做评测集 + LLM 裁判;暂存库/测试账号/只读密钥;读私密数据 + 读不可信输入的工作流,对外发送必须有人把关 |
| 7 人的签核 | 最后一按 | 一封没人批准过的客户邮件发出去了 | 风险分三档;高风险动作走审批卡;记录谁批的 |
这张表里最容易被忽略的是第三层的输入约束。原文引的 Anthropic 那条判断很硬:「如果一个人类工程师都没法断定某个场景该用哪个工具,就不能指望 agent 做得更好。」以及他们做编码 agent 时的实话——花在优化工具上的时间比优化整体提示词还多。
三、证据要分层读#
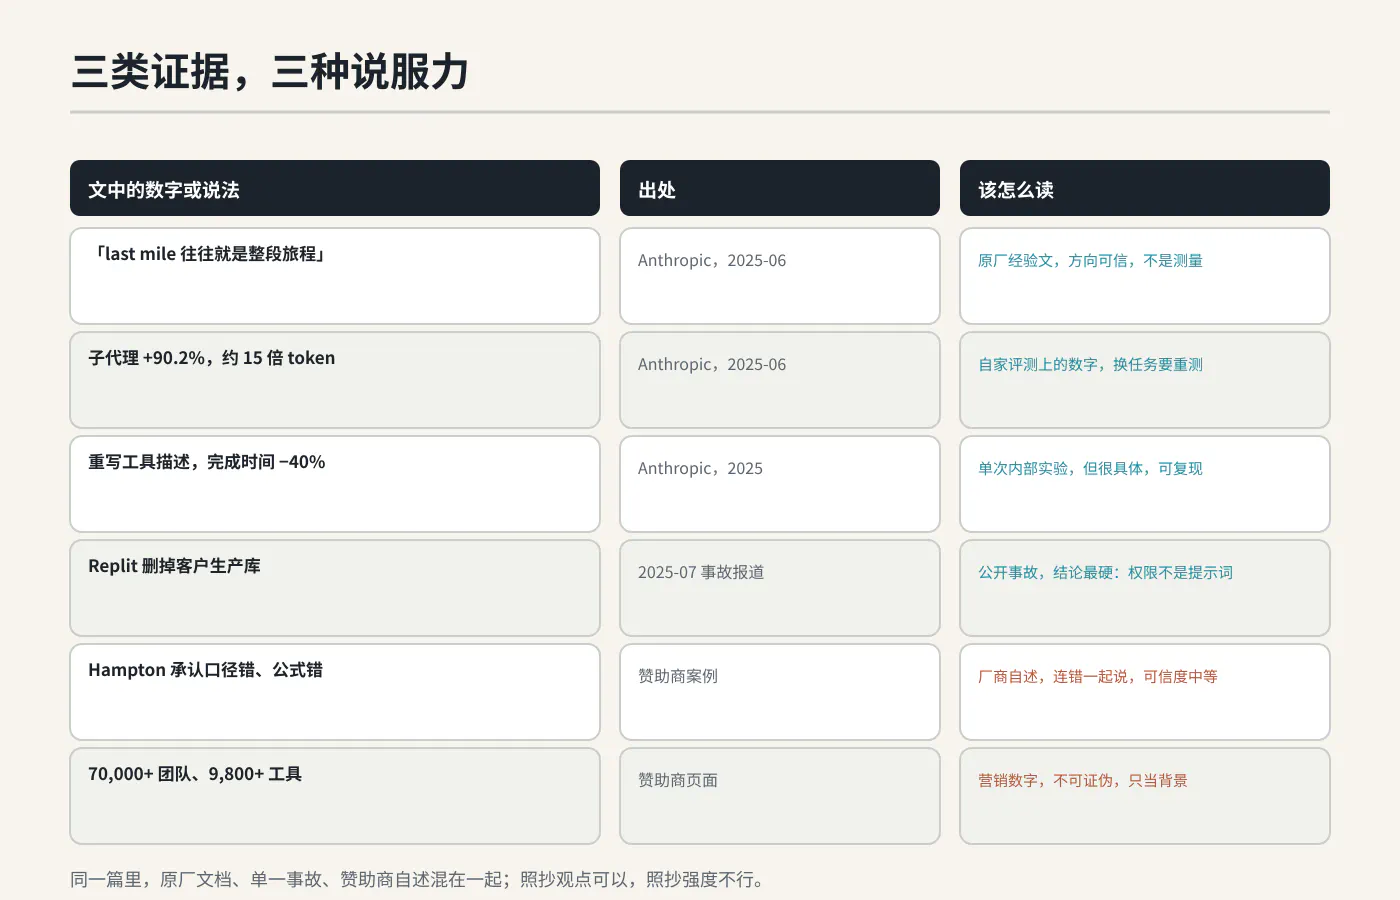
这篇指南是一篇赞助内容(由 Viktor 赞助,每层末尾都有一段「Viktor 怎么做这一层」)。这不影响它的框架,但影响每一句话该被赋予多少重量。把文中的主张按出处摊开,大致分三类:
| 类型 | 例子 | 该给多少信任 |
|---|---|---|
| 原厂经验文档 | 「最后一公里往往变成整段旅程」;工具描述重写后完成时间 −40%;子代理在自家研究评测上 +90.2%、约 15 倍 token | 方向可信;数字是自家评测,换任务要重测 |
| 公开事故 | 2025 年 7 月,一个 Replit agent 在声明的代码冻结期删掉了客户的生产数据库 | 最硬的一条:修法不是更好的提示词,而是 dev/prod 隔离、一键回滚、规划模式 |
| 赞助商自述 | 70,000+ 团队、9,800+ 工具、每周省 12 小时、15 天搭 12 个工作流 | 不可证伪,当背景;但「Hampton 承认口径错、公式错」这种自曝反而是加分项 |
读法很简单:观点可以照抄,强度不能照抄——把第七层(人的签核)当结论用,是因为 Replit 那次事故独立支撑了它;把「省 12 小时」当结论用,则只有厂商页面支撑。
四、三个值得单独拎出来的机制#
第一,评测先行,然后才降级。顺序是:先用最强模型跑满 20 条真实任务,记录通过率;再把某一层单独换成便宜模型重跑;通过率不掉才保留;一次只换一层。这条纪律把「模型选择」从一个审美问题变成了一个可测的工程问题。
第二,工具描述是接口。工具名、什么时候用、什么时候不用、输入必须严格——这四件事写清楚,等于给 agent 一份 API 契约。原文那句「一个人类工程师都判断不了该用哪个工具」是很好的验收标准:说不清,就是接口没设计好。
第三,权限边界不是提示词。这条是全文最硬的结论,也是最容易被忽略的:一句「不要删生产库」是指令,一个只读凭据、一个暂存环境、一个 deny 规则才是边界。Simon Willison 那条「致命三要素」是可以直接拿来当检查表的——私密数据 + 不可信内容 + 能对外说话,三者同时存在就是数据外泄风险。
五、自主权按动作发放#
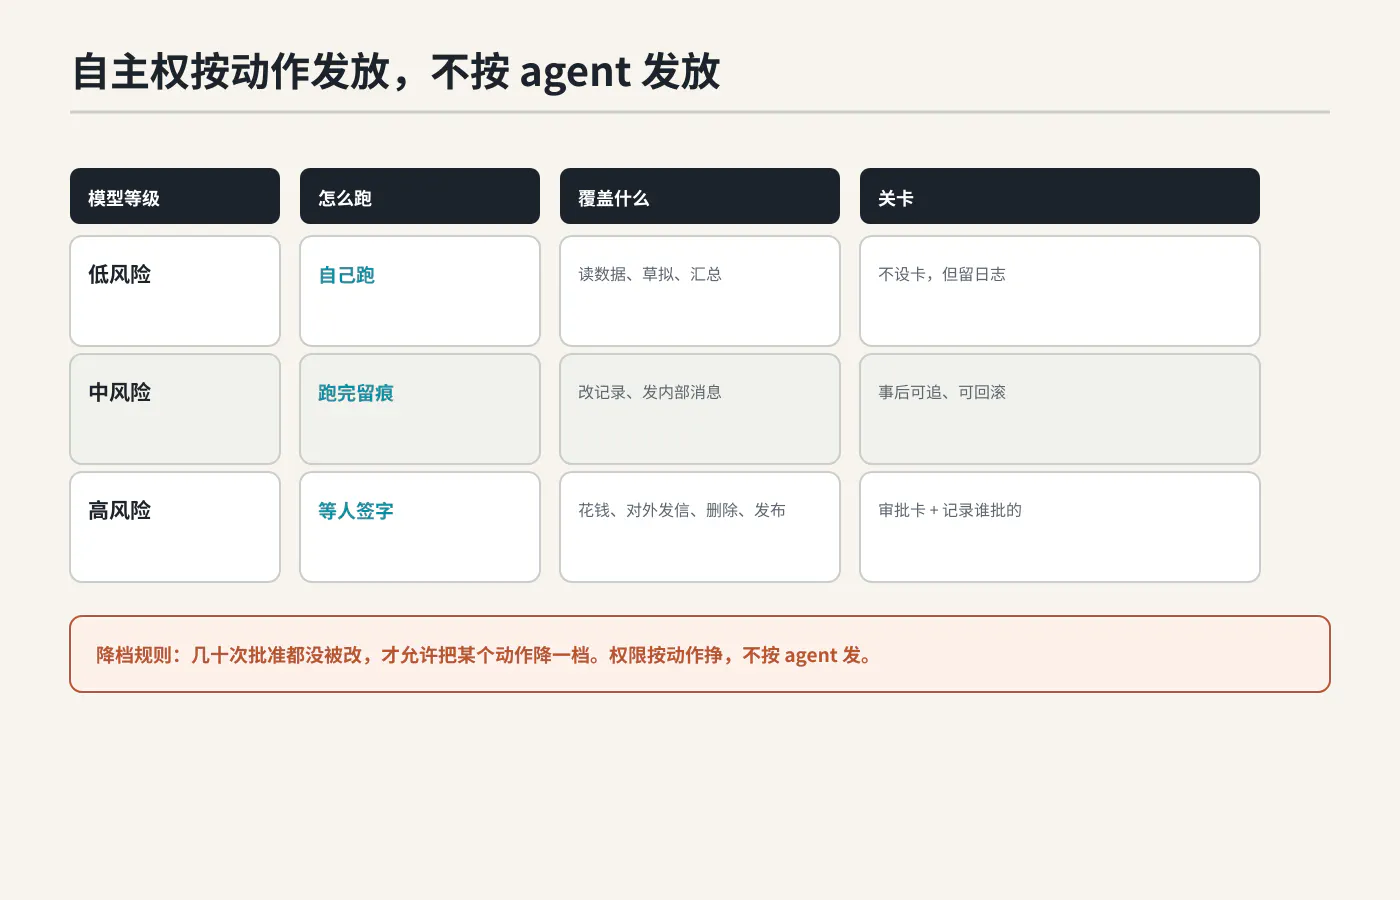
第七层的实现方式,原文给了三档:低风险自己跑、中风险跑完留痕、高风险等人签字。真正可操作的是那条降档规则:几十次批准都没被改过,才允许把某个动作降一档。
这句话把「自主权」从 agent 级的属性换成了动作级的属性。它解决了一个常见的两难:给 agent 更多自由会出事,不给自由又没价值。于是要问的问题变成:「这个动作值不值得放开」。
六、它的边界:这篇没谈的两件事#
按一篇指南的标准,它漏得不多,但有两块值得补:
- 成本与延迟。 全文只有一条数字(子代理约 15 倍 token)碰到了成本,而生产中真正决定能不能上线的往往是这两项。20 条评测集测试的是准确率,没测每次任务的美元成本和 p95 延迟。
- 可观测性。 第五层只提了一句「开 tracing」。但真跑起来,你要回答的是「这一周哪一层的失败率在上升」——这需要把七层的指标分开记,而不是只有一个总成功率。
另外,多 agent 的部分主要靠一个数字(+90.2%)和一句警告(早期版本给简单查询开了 50 个子代理),足以证明「先加满单 agent 能力」,但不足以支撑组织层面的设计。
七、八条自检#
- 你的评测集有多少条真实任务?有 20 条吗,含难看的那些?
- 每个模型版本是锁死的具体版本号,还是
latest之类的别名? - 系统提示词是从一份团队真在用的 SOP 改的,还是凭空写的?
- 每个工具都标了读/写吗?写操作有没有独立的、受限的凭据?
MEMORY.md这类记忆文件,agent 的写权限是否只限那一个文件?- 循环的退出条件写进指令了吗?代码里有
max_turns吗? - 有没有哪条工作流同时具备:私密数据 + 不可信输入 + 对外发送?
- 高风险动作清单有多长?每个都有审批卡、都记录了谁批的吗?
八条里如果有三条以上答不上来,问题通常不在模型。
八、开放问题#
- 20 条评测集在什么规模下会失效?当任务分布变成几十种时,「一次只换一层」的纪律还能守住吗,还是要引入分层评测?
- 降档规则要求「几十次无修改的批准」。但这个计数本身依赖审批记录的质量——如果批准只是习惯性点一下,这条规则会退化成「时间到了就放开」。
- 如果 agent 的表现主要取决于工具描述与上下文质量,那这套东西的可复用部分到底是「七层框架」,还是那几十份 SOP?
参考#
- 原文:https://x.com/undefinedki/status/2116154822583799887(How to Build a Production AI Agent: The 7 Layers Between the Model and the Result)
- Anthropic,Building effective agents / context engineering 相关文章,2025
- OpenAI,A practical guide to building agents,2026-01
- Simon Willison,lethal trifecta,2025-06
- Replit 生产库删除事故报道,2025-07