一句话:这篇长文里最值钱的不是那五个模块——模块会随部署形态变;最值钱的是一句判断:会话应该是系统的实现细节,不是用户的认知负担。下面把它拆开,再用它自己开源的
dsh-superagent-prototype对一遍账。
原文 2026 年 10 月 31 日发布,开头就写明:这是架构思路探讨,不是产品功能说明。同日团队把原型放上 GitHub,MIT 协议,README 里同样写着「研究代码,不等于内部版本」。所以有两种读法:先当论文读,再当 PRD 读——两种读法给出的结论不一样,差别本身才是有用的部分。
一、问题:多任务的上限,是人的注意力
作者的观察很克制,也很扎人:
单任务的上限取决于模型能力,多任务的上限取决于人的注意力。据我们观察,一个人通常只能同时跟进 3 到 5 个活跃 Session。
这句话没有附测量方法,但跑过三个 agent 并行的人大多会点头。原因不在人懒,而在现有 agent 把两件事焊死在了同一个对象上:
| Session 同时承担 | 后果 |
|---|---|
| 模型上下文的容器 | 为了「连续」不敢换会话,为了「干净」又必须换 |
| 用户的项目管理单位 | 于是「关掉会话」等于「丢掉项目」 |
于是有了三条结构性限制:单会话同步阻塞、多任务上下文互相污染、设备一休眠就停。加 CLI、加 MCP、加连接器都改不了这三条——它们不是接口问题,是会话被当成了系统的边界。
二、它提了什么:五个模块
原文主张四个特征——连续、高效、主动、持久——并且认为没有任何一个 ReAct Loop 能同时给出来。于是它们各自落到不同模块上:
| 特征 | 靠什么 | 掉了会怎样 |
|---|---|---|
| 连续 | 双层架构,所有信道汇到 Router | 你得自己记住哪个会话里有哪句话 |
| 高效 | 上下文隔离的并发 Worker | 一次只能推进一件事 |
| 主动 | Trigger + 两级过滤 + 投机执行 | 永远等指令,等于一个更贵的命令行 |
| 持久 | 存算分离 + 端侧 daemon + Watchdog | 电脑一合盖,活就停了 |
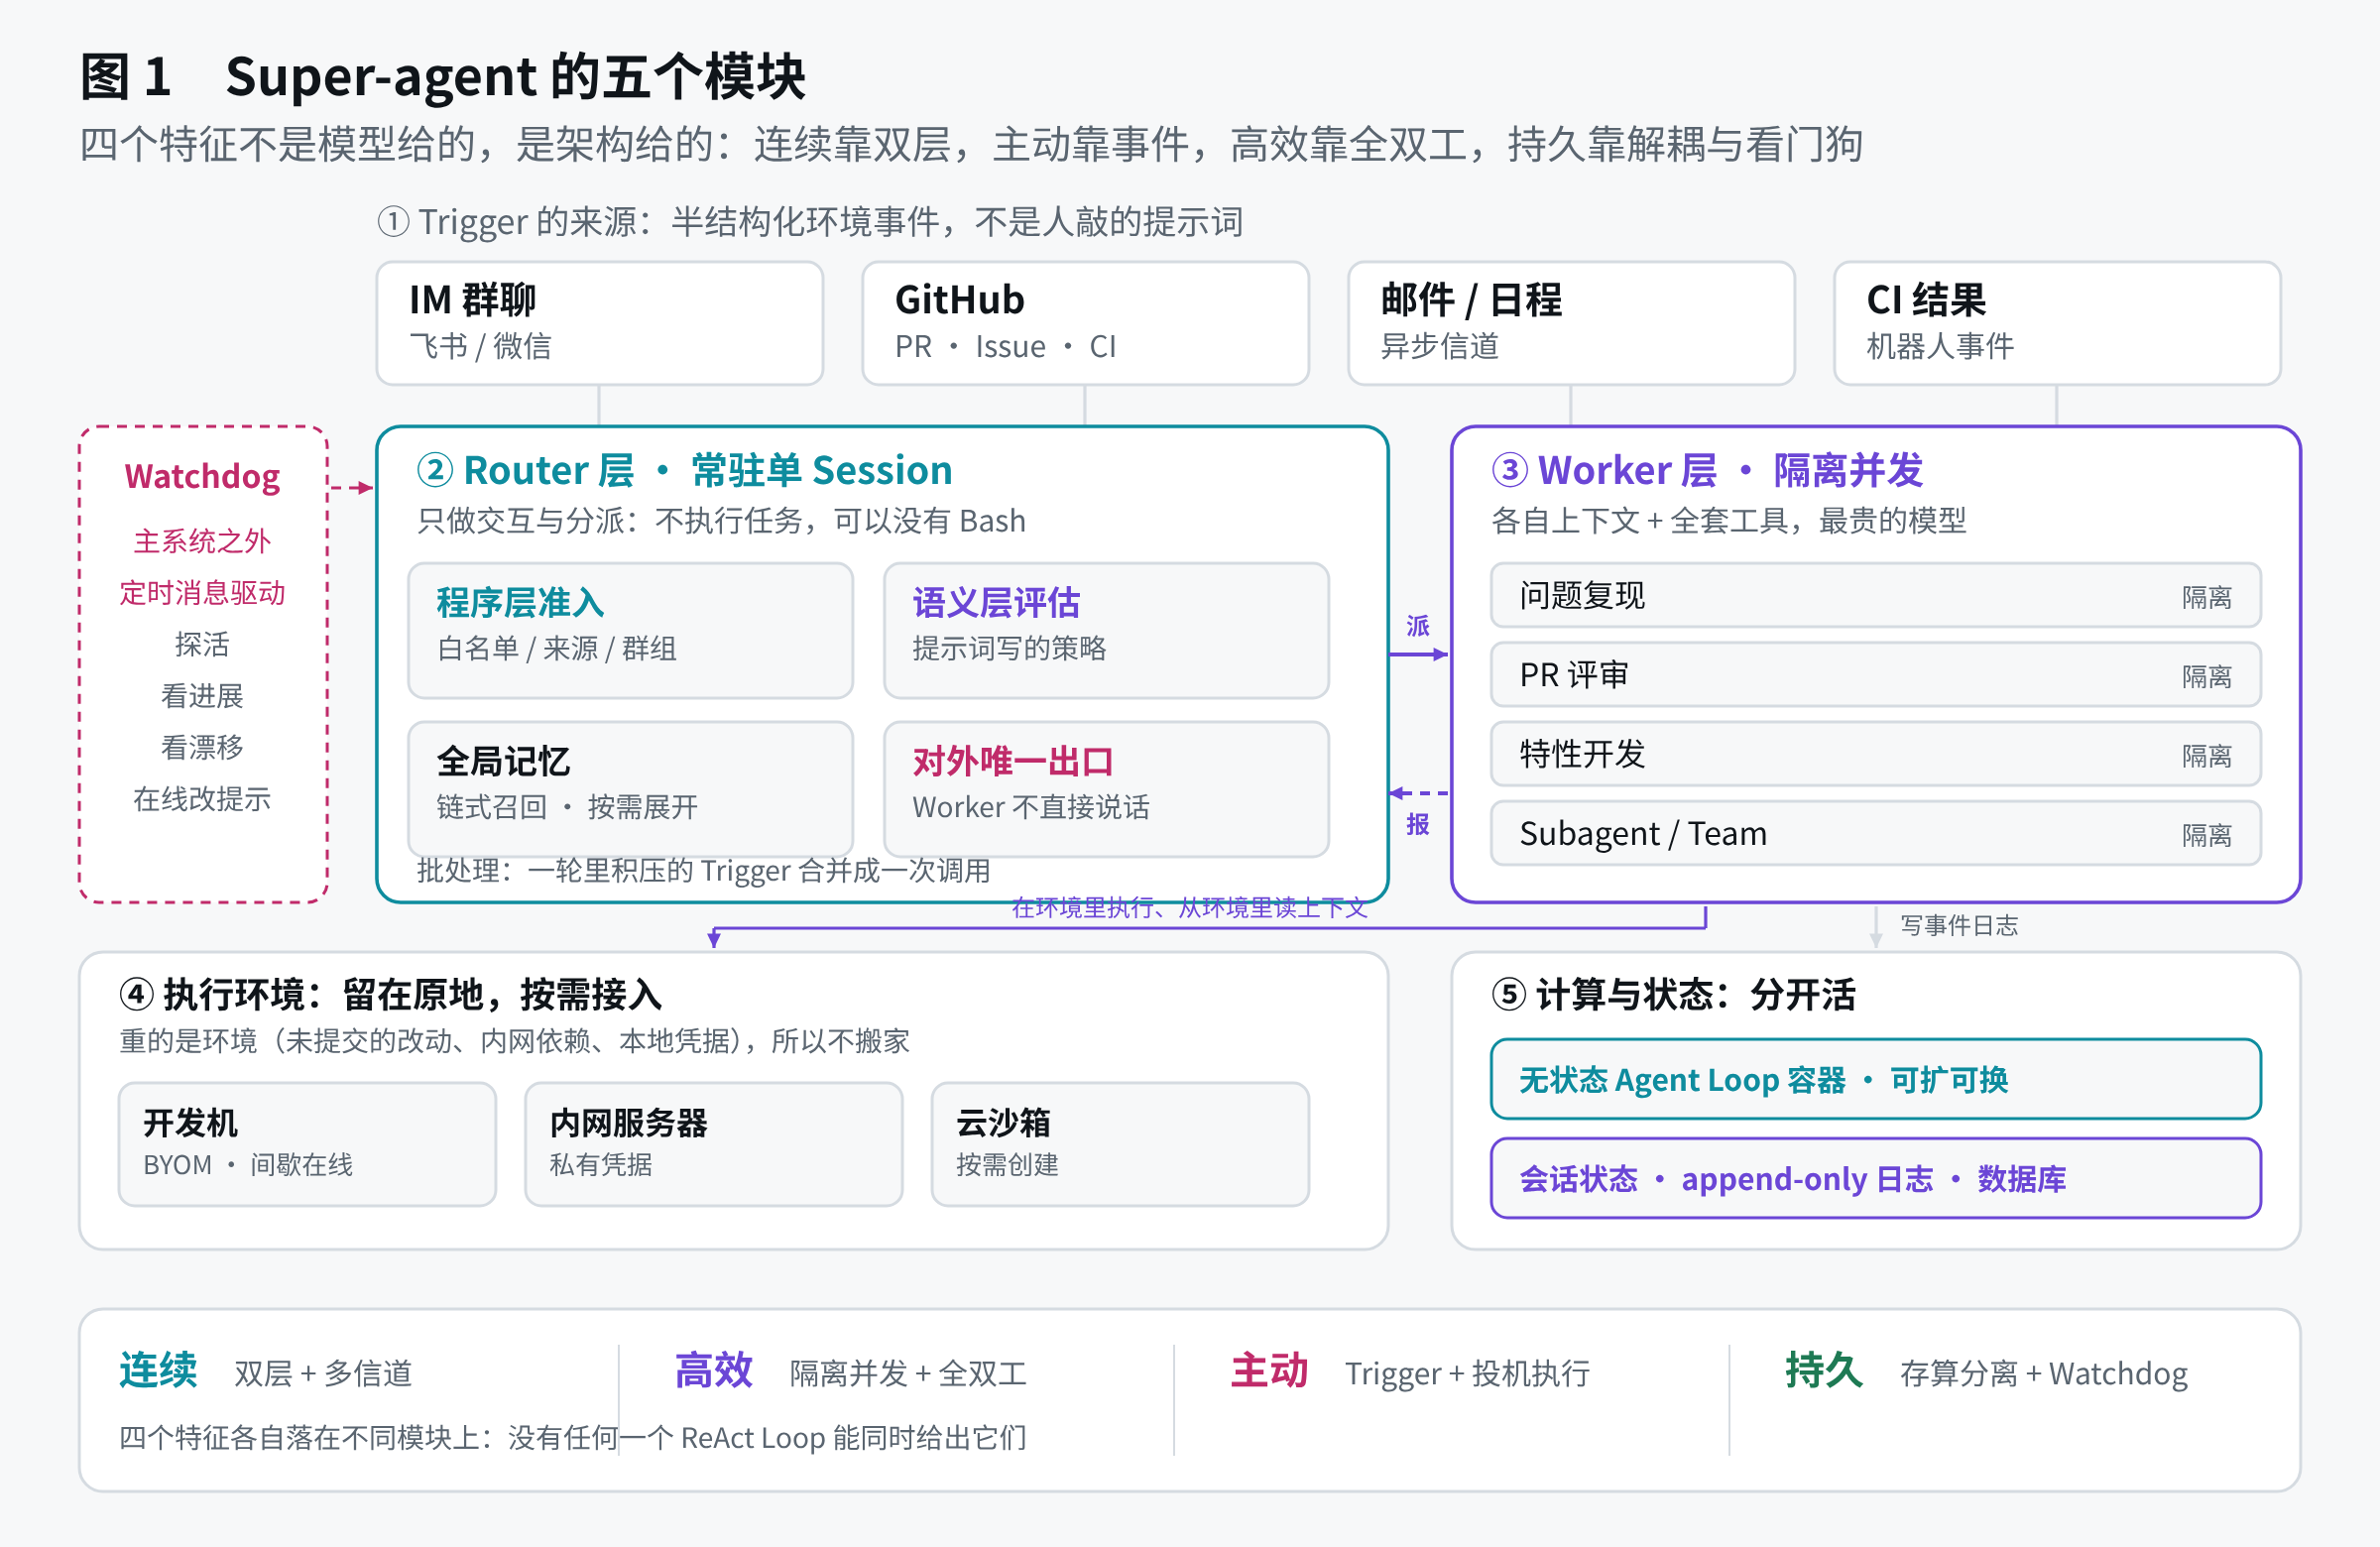
值得一提的诚实之处:这套设计没有提出新理论,作者自己也这么说。它做的是把计算机系统里一串经典手法——两级调度、快慢路径、把上下文窗口当 cache、投机执行、存算分离、外部看门狗——搬到 agent 系统上。所以读的时候该问的不是「新不新」,而是每个类比在哪里成立、在哪里失效。
三、双层:一个只分派的 Router
连续性与吞吐量是真实的权衡。所有事件进一个会话,上下文最连续,但 ReAct Loop 一步一次,吞吐塌掉,而且两件事的中间细节互相污染;每个事件新开会话,吞吐最大,但相关任务失去共享上下文,几个会话还会一起对着用户说话。原文的解法不是打败这个权衡,而是把它拆到两层去承担。
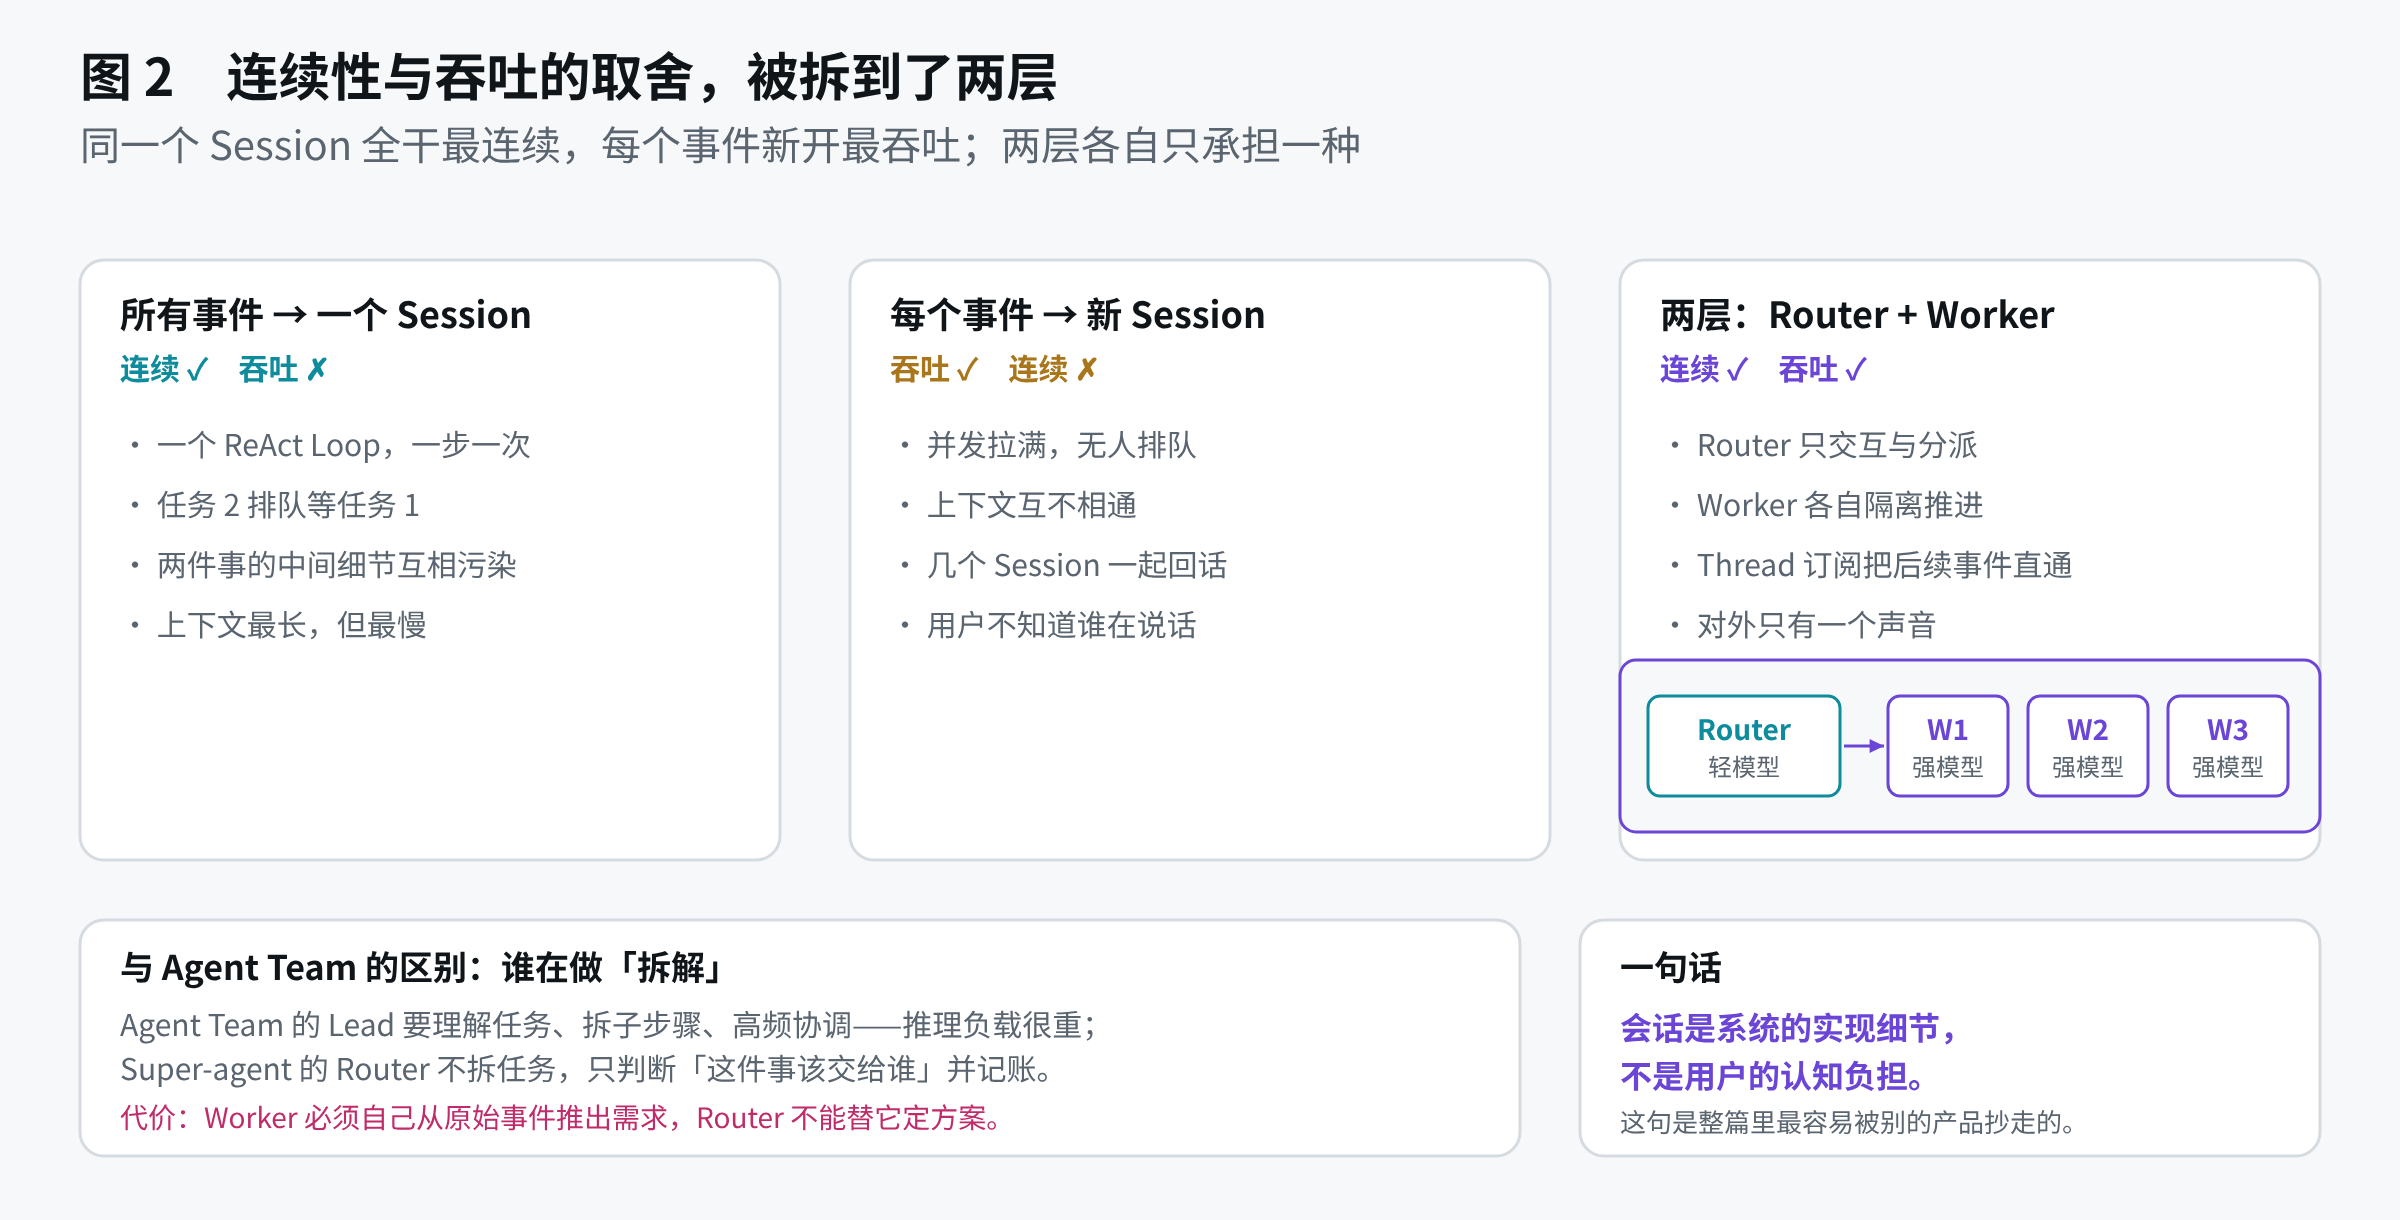
Router 层的三条硬约束:
- **不执行任务。**只做人类交互与分派,「甚至可以不配备 Bash 工具」。
- **充当全局序点、协调点与记忆。**所有跨任务的信息在这里汇总。
- **可以更轻。**原文的判断是「Router 层的任务常常没有想象中复杂,使用较轻量的模型往往就能兼顾速度与效果」。
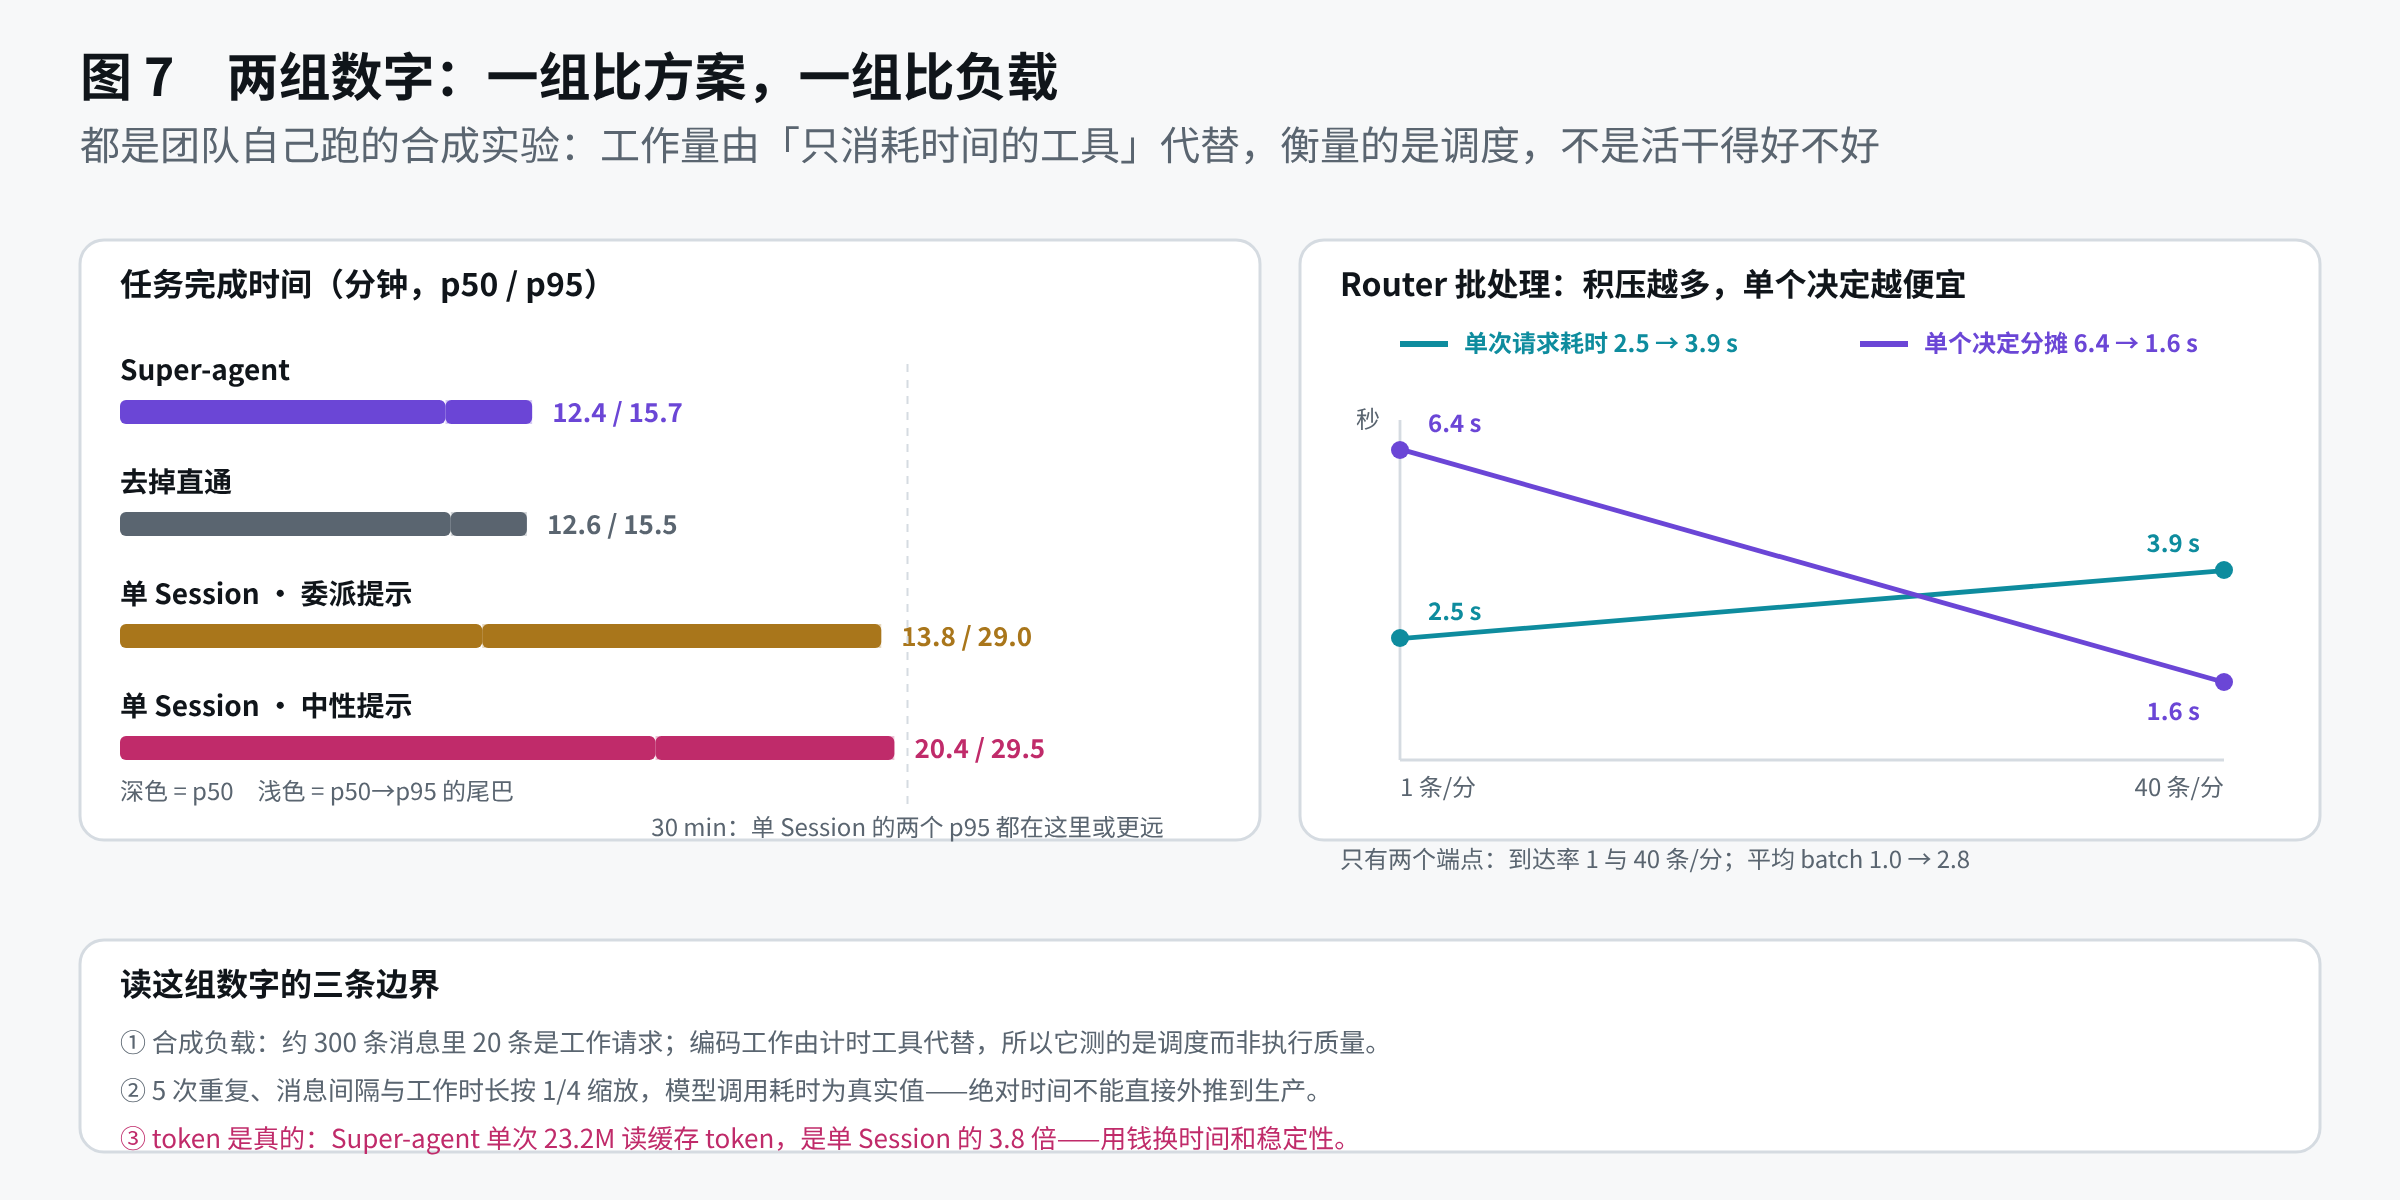
第 3 条有个反直觉的支撑:批处理。上一轮推理期间积压的 Trigger 会在下一轮合并成一次调用;长输入、短输出,合并进来的 Trigger 在 Prefill 阶段并行算,于是在一定范围内,积压越多,单个决定分摊的推理时间越低。第七节有测量。
和 Agent Team 的区别值得单独一张表,因为这两者经常被混为一谈:
| Agent Team | Super-agent 的两层 | |
|---|---|---|
| 谁拆任务 | Lead 拆子步骤、高频协调 | Router 不拆,只判断「归谁」;Worker 从原始事件自己推需求 |
| 推理负载在哪 | 很重,压在 Lead 身上 | Router 很轻,重负载在 Worker |
| 失败模式 | Lead 理解错,全员跑偏 | Worker 各自跑偏,Router 只看得到「有没有进展」 |
| 能不能从 Team 改造 | —— | 可以:禁止主会话执行任务,只留交互与分派 |
最后一行最实用:双层架构 = 一个不干活的主会话 + 一条提示词约束。不换框架就能试。
代价写在原型的提示词里。因为 Router 不许替 Worker 定方案,prompts/dispatch.md 几乎是一堵禁令墙:
Do not expand a request’s scope, add implementation plans, acceptance criteria or policy checklists… Do not paraphrase a short request into a work plan, pick examples or categories, invent requirements…
它甚至带了例子:「能不能加个深色模式?」必须原样带着来源引用转过去,不许顺手附赠一套配色方案。这种啰嗦本身就是收据:轻不是免费的,它靠把「不许变聪明」写成规矩来买。
四、事件驱动:一条 Trigger 的一生
输入不再是人敲的提示词,而是半结构化事件:群消息、PR 评论、CI 结果。原文把一条事件的旅程拆成四段递进的工程。
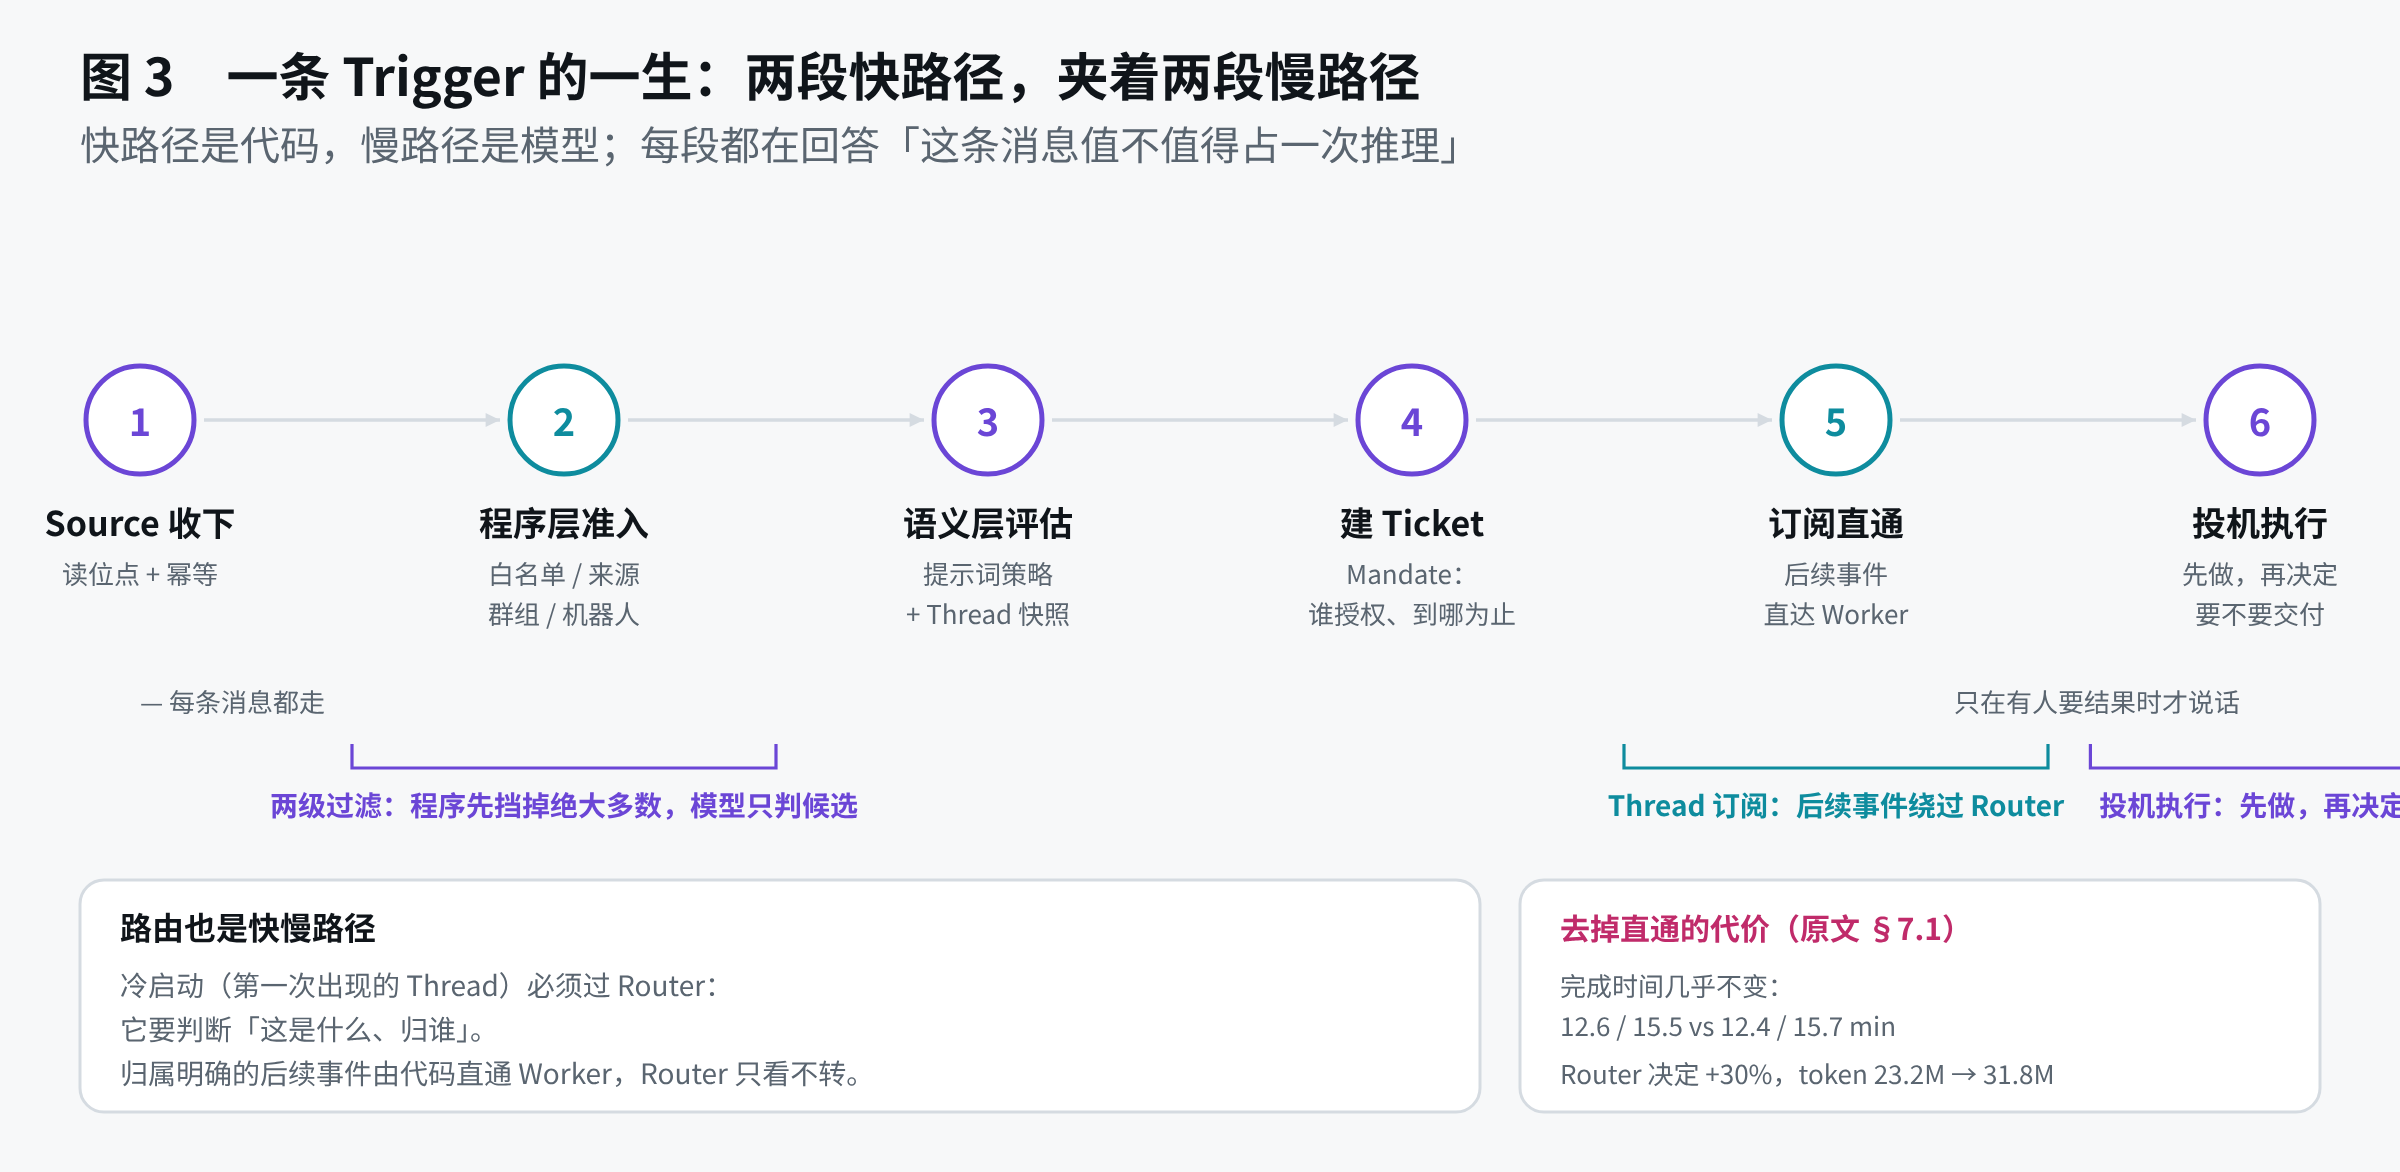
**过滤。**程序层先按确定性条件挡掉大部分流量(来源、群组、白名单),活下来的交给语义层,由模型按「用提示词写的策略」判断。原型把两层真正分开了:src/admission.ts 是一张准入矩阵(名单内外 × 有没有 @,三种组合——名单内且被 @ 永远算显式请求),默认值极保守;语义那半在 src/app/assessment.ts 里。
**路由。**同一个 PR、同一个 IM 话题、同一封邮件串下的连续事件构成一条 Thread。Router 只处理冷启动:它为 Thread 的第一条事件建 Worker 并订阅;之后由代码直通,Router 看得见但不转发。订阅是多对多的,所以两个撞在同一个 PR 上的 Worker 会收到同一批通知,不需要点对点通信。
直通买的不是速度,是 Router 的账:去掉直通后完成时间几乎不变(12.6 / 15.5 分钟 vs 12.4 / 15.7),但 Router 的决定多了约 30%,读缓存 token 从 2323 万涨到 3177 万。
**上下文。**窗口当 cache 管:近期要用的内联,其余 spill 到窗口外只留指针与摘要,需要时沿引用图一跳一跳召回。
落到代码很朴素但真实:src/app/cards.ts 的 preview() 把正文压到 160 字,卡片只带 id 与 read: ticket/<id>;inputLine() 里 80 字以内直接内联,超了就只剩指针。阈值是拍的,方向是对的。缺的是「多跳」——relatedTickets 只跳一跳,原文那张引用图还没有对应实现。
投机执行。不等结果确定就先做:有人反馈问题,先在后台复现、找便宜修法,确认了再开口。原型在这件事上做了个很聪明的产品决策——主动行为先只记录、不执行,让你先读它的意图,再放开权限。
五、面向人的交互:全双工与多信道
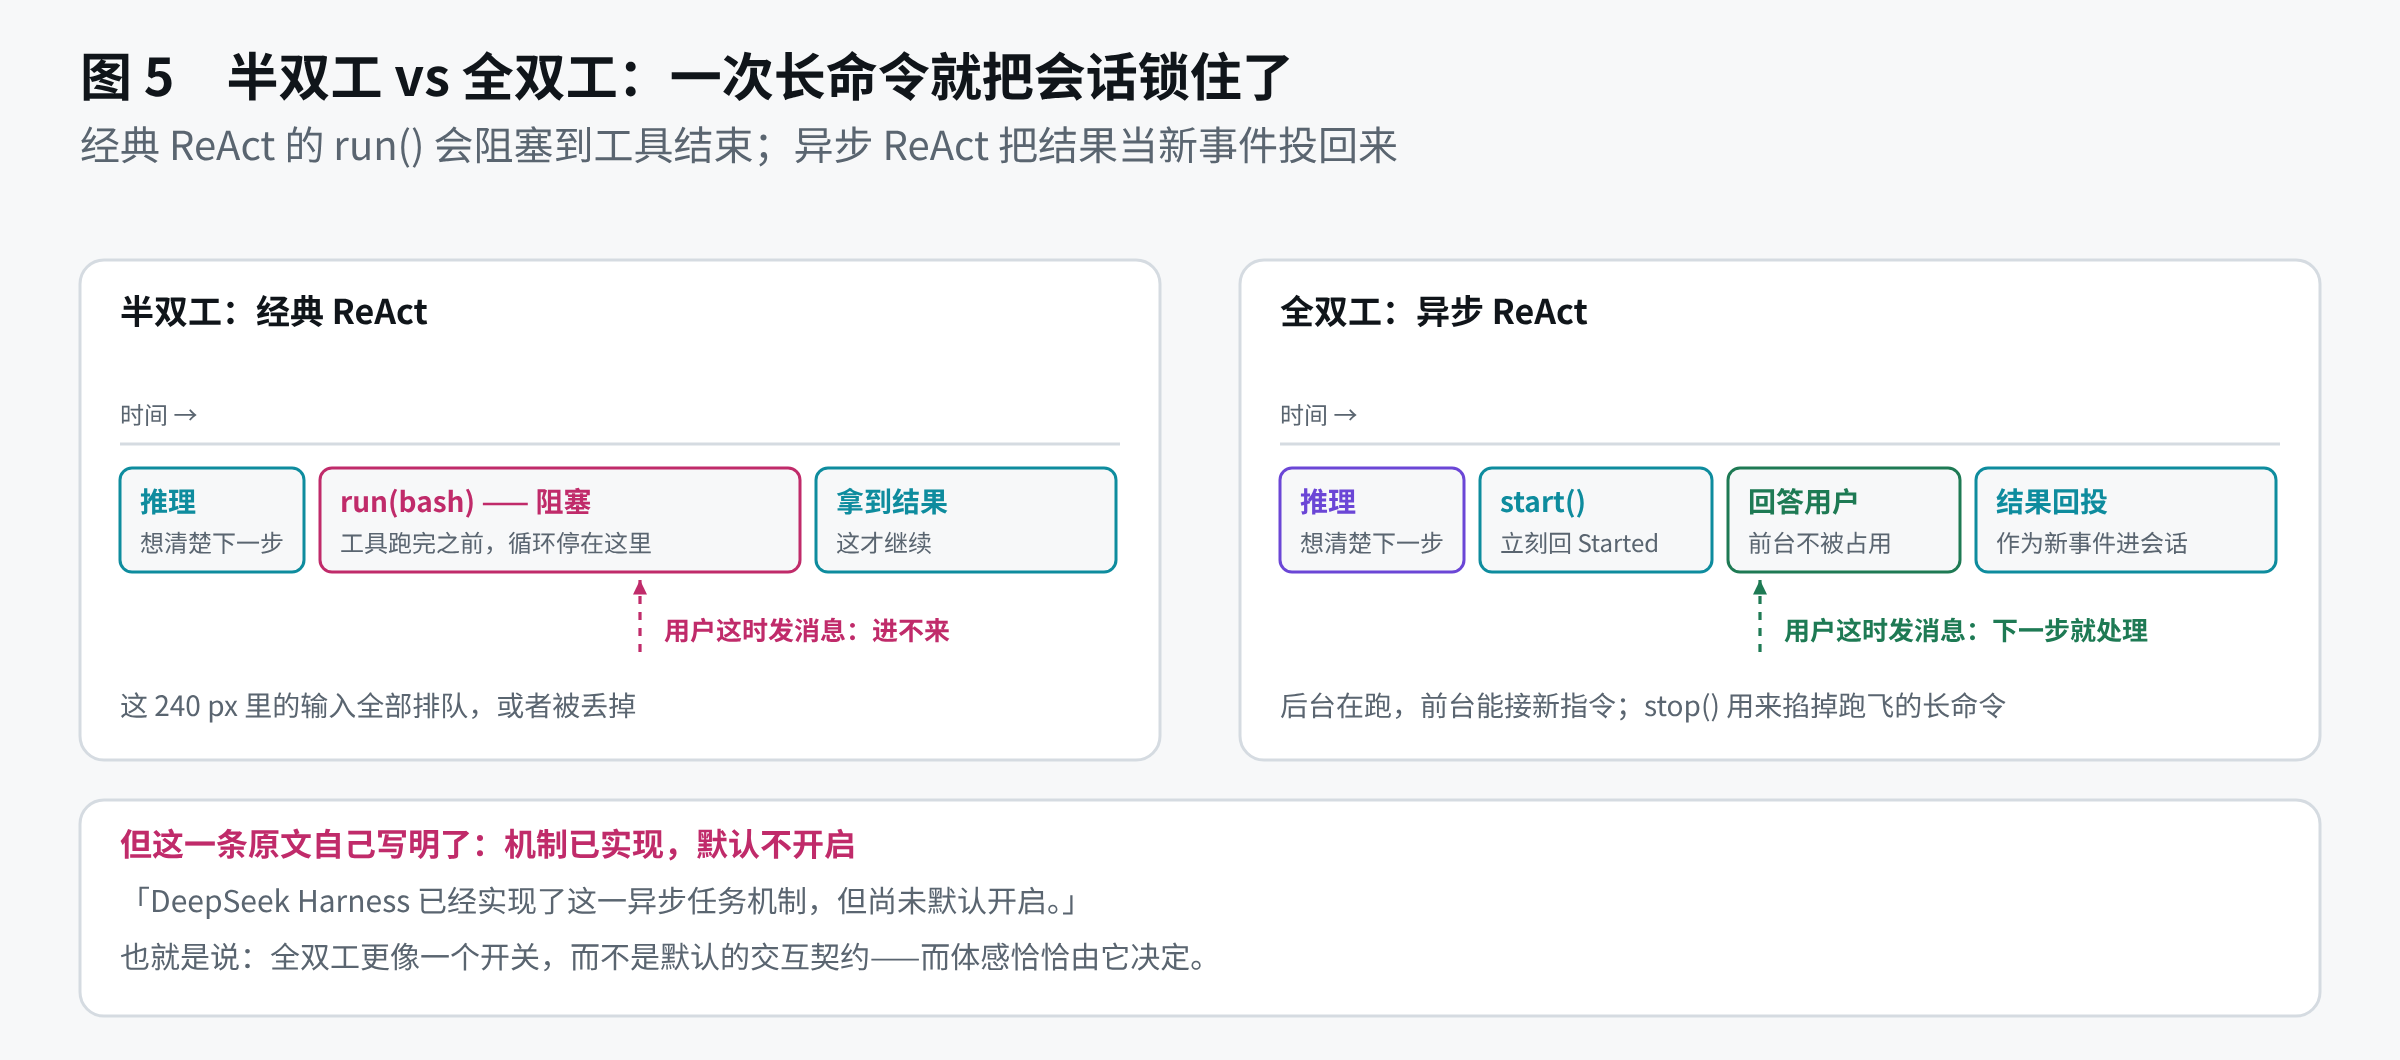
经典 ReAct 的 run() 是同步的:工具不返回,这一轮什么都听不见。改成异步之后,start() 立刻回 Started,结果稍后作为新事件投回会话,前台始终可用。
然后原文写了这么一句,值得原样抄下来:
这一异步任务机制已经在 DeepSeek Harness 中实现,但尚未默认开启。
所以全双工是一个开关,不是默认的交互契约——而整套系统的体感恰恰由这个开关决定。
多信道那半段更可直接抄。两条规则:
- 即时通讯:像人同事一样,只在需要决策或验收时通知,只问直接问题,给简短结论。硬性规定单次回复不超过 100 词。
- 异步信道(GitHub、邮件、文档):结构化、高信息密度——完整的问题背景、改了什么、怎么验证的。
100 词在原型里不是风格建议,是传输层强制的:prompts/replies.md 写着「100 words is a hard ceiling, not a writing target」,超长的 IM 消息会被传输层拒收,哪怕对方明确要了技术细节。能被系统执行的约束,胜过一句「请简洁」。
六、持久:脑在云上,手在原地
本地 agent 把三样东西焊在一台机器上:跑循环的算力、要活下来的状态、以及代码仓库与工具链这些执行环境。合盖就全停。
原文分两步拆。第一步:算力做成无状态容器,会话状态进数据库,Agent 不再共享一台机器的生命周期。第二步:云端循环与重状态的执行环境分开,端侧只跑一个不保存会话状态的 daemon,只执行命令、返回结果。
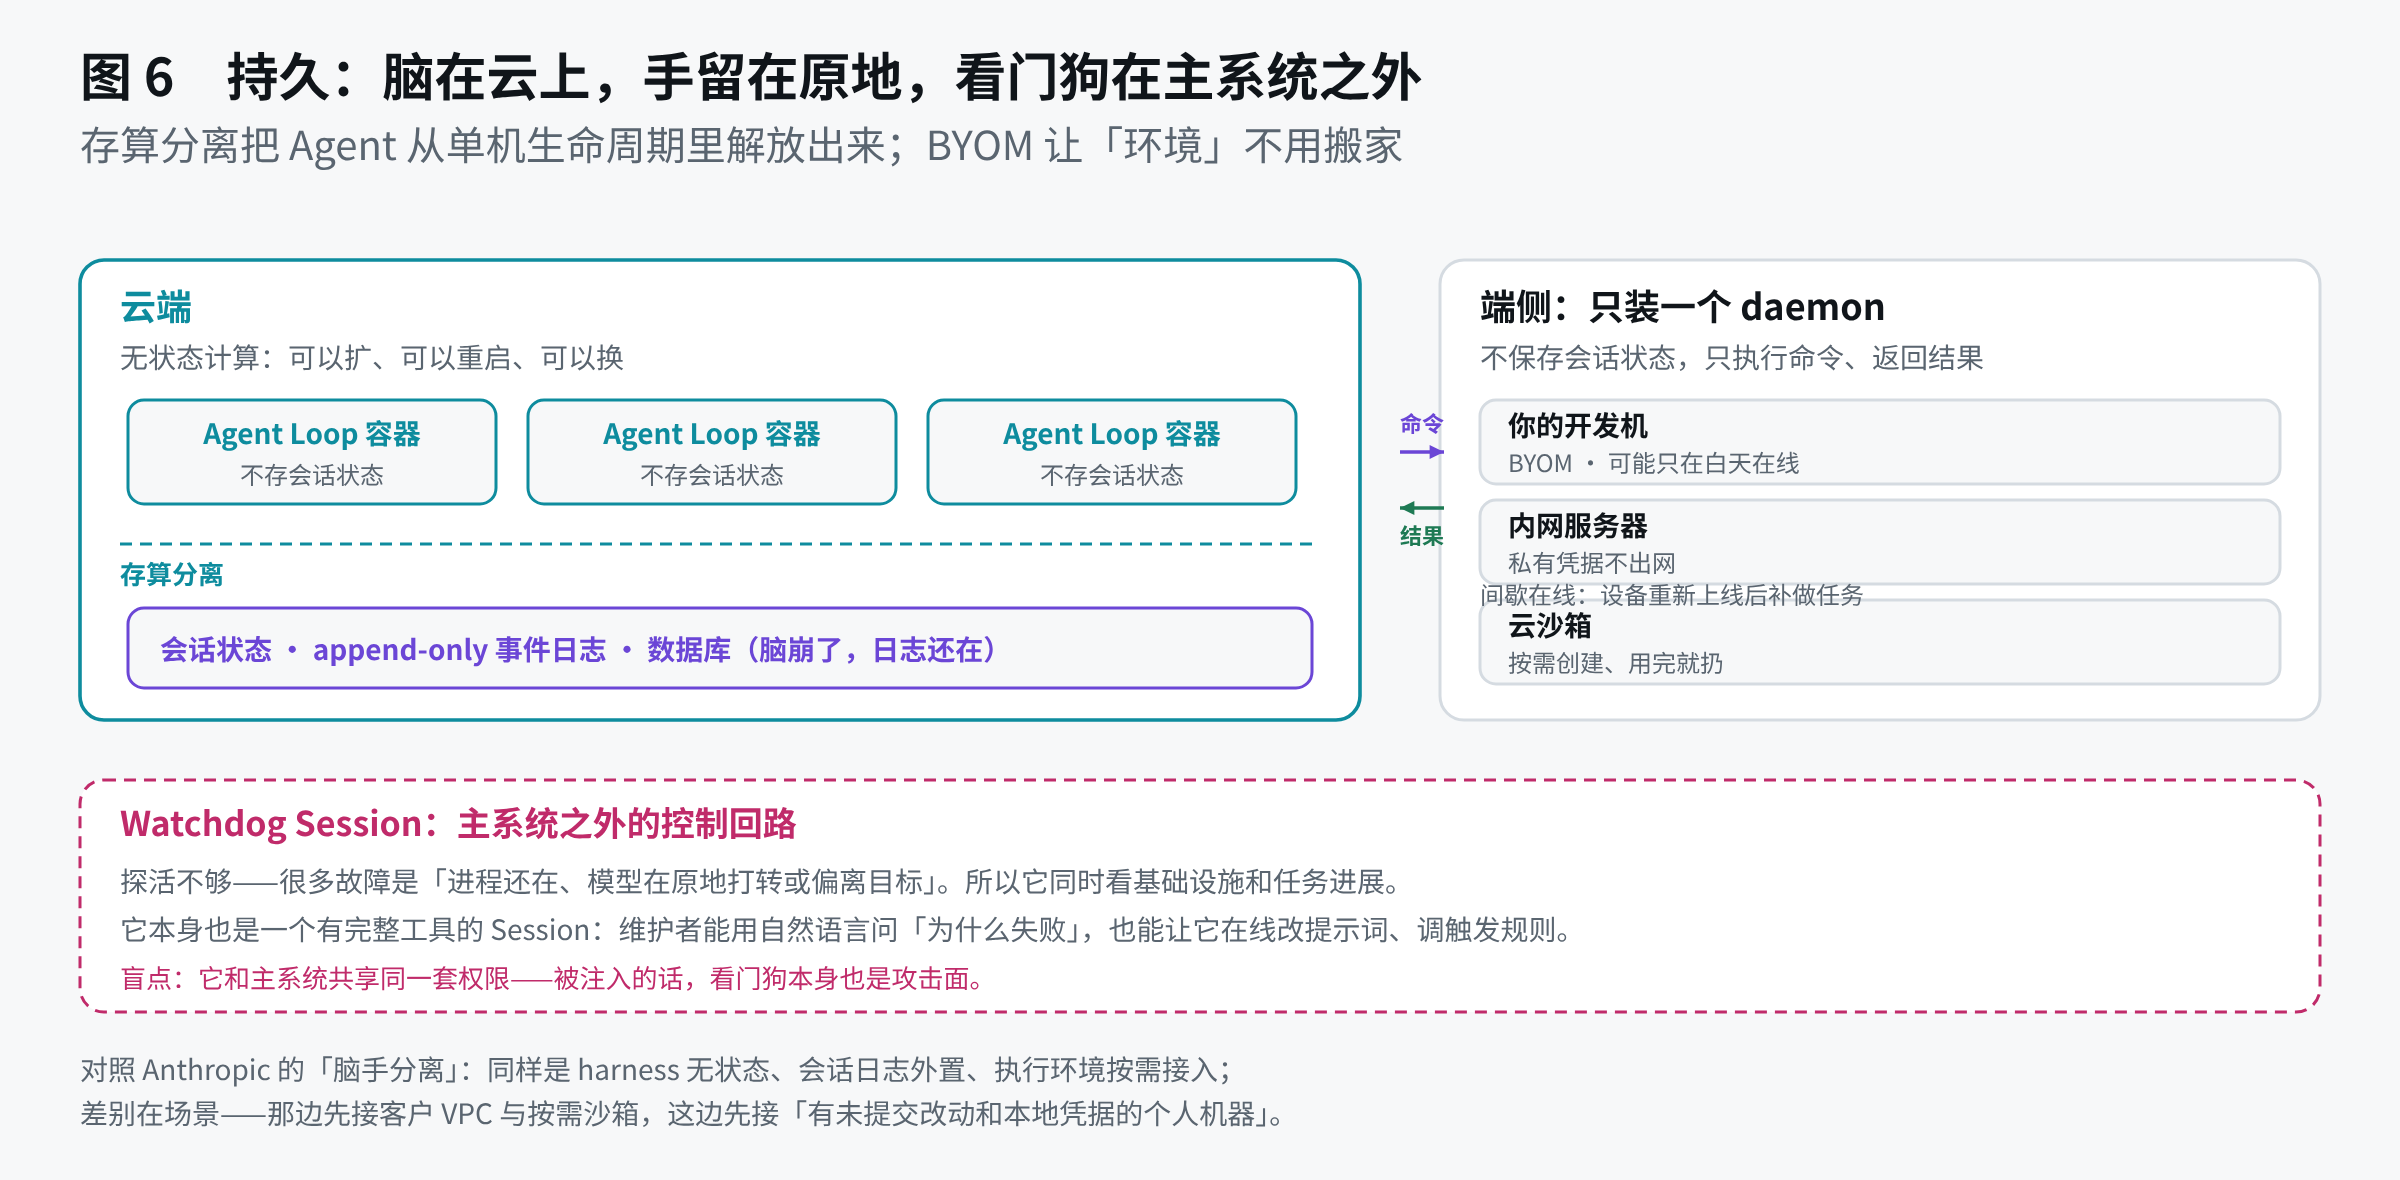
这就是 Anthropic 的「脑手分离」,只是起点不同:
| Anthropic Managed Agents | DeepSeek Super-agent | |
|---|---|---|
| 先接什么 | 按需沙箱、客户 VPC | 开发者自己的机器,含未提交的改动 |
| 在线假设 | 云与沙箱常在 | 端侧可能间歇在线,重连后补做任务 |
| 安全做法 | 凭据永不进沙箱:git token 在初始化时接进 remote,MCP 走 vault + proxy | 列为开放问题(§8.4) |
| 公布的收益 | TTFT p50 −60%、p95 −90%+(厂商公布) | 未给解耦的量化收益 |
最后一行是非对称的地方:一边给延迟数字,一边给设计图。延迟数字才让「解耦」超出洁癖的范畴——它落在用户最能感觉到的那一段。
Watchdog 是「持久」的另一半:它不是探活脚本,而是主系统之外、由定时消息驱动、带完整工具的 Session。它修基础设施故障,也问模型「这个 Worker 是在实质推进,还是在原地打转」。维护者可以用自然语言问它为什么失败,也能让它在线改提示词、调触发规则。用 agent 监督 agent 在正常路径上很优雅;另一条路径见第九节。
七、数字(分清来源)
两组实验,都是合成负载:每次约 300 条消息、其中约 20 条是工作请求,编码工作由「只消耗时间的工具」代替,每种方案跑 5 次。
| 指标 | 值 | 来源 |
|---|---|---|
| Super-agent 完成时间 p50 / p95 | 12.4 / 15.7 分钟 | 原文消融实验,合成负载,5 次 |
| 去掉直通 | 12.6 / 15.5 分钟 | 同上 |
| 单 Session + Subagent,中性提示 | 20.4 / 29.5 分钟 | 同上 |
| 单 Session + Subagent,优先委派提示 | 13.8 / 29.0 分钟 | 同上 |
| 单次实验读缓存 token | 2323 万 / 3177 万 / 610 万 / 1080 万 | 同上,顺序同上 |
| 批处理:Trigger 1 → 40 条/分 | batch 1.0 → 2.8;单请求 2.5 → 3.9 秒;单决定 6.4 → 1.6 秒 | 同上 |
| DSH 间接提示注入成功率 | 17.0% 文本、25.5% 文件(隐藏 Unicode)、16.0% skills 信道 | A.I.G,14,560 次运行,arXiv:2608.16393 |
| 脑手分离后的 TTFT | p50 −60%,p95 −90%+ | 厂商公布,未独立复测 |
三件事必须一起读:
- **它测的是调度,不是执行。**计时工具代替编码,所以「12.4 分钟」里没有一行真代码。这些数字支持「两层比单会话稳」,不支持「活干得更好」。
- **单 Session 那一行是提示词问题,不是模型问题。**中性提示下 5 次一次都没委派,p95 冲到 29.5 分钟;换成优先委派后 4 次委派,剩下 1 次它判断「这活很小」自己干了,于是图上留了条长尾。把「要不要分工」交给提示词工程和模型临场判断,正是双层架构在系统层面消掉的那种脆弱。
- **token 是真金白银。**2323 万 vs 610 万,3.8 倍。原文写得很直白:以更多 token 换更短、更稳定的完成时间。
八、开源原型:哪些真的跑起来了
原型是 DeepSeek Harness 的一个插件包,MIT,单仓库,GitHub 与飞书两个来源,状态落在本地 stateDir。把文章概念和代码并排一看,边界立刻清楚:
| 文章里的东西 | 原型里对应什么 | 状态 |
|---|---|---|
| Router 层 | 主会话(prompts/orchestrator.md),src/core/engine.ts 是唯一事务入口 | 已实现(本机单会话) |
| Trigger / Thread | src/core/model.ts、src/core/intake.ts | 已实现 |
| 两级过滤 | src/admission.ts 准入 + src/app/assessment.ts 语义 | 已实现 |
| Thread 订阅(多对多) | Thread 持有 Subscriptions,src/core/tickets.ts | 已实现 |
| Inline & Spill | preview() 160 字、inputLine() 80 字后只剩指针 | 已实现(单层,非通用机制) |
| 链式召回 | relatedTickets / referenced_tickets | 部分(只跳一跳) |
| 投机执行 | 主动行为只记录、不执行 | 部分(策略侧,无预算控制) |
| 异步 ReAct | src/executor/background.ts,借 DSH 的 jobs 与 subagents | 已实现(依赖宿主) |
| 存算分离 / BYOM daemon | 无:本地 SQLite,本地会话 | 空白 |
| Watchdog | 没有看门狗 Session;只有组件健康与重试状态 | 空白 |
| Router 水平切分 | 无 | 空白(原文也列为开放问题) |
这张表一句话总结:**原型把「路由与授权」做完了,把「持久与自愈」留在了纸上。**而这两块恰好最难——一个动部署,一个动运维。
两个细节比模块图更能说明工程现实。第一,领域模型比文章啰嗦得多:docs/001-domain.md 有 11 个概念,还有一张「被拒绝的概念」表——「一个 Thread 最多只有一个 Ticket」被明确拒绝,理由是「一条 Thread 可以承载几件互不相关的活」。第二,授权和上下文被拆开了:Trigger 到了工单那里只算 context,不给权限;真正授权的是工单上那份不可变的 Mandate(谁授权、按哪一版 Policy、能走多远)。原文没强调这点,但它是「主动」能安全落地的前提。
九、它不成立的地方
安全不是开放问题,是前置条件。§8.4 承认设计假设云端与端侧互信,一旦循环被攻破,「其连接的全部端侧设备都面临被控制的潜在风险」。这不是理论担忧:腾讯 A.I.G 在 14,560 次受控运行里测出间接注入成功率——文本载体 17.0%(语义判定)、文件载体隐藏 Unicode 25.5%(规则判定)、skills 信道 16.0%。在「云端循环 + 端侧持凭据」的结构里,这个数量级的成功率意味着一次注入≈拿到一批设备。Anthropic 的结构性答案(凭据永不进沙箱)值得直接抄;DeepSeek 这边只把问题写下来了。
**看门狗本身是攻击面。**它共享主系统权限,还能在线改提示词、调触发规则。用 agent 监督 agent 在正常路径上很优雅,在对抗路径上是两个提权点;原文没有讨论。
长程记忆才是真正的天花板。§8.1 说得很清楚:常驻 Router 加持引用图的召回解决的是近期任务与会话历史;跑到跨月,记忆就是主瓶颈。检索和记忆是两件事——找得到,不等于记得住、知道该忘什么。
**「3 到 5 个会话」没有方法。**它是全部动机的起点,但没有样本、没有测量。它可能是对的,但作为论证地基,它是自证。
**合成负载有天花板。**计时工具、1/4 缩放、5 次重复。足以支撑「调度有效」,不足以支撑任何绝对时间;原文自己也这么说。
**复杂度会转移,不会消失。**设计把会话管理从用户手里收走了,很好;但系统自身的复杂度总得落在某处,DSH 自己的口碑说明它落在了运维身上。再加一层,用户就失去了「知道 agent 在干什么」的把手——§8.2 承认「如何向用户呈现任务」还没答案。可追溯的 Mandate 和可审计的 Decision 记录,可能比再画一层架构图更重要。
**还有一条方法论上的提醒。**这里只优化「注意力」一个指标。对并行工作它是对的,但它会系统性低估另一个需求:理解发生了什么、为什么、能不能复现。省注意力与可解释性经常互相拉扯,而这篇长文只算了一边的账。
参考
- DeepSeek Harness 团队《Super-agent 设计探索:迈向更自主的 Agent 系统》,2026-10-31——本文所有引文与数字均出自该文。
- deepseek-ai/dsh-superagent-prototype(MIT)——第八节的代码锚点:
src/admission.ts、src/core/engine.ts、src/core/model.ts、src/app/cards.ts、src/executor/background.ts、prompts/dispatch.md、prompts/replies.md、docs/000-philosophy.md、docs/001-domain.md。 - Anthropic《Scaling Managed Agents: Decoupling the brain from the hands》——session / harness / sandbox 三个接口,以及 TTFT 收益。
- 腾讯朱雀实验室 A.I.G《Evaluating DeepSeek Harness with A.I.G: A Security Assessment of Indirect Prompt Injection》,arXiv:2608.16393——16 条间接内容信道、14,560 次运行。
- deepseek-ai/deepseek-harness(MIT,「一切皆插件」)。
- 口碑,不是证据:DSH 讨论区 #11714、Elliot Hu《DeepSeek Harness:好的框架,坏的产品》。