字节搬走了,计算没跟过去:去中心化数据库的十年与四层账单
去中心化数据库十年没解决的不是共识强度,是计算没有跟着字节走。六条路线、四层架构、一本把账算清楚的论文:2.85 倍加速、15.8% 并行效率,以及为什么「再发布一个去中心化数据库」从来不是答案。
一句话 这条赛道十年没解决的核心问题不是共识不够强,是计算没有跟着字节走。数据库不是一个东西,是四件事——写入顺序、字节位置、执行位置、读权限;六条路线,每家只买走了其中一层。
一、问题:一个停更四年的项目,还在被当作基线#
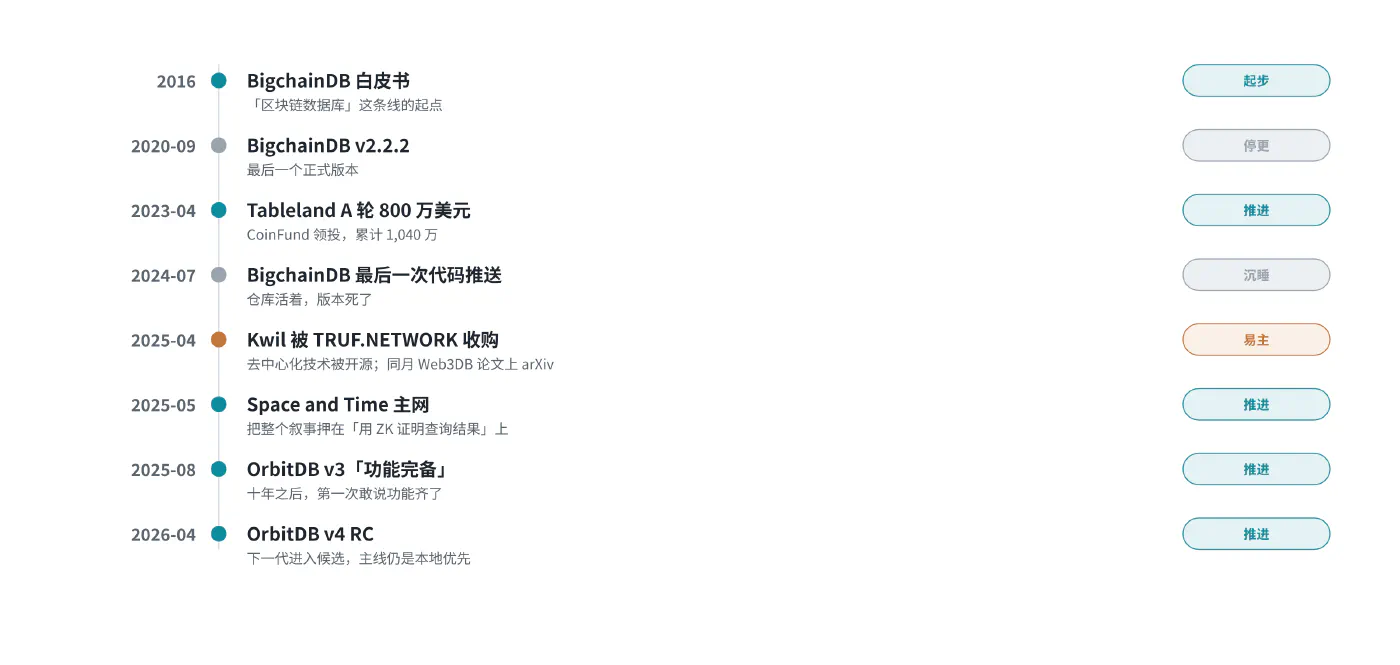
2016 年,「区块链数据库」是热词。BigchainDB 给的答案很直接:MongoDB 负责存,Tendermint 负责排顺序,每个节点都是整条链的副本,写入即定稿。它拿到 4,030 个 star,被写进无数篇综述和对比表。
GitHub API 上的事实是:最后一次代码推送 2024-07-04,最后一个正式版本 v2.2.2 停在 2020 年 9 月,后续工作交给了 IPDB 的 Planetmint。今天它仍然是审稿人最熟悉的「去中心化数据库」样本。
这不是孤例。Kwil 在 2025 年 4 月把去中心化技术卖给了 TRUF.NETWORK 并开源;Tableland 在 2023 年 4 月拿到 CoinFund 领投的 800 万美元 A 轮,累计融资 1,040 万;Space and Time 2025 年 5 月上主网,把整个叙事押在「用 ZK 证明查询结果正确」上;OrbitDB 做了十年,2025 年宣布 v3 功能完备,2026 年 4 月放出 v4 RC。
这条赛道的死亡名单和产品名单差不多长。它们死在同一个地方:每一家只把四层里的某一层去中心化了,然后宣称自己把整台数据库去中心化了。
二、四层账单:每条路线实际买走了哪一层#
数据库从来不是一个东西,是四件事:写入顺序、字节位置、执行位置、读权限。把四件事拆开,赛道上的所有分歧都变成同一道选择题——你打算为哪一层付去中心化的钱。
| 路线 · 代表 | 主张 | 买走的层 | 后果 |
|---|---|---|---|
| BigchainDB | 数据库即链 | 写入顺序 | 2020 停更 |
| OrbitDB、GunDB | 本地优先 | 副本同步 | 无 SQL |
| Tableland | SQLite 上链轨 | 命名权限 | 单写入者 |
| Space and Time | 证明结果 | 可验证性 | 证明成本 |
| IPFS、Arweave | 内容寻址 | 字节位置 | 无下推 |
| Web3DB | SQL + 链上 ACL | 权限与主节点 | 20 节点崩 |
六行里没有一行是错的:账本数据库把写入顺序搬上链,P2P 把副本同步做成协议,Tableland 把表名和权限放到链上,Space and Time 把「结果对不对」做成证明,IPFS 只负责字节在哪,Web3DB 把权限和主节点选举一起搬。但没有一行能单独成立。
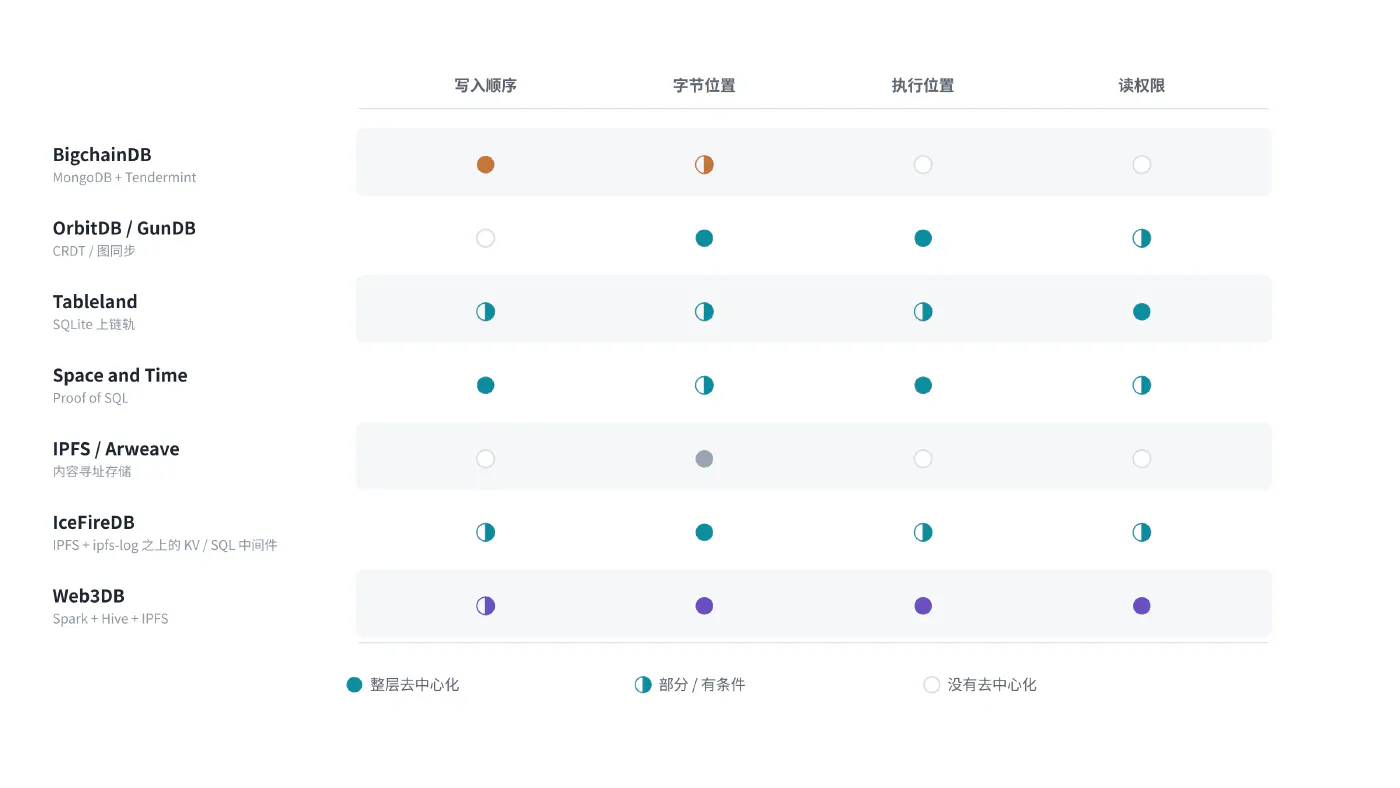
放回整张图里看,技术栈的出身基本决定了天花板:从 IPFS 生态长出来的,先解决「字节在哪」和「谁先谁后」,复杂查询只能往后放;从区块链生态长出来的手上是账本,先解决排序;从 Postgres 生态长出来的(Kwil)是拿 SQL 去换共识;从学术项目长出来的拿到的是 Spark 加 Hive。四层里没有人是一起设计的——每一家的边界,都写在它起步的那一层里。
三、一个把四层都写下来的样本#
2025 年 4 月,Notre Dame 和 Georgia 的一个团队把一篇系统论文放到 arXiv(随后进了 IEEE GBC)。它做了一件这条赛道上少见的事:四层全部写下来,并且把账算清楚。
读它的时候,我不太关心它选了哪个共识、哪种存储——那些都是可以换的。值得记下来的是另一件事:它把「去中心化」从一个布尔值,拆成了一个可以分层的配置项。
四条要件:
- 保留关系模型和 SQL。理由是兼容:遗留系统、BI 工具、懂 SQL 的人全在这个生态里。
- 权限可验证、可撤销、能到行级。个体数据主权的最小可执行单位,是「表里的这一行」。
- 多租户:一张表同时服务多个数据所有者,各自只能看到自己的行。
- 执行去中心化:没有固定的 master,不能有一个节点永远知道所有事。
支撑这四条的是两条原则,第二条比第一条重要得多:
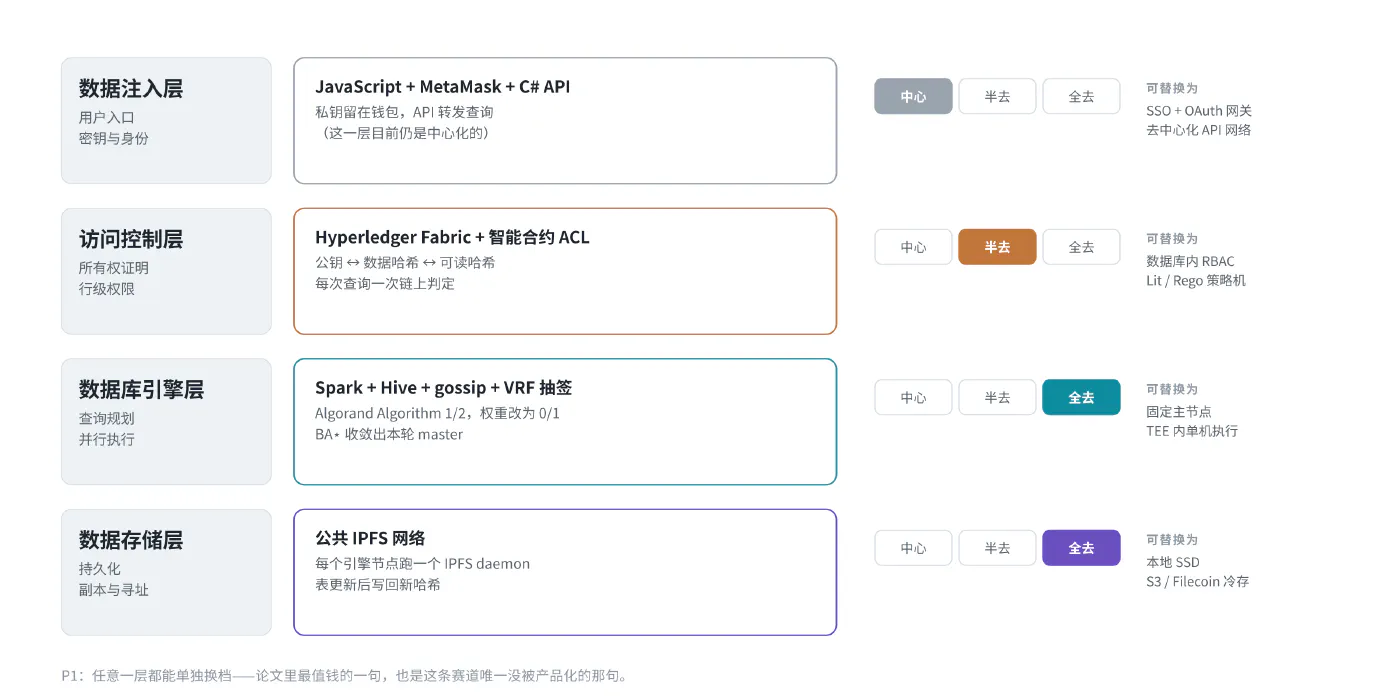
- P1 分层可插拔:任意一层可以单独选择去中心化程度。论文原话是"selectively decentralize any layer/component of their choice",目的是在不同场景下买不同的取舍。
- P2 主节点无状态:master 是抽签抽出来的临时工,除了私钥不留任何状态,用完即弃。
说 P1 值钱,是因为它承认了一件事:这四层可以分别买。前面那条赛道的所有悲剧,本质都是把布尔值当成了卖点。
四、把样本拆开:一次查询的六跳#
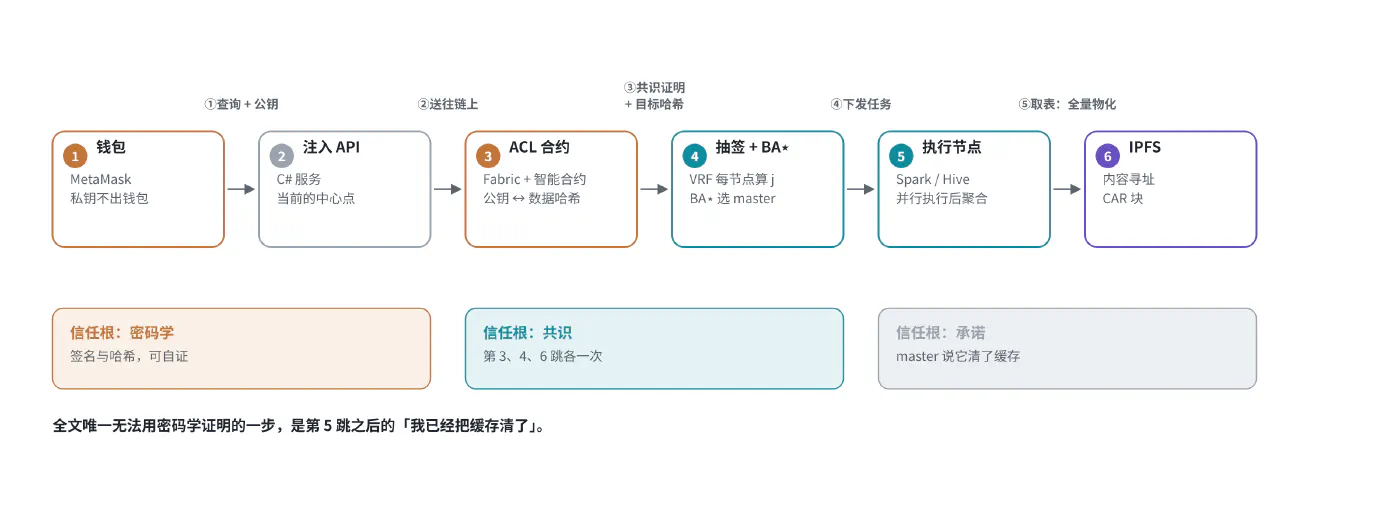
纸面上的分层容易,难的是四层怎么接起来。拆开看,一次查询要走六跳。
入口层:前端 JavaScript 接 MetaMask,用户的私钥始终留在钱包里;后端 API 是 C#。这是唯一没被去中心化的部分——论文自己在未来工作里承认了。
控制层:Hyperledger Fabric 加智能合约。ACL 里存三样东西——用户公钥、他拥有的数据哈希、他被允许访问的数据哈希。每次查询前,用户公钥和要访问的表一起送到链上,合约对照 ACL 判定,然后把对应数据的哈希交给执行层。
这里有个论文没展开的细节:身份在以太坊,权限在 Fabric。两套信任根、两条链、两种共识,中间的桥没写。原型阶段无所谓,生产环境里它是第一个会被攻击的地方。
引擎层:Spark 加 Hive,节点用 Boost.ASIO 组 gossip 网。收到查询后广播,每个节点跑 VRF 抽签(Algorand 的 Algorithm 1/2,改了权重、去掉了 role 参数),中签次数 j 由哈希落在二项分布的哪一段决定。结果送回链上,链上等一段时间收齐输出,用 BA⋆ 收敛出「谁是这一轮的 master」。master 干完活要做三件事:加密回传结果、把 worker 的权重置 1、把自己的权重置 0。清缓存靠 Spark 的 unpersist():
// engine: master 在查询结束后对缓存过的 RDD 调用 unpersist
rdd.unpersist(blocking = true)
存储层:公共 IPFS。每个引擎节点同时跑一个 IPFS daemon,表更新后写回 IPFS,新哈希回传 ACL。
五、代价:这套东西贵在哪#
| 决策 | 备选 | 理由 | 代价 |
|---|---|---|---|
| ACL 上链(Fabric) | 库内 RBAC | 可验证、不可否认 | 每查询一次链上判定 |
| 数据放公共 IPFS | 本地块设备 | 内容寻址、抗审查 | 全量物化 CAR 块 |
| VRF 抽签选主 | 固定主节点 | 抗针对性攻击 | 每查询一次 BA⋆ |
| 权重只有 0/1 | 按贡献加权 | 新节点不能立刻当主 | 女巫成本很低 |
| 清缓存 | 同态 / 加密执行 | 实现简单 | 全靠主节点自觉 |
| 选 CA | CP 或 AP | 一致 + 可用优先 | 分区时不成立 |
这张表里的每一行都不是这家独有的。整条赛道都在为同一件事付钱,只是账单换了名字:最贵的那一项是物化。
论文 §VI 自己写了这句:数据库引擎与 IPFS 之间的传输开销显著拉长执行时间,因为查询无法直接在 IPFS 的 CAR 格式上执行——这是一个 open problem。
翻译成人话:内容寻址存储卖给数据库的是「字节在哪」,数据库真正需要的是「把计算搬到字节旁边」。前者 Web3 已经做了十年,后者一天都没做。
六、数据:十八台机器买到什么#
把样本压到 TPC-H scale factor 10(约 10 GB)、22 条查询、AWS 跨 8 个 region 的机器上跑,得到下面这张表。
| 节点数 | 平均耗时 | 时间降低 | 加速比 | 并行效率 |
|---|---|---|---|---|
| 1 | 38.61 s | 0% | 1.00× | 100% |
| 2 | 36.26 s | 6.1% | 1.06× | 53.2% |
| 5 | 25.27 s | 34.6% | 1.53× | 30.6% |
| 10 | 16.56 s | 57.1% | 2.33× | 23.3% |
| 18 | 13.55 s | 64.9% | 2.85× | 15.8% |
上表全部由论文 Table III 的 22 行原始数据算出:平均耗时是算术平均,加速比 = 1 节点均值 / N 节点均值,并行效率 = 加速比 / 节点数。
三处需要核对的地方:
- 论文正文写「三个节点提升 20%」,但 Table III 只有 1 / 2 / 5 / 10 / 18 五列,没有 3 节点的行。这个数字无处可查。
- 论文说的 “improvement” 是耗时降低,不是加速比。64% 降低对应 2.85 倍,两个数字描述同一件事,读者很容易只记住更好听的那个。
- 22 条查询是顺序执行的,没有并发。测的是单查询延迟,不是吞吐——这一点论文没写,但 Table III 的形态说明了。
三条推论,论文没明说:
- 两个节点只买到 1.06 倍——第一次扩容几乎全被协调开销吃掉;
- 18 个节点是 2.85 倍,并行效率只剩 15.8%;
- 边际收益:5→10 节点是 0.14 倍/台,10→18 节点掉到 0.065 倍/台,腰斩一次。
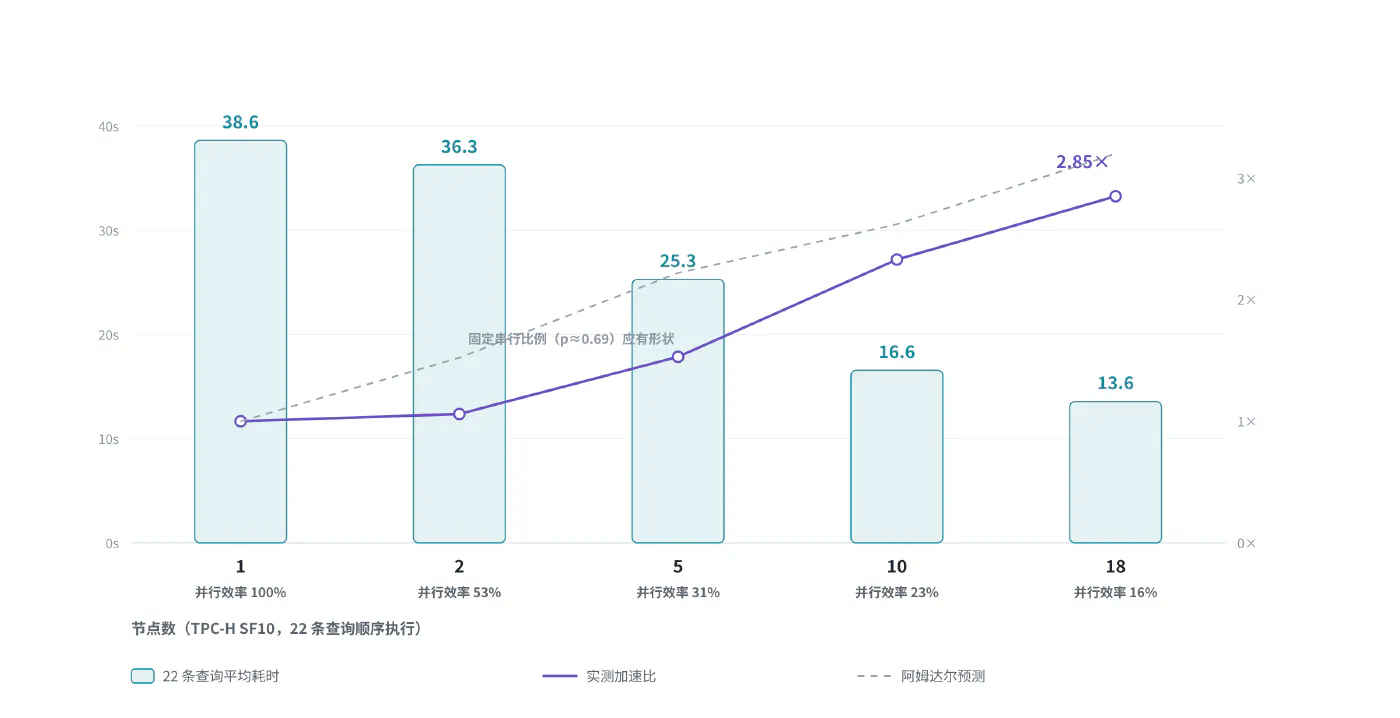
这不是「再加机器就好」的曲线,它已经在变平。同一篇论文里还有一句非常诚实的话:想扩到 20 节点,“the network was crashing every time on AWS”;分区不抗、必须假设「数据库引擎不会意外下线」,也都写在正文里。这种诚实在系统论文里并不常见。
更有信息量的是论文之外的动向:这个项目的主页现在主打 TEE 和 ZKP,不再提链上 ACL,实验室页面标着 archived。方向变了——从「共识强制权限」转向「硬件强制权限」。
七、赛道的三种活法#
把六条路线分别跟踪到 2026 年,会发现它们大多没有死,而是换了生意。
- 被买走:Kwil 的去中心化技术 2025 年 4 月归了 TRUF.NETWORK 并开源,仓库改名后从 0 开始。
- 停在原地:Tableland 拿到 800 万美元 A 轮之后没有下一个里程碑,SQLite 上链轨的方案仍在,但不再是叙事中心。
- 改卖别的:Space and Time 2025 年 5 月上主网,卖的是「证明」——ZK 证明你的查询没被篡改,而不是「存储」。
- 守住一侧:OrbitDB 做到 v3「功能完备」,2026 年 4 月放 v4 RC,明确只做本地优先、只做数据层。
- 换个名字:Golem DB 在 2026 年变成 Arkiv,以太坊 L2 下面挂多条 L3「数据库链」,按数据保留时长收费,自称「数据可用层」。
谁把自己的定位从「替代 MySQL」改成「给数据库加一个可验证的旁路」,谁就活得久一点。
八、你该怎么选:四个问题#
如果你的项目正在纠结「要不要上 Web3 数据库」,这张四问流程比任何选型表都有用:
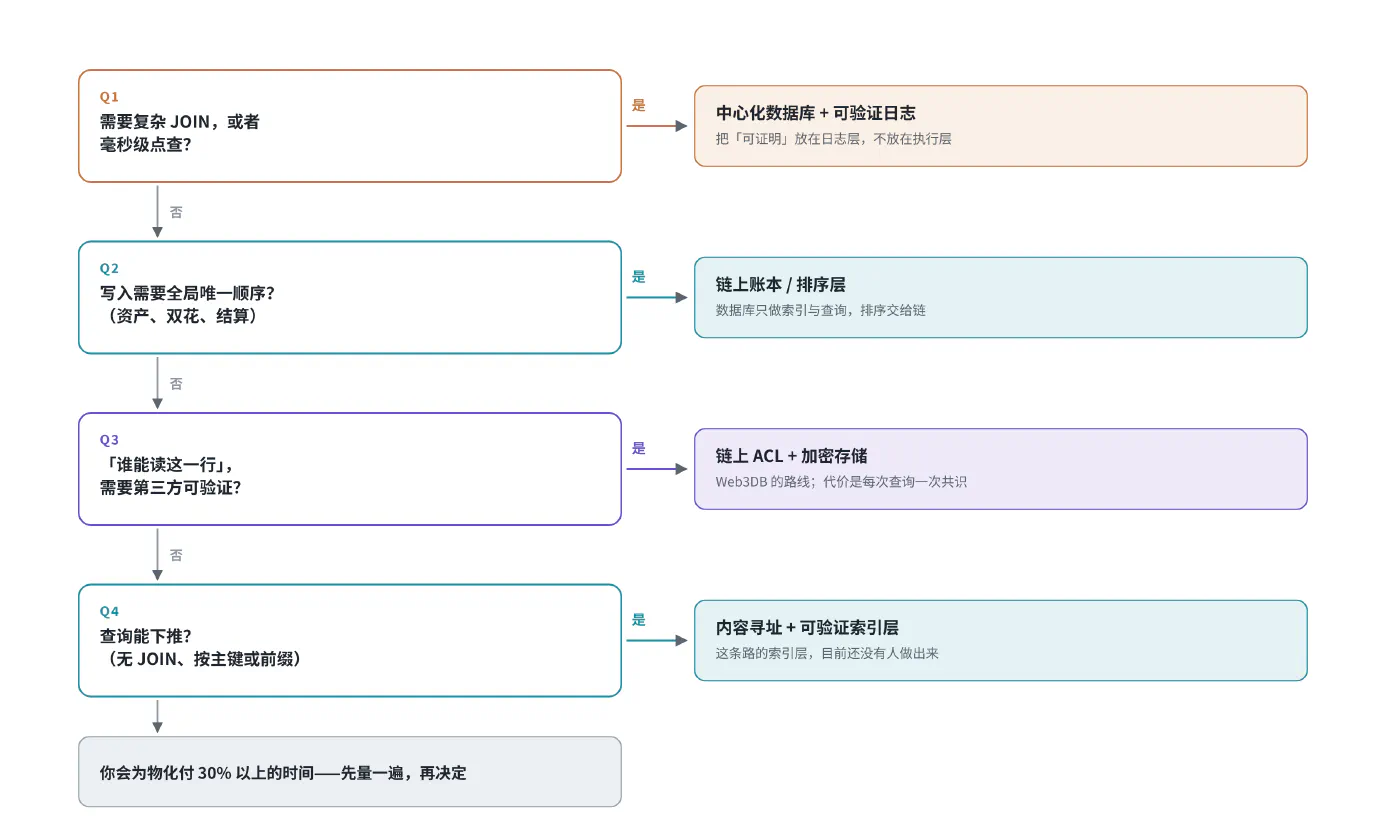
具体到一个今天就能跑的检查:把你的目标查询扔到 CAR 上量一次物化比例。如果取块和反序列化占总时间超过 30%,你的瓶颈就是 I/O——换任何共识算法都不会让它变快。
反例也要留着。有三类场景里,这套东西的代价是值得的:
- 审计日志、合规存档这类只追加、几乎不点查的数据;
- 多方共享、但任何一方都不该持有完整明文的数据(医疗、征信、供应链);
- 需要非否认的授权记录——谁在什么时候允许谁读了哪一行,这件事本身要能被第三方验证。
医疗场景正好落在后两类里,这也是这条路线能拿到 NSF 资助的原因。但它同时暴露了代价:为了「谁能读」这件事可验证,你付掉了「怎么读得快」。
九、两个还没有答案的问题#
- 如果执行节点必须看到明文,TEE 的信任根和区块链的信任根谁更高? 转向 TEE 说明团队已经选了硬件,但「用硬件证明软件没干坏事」和「用共识证明没人能改记录」是两种不同性质的信任,混着卖会出问题。
- 内容寻址存储能不能有可验证的索引? 没有索引就没有下推,没有下推就没有数据库。谁能把索引做成可验证、可增量维护、又能跟着块一起寻址,谁才真正解决了这条赛道的核心问题——而不是又发布一个「去中心化数据库」。
参考#
- 论文:Web3DB: Web 3.0 RDBMS for Individual Data Ownership (arXiv 2504.02713v1,2025-04-03;IEEE GBC 2025)
- 原型:web3db.org · lf-decentralized-trust-labs/web3db
- BigchainDB (v2.2.2,2020-09)· OrbitDB · GunDB
- TRUF.NETWORK 收购 Kwil 去中心化技术 (2025-04)
- Space and Time 主网上线 (2025-05-09)· Proof of SQL 技术文档
- Tableland A 轮融资 (2023-04)
- Arkiv(原 Golem DB):L2 + L3 DB-chains
- IceFireDB 文档:IPFS 之上的 NoSQL / SQL 中间件
- 数据来源:论文 Table II、Table III;GitHub API(2026-11-07 读取的 star 数与最后推送时间)