一句话:AI 把「写」的成本压到接近零之后,语言的价值就从「好写」挪到了「好审」——而 Go 过去十五年里的每一个取舍,恰好都压在审查这一侧。
这两篇原文是同一个月里的两篇文章,作者不同、场景不同,结论却撞在一起:Google Go 团队 8 月 11 日在开发者博客上写 《Why Go is an Ideal Language for AI-Assisted Software Engineering》;Steve Francia 在 spf13.com 上从 TypeScript 7.0 用 Go 重写这件事切入,写的是同一件事的另一面。两篇都不是基准测试,都是论证文——所以下面每一条我都标了它是谁说的、有没有被复测。
一、问题:限速点换了位置
先看一个具体场景。一个 coding agent 的工作循环是这样的:
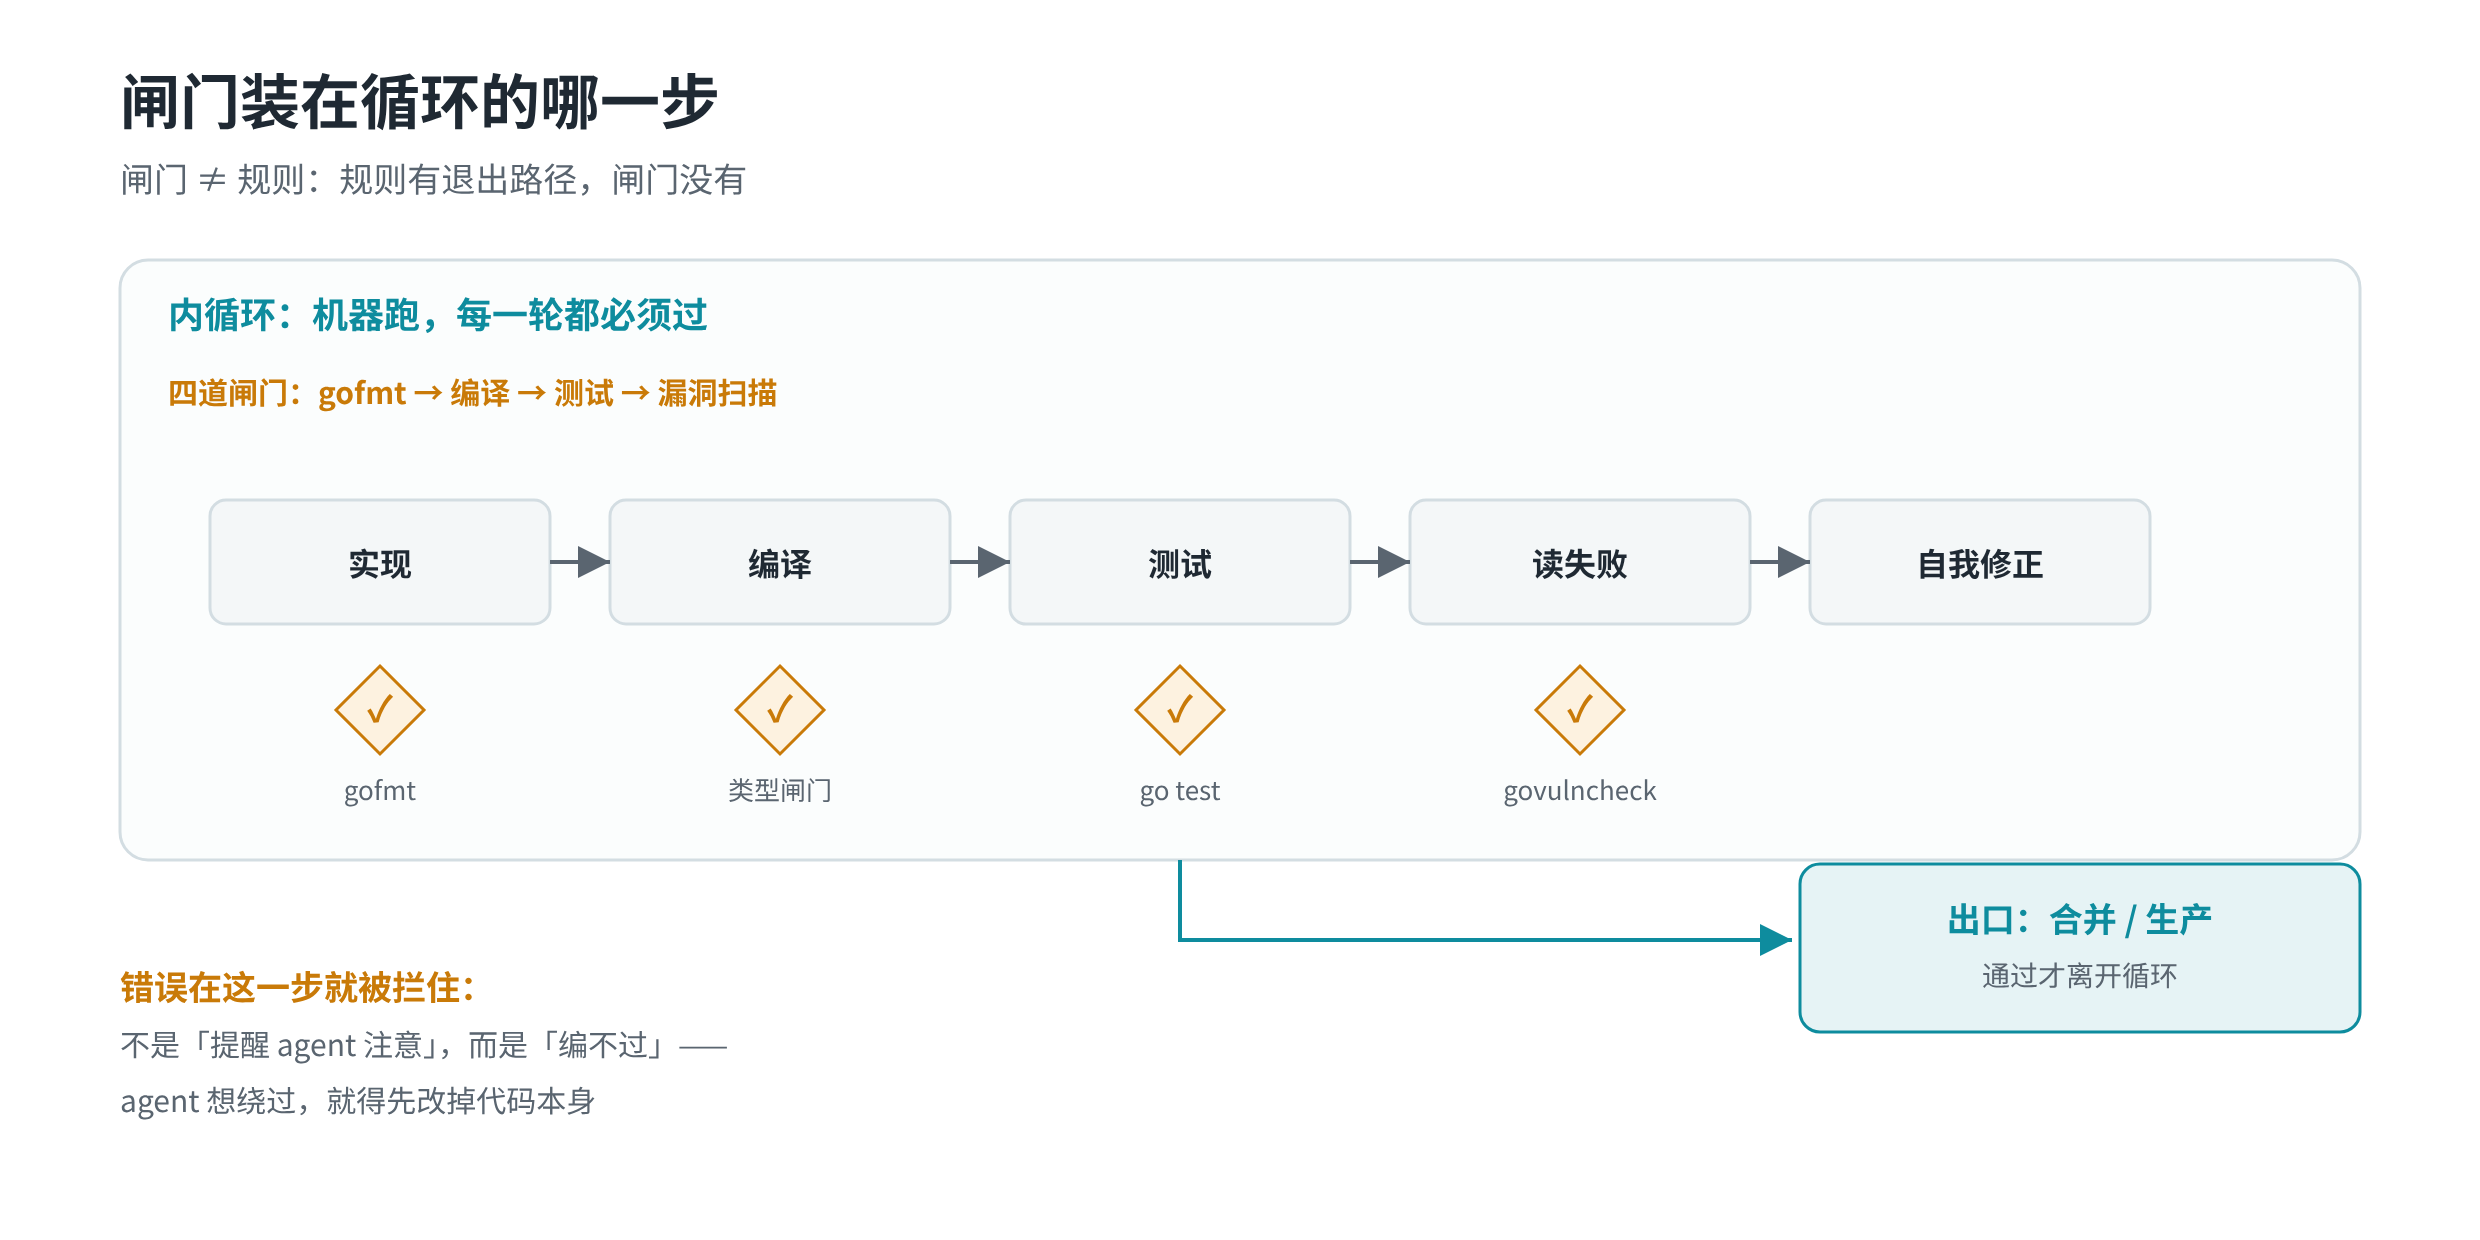
1实现 → 编译 → 测试 → 读失败信息 → 自我修正 → 回到第一步
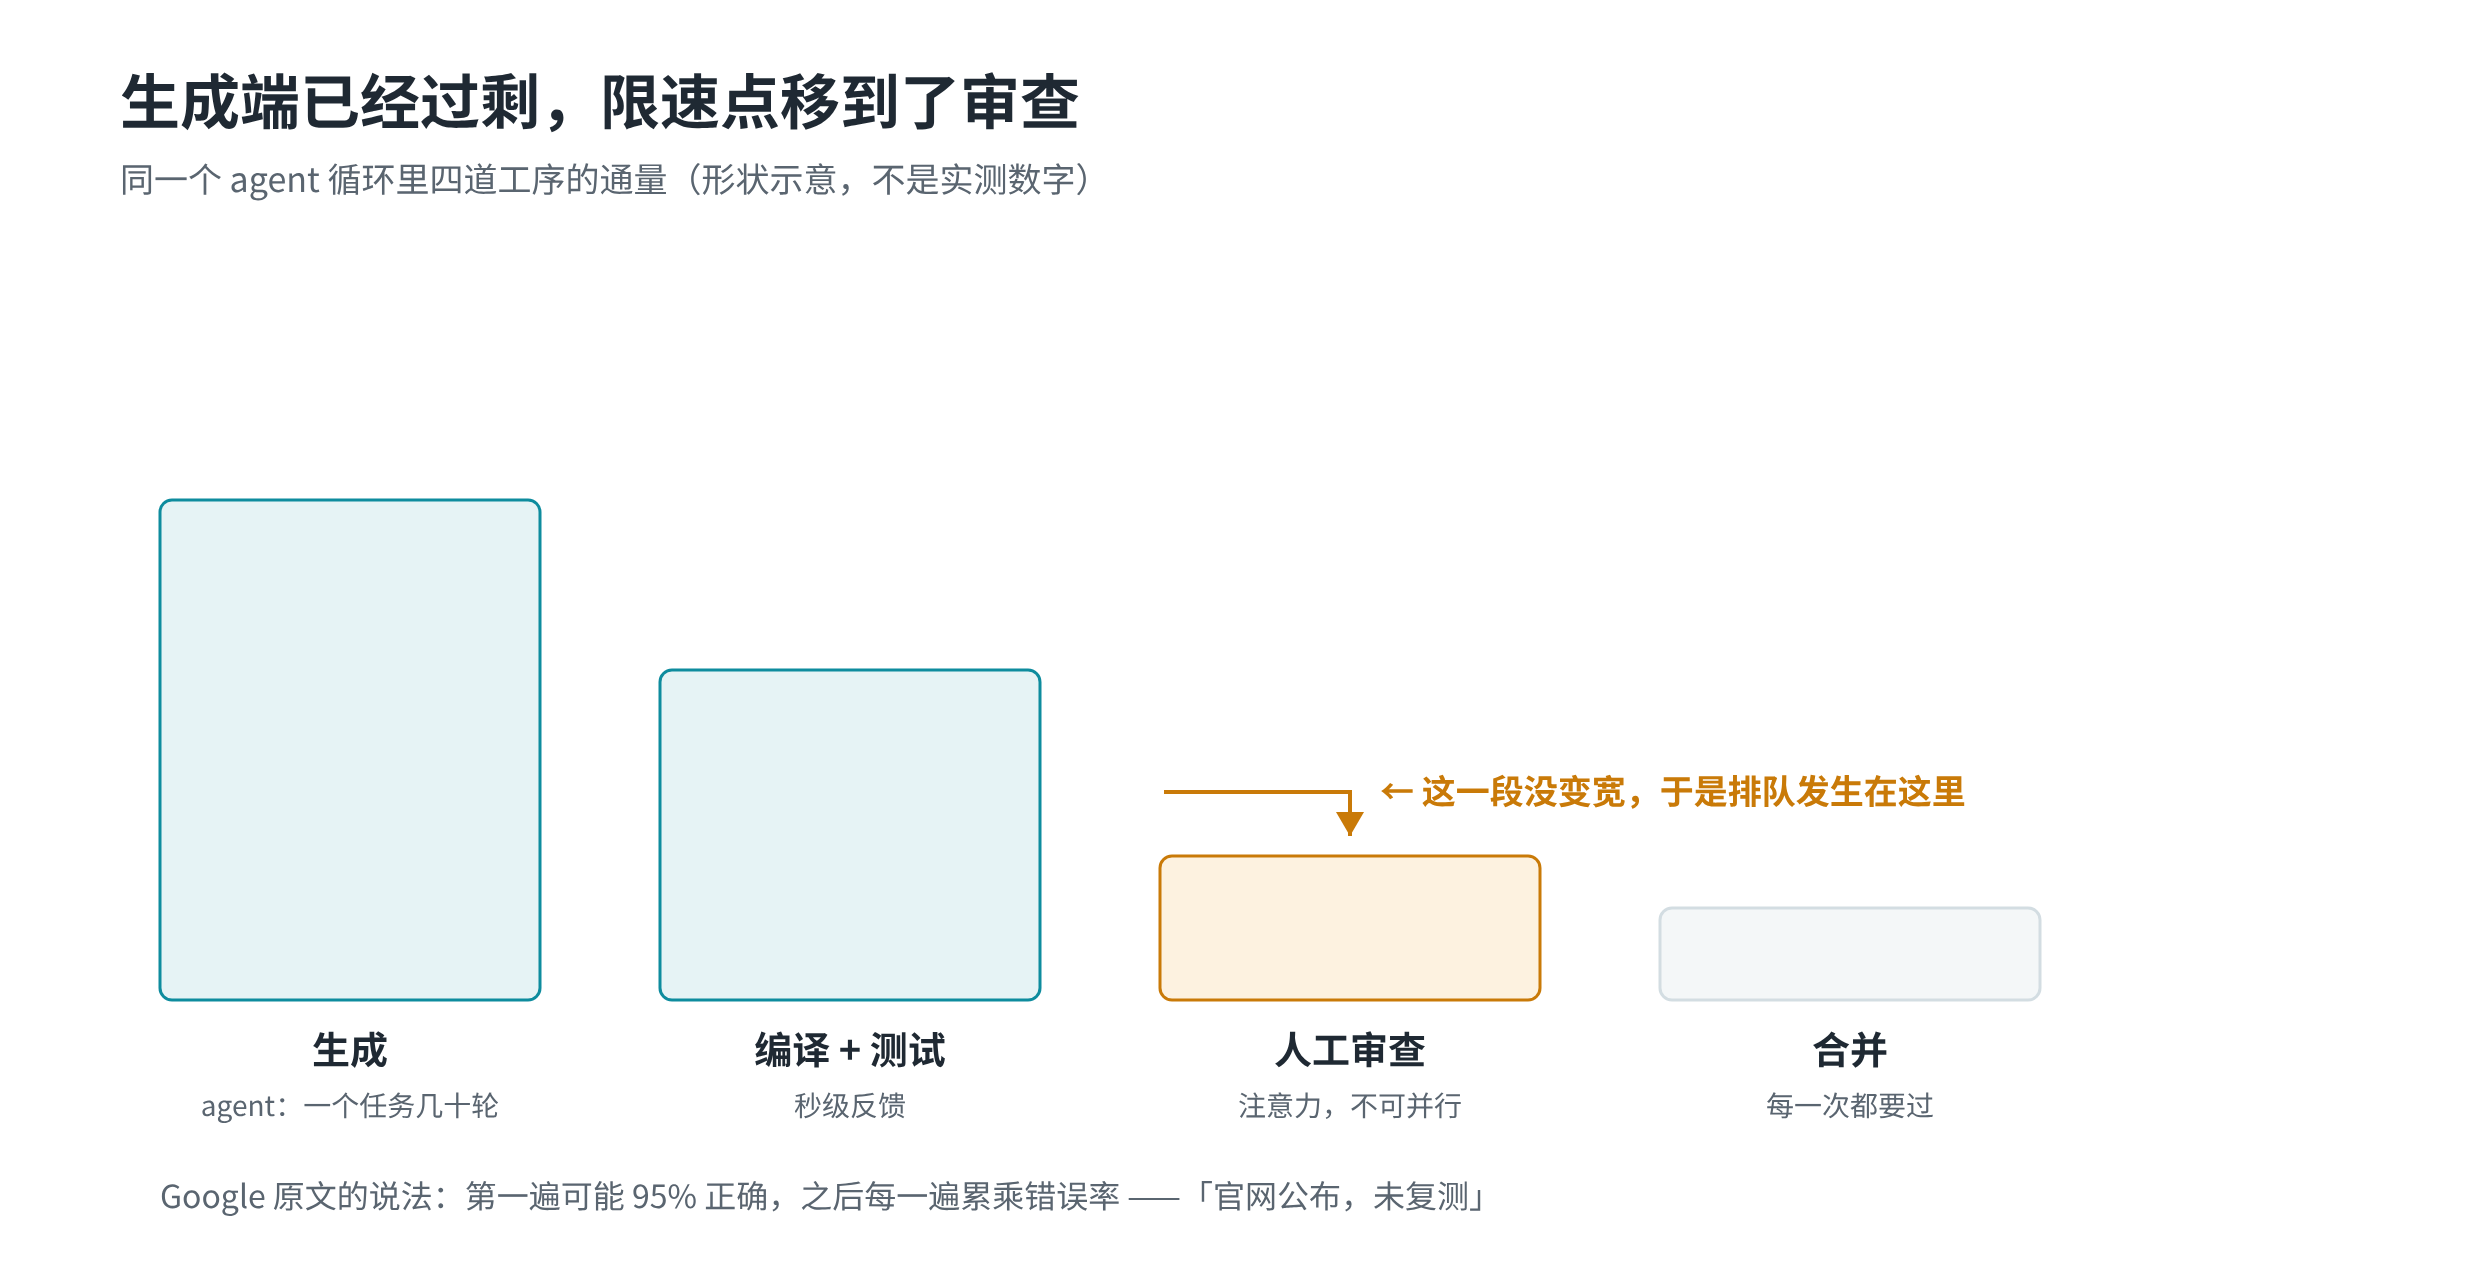
人手写代码时,这个循环一小时跑十几次;一个 agent 跑同一个任务,会跑几十次。循环的成本被乘以几十倍,于是循环里最贵的那一步,决定了你选什么语言。
而最贵的一步已经不是生成:
| 环节 | 2023 年的成本 | 2026 年的成本 | 谁在付 |
|---|---|---|---|
| 写出一行代码 | 高 | 接近零 | 模型 |
| 读一行代码 | 中 | 中,但量涨了十倍 | 人的注意力(不可并行) |
| 一次失败的循环 | 中 | 高:上下文 + API 费 + 时间 | 你和你的 token 账单 |
| 一次带 bug 的合并 | 高 | 更高:错误会被复制到后续每一轮 | 生产环境 |
Google 原文里有一句很朴素的判断:agent 在没有外部验证的情况下反复重构,第一遍可能 95% 正确,但每一遍都会把错误率累乘、污染上下文窗口,结果是准确率下降、token 成本上升。这句话没有附测量方法,属于作者的工程观察;但只要你跑过几轮长任务,就会认出这个形状。
Jesse Vincent 在讲 agent 编排时把这件事说得更硬:
规则有退出路径(我可以说「这件事做完就做」)。闸门没有——闸门不满足,下一个动作就被挡住。
这就是语言选择的真正含义。不是「哪种语言 agent 写得快」,而是哪种语言能在 agent 自己都没意识到的时候,把它挡住。
二、业界到哪一步了
先说清楚:这不是「Go 更快」的故事。TypeScript 7.0 的 Go 重写能成立,恰恰是因为 Go 在这里一点都不快——它只是容易让人和机器都读懂。微软公布的数字是构建时间约提升一个数量级,Anders Hejlsberg 给出的理由是务实的:原编译器函数化的写法几乎能一比一搬过去、两边都依赖 GC、共享内存并发带来了那 10 倍。公告里一次都没提 AI,但这个 1:1 搬运之所以可能,靠的正是「简单函数、没有隐藏魔法、一个团队能装进脑子里」这些属性。
这一点值得单独记住:一个为人类团队设计的语言,恰好也是为机器迭代设计的语言。
再看平台层现在是谁在写。这个清单比任何基准测试都说明问题:
| 项目 | 它是什么 | 语言 |
|---|---|---|
| Ollama | 本地跑模型的标准方式 | Go |
| Weaviate | RAG 与 agent 记忆背后的向量库 | Go |
| Temporal | 长时 agent 工作流的持久执行引擎 | Go |
| Charm Crush | 一个 AI coding agent CLI | Go |
| github/github-mcp-server | 把 agent 接到 GitHub 的参考实现 | Go |
「主张 → 后果」的对应表:
| 主张 | 后果(对 agent 循环而言) |
|---|---|
| 读优先,不是写优先 | 同一段逻辑只有一种写法,审查时注意力全在逻辑上 |
| 语言即平台:gofmt、go test、go mod、govulncheck、pprof、pgo 都在工具链里 | 循环里少掉「装什么、配什么」这一类失败点 |
| 兼容承诺:Go 1.0 的代码仍能编译,不会有 Go 2.0 | agent 的训练快照不会过期,不必每轮重新验证 API |
| go.sum + 校验和数据库 + 单一版本选择 | 依赖确定,没有安装期执行脚本的口子 |
| 完整标准库 | 少一个第三方依赖,就少一个幻觉入口 |
三、设计:四条要件,两条原则
把「Go 适合 agent」拆成可检查的要件,只有四条:
- 单一形状。 同一件事只有一种惯用写法,人写的、机器写的、十年前写的,看起来是同一个东西。
- 立即否决。 类型错误、未定义方法、不支持的运算,在编译期就被拒绝,不留到运行时。
- 确定性依赖。 同一个
go.mod在笔记本、CI、容器里解析出同一棵树;依赖不能在安装时执行任意代码。 - 长期不漂移。 代码不会因为升级而坏,旧写法有一条确定性的升级路径。
两条原则支撑这四条:
- 优化读者,而不是写者。 Rob Pike、Robert Griesemer、Ken Thompson 在二十多年前就是这么定的:开发者读代码的时间远多于敲代码的时间。人如此,模型更是如此。
- 把规则变成闸门。 一条规则有退出路径,一道闸门没有。语言的约束力来自「不过就编不过」,而不是来自文档里的建议。
第二条原则解释了为什么 Go 的 any 和 TypeScript 的 any 不是一回事。TypeScript 的 any 会把它接触到的一切的检查关掉;Go 的 any 只是 interface{} 的别名,每个使用点仍然被检查,想拿到具体类型必须先断言,而断言编译器也验。
四、实现:闸门装在循环的哪一步
4.1 编译器是循环里最便宜的一道闸门
Go 的编译速度是「数量级」级别的快——Google 原文的说法是比 Java、C#、Rust 快若干数量级(没有给基准,按官网公布处理)。这条属性的价值不在写代码,而在于它允许 agent 在每一轮里都跑一次全量检查。
一个典型的失败长这样:
1// 摘自 spf13 原文示例:Go 的逃生口本身也被检查
2func ProcessData(data interface{}) int {
3    return data + 1 // 编译错误:invalid operation(mismatched types interface{} and int)
4}
同样的错误在动态语言里要等到运行期:
1# 同样的逻辑:这里没有错误,错误发生在 agent 已经在它上面盖了三层之后
2def process_data(data):
3    return data + 1
区别不在错误本身,而在错误被发现的时刻。Go 把发现时刻提前到 agent 还没运行任何东西之前;动态语言把它推迟到 agent 已经花掉上下文、已经在这段代码上继续建造之后。这就是「复合利息」在工程上的版本。
4.2 上下文预算:少一层抽象,就少一批干扰项
Chroma 2025 年那项跨 18 个模型的研究(GPT-4.1、Claude 4、Gemini 2.5、Qwen3)测的是「上下文变长,性能会不会掉」,结论是会掉,连简单任务都会掉;最大的杀手是他们称为 distractor 的内容——话题相关但不含答案。一个干扰项就掉分,四个叠加伤害更大。
对一个正在追 bug 的 agent 来说,一条继承链、一层 mixin、一个装饰器栈,就是一整片干扰项:super() 在菱形继承里解析到哪个方法、metaclass 在运行时改了什么行为、三层之上的 override——这些都不是它要的逻辑,但它必须全部加载、权衡、排除,而且是在它推理能力已经开始退化的那个窗口里。
Go 的形状是:一个文件需要的东西,就在这个文件和它直接 import 的包里。没有继承链,没有 mixin,方法分派只按名字,编译期就定死。代码需要的 token,几乎全是相关的 token。
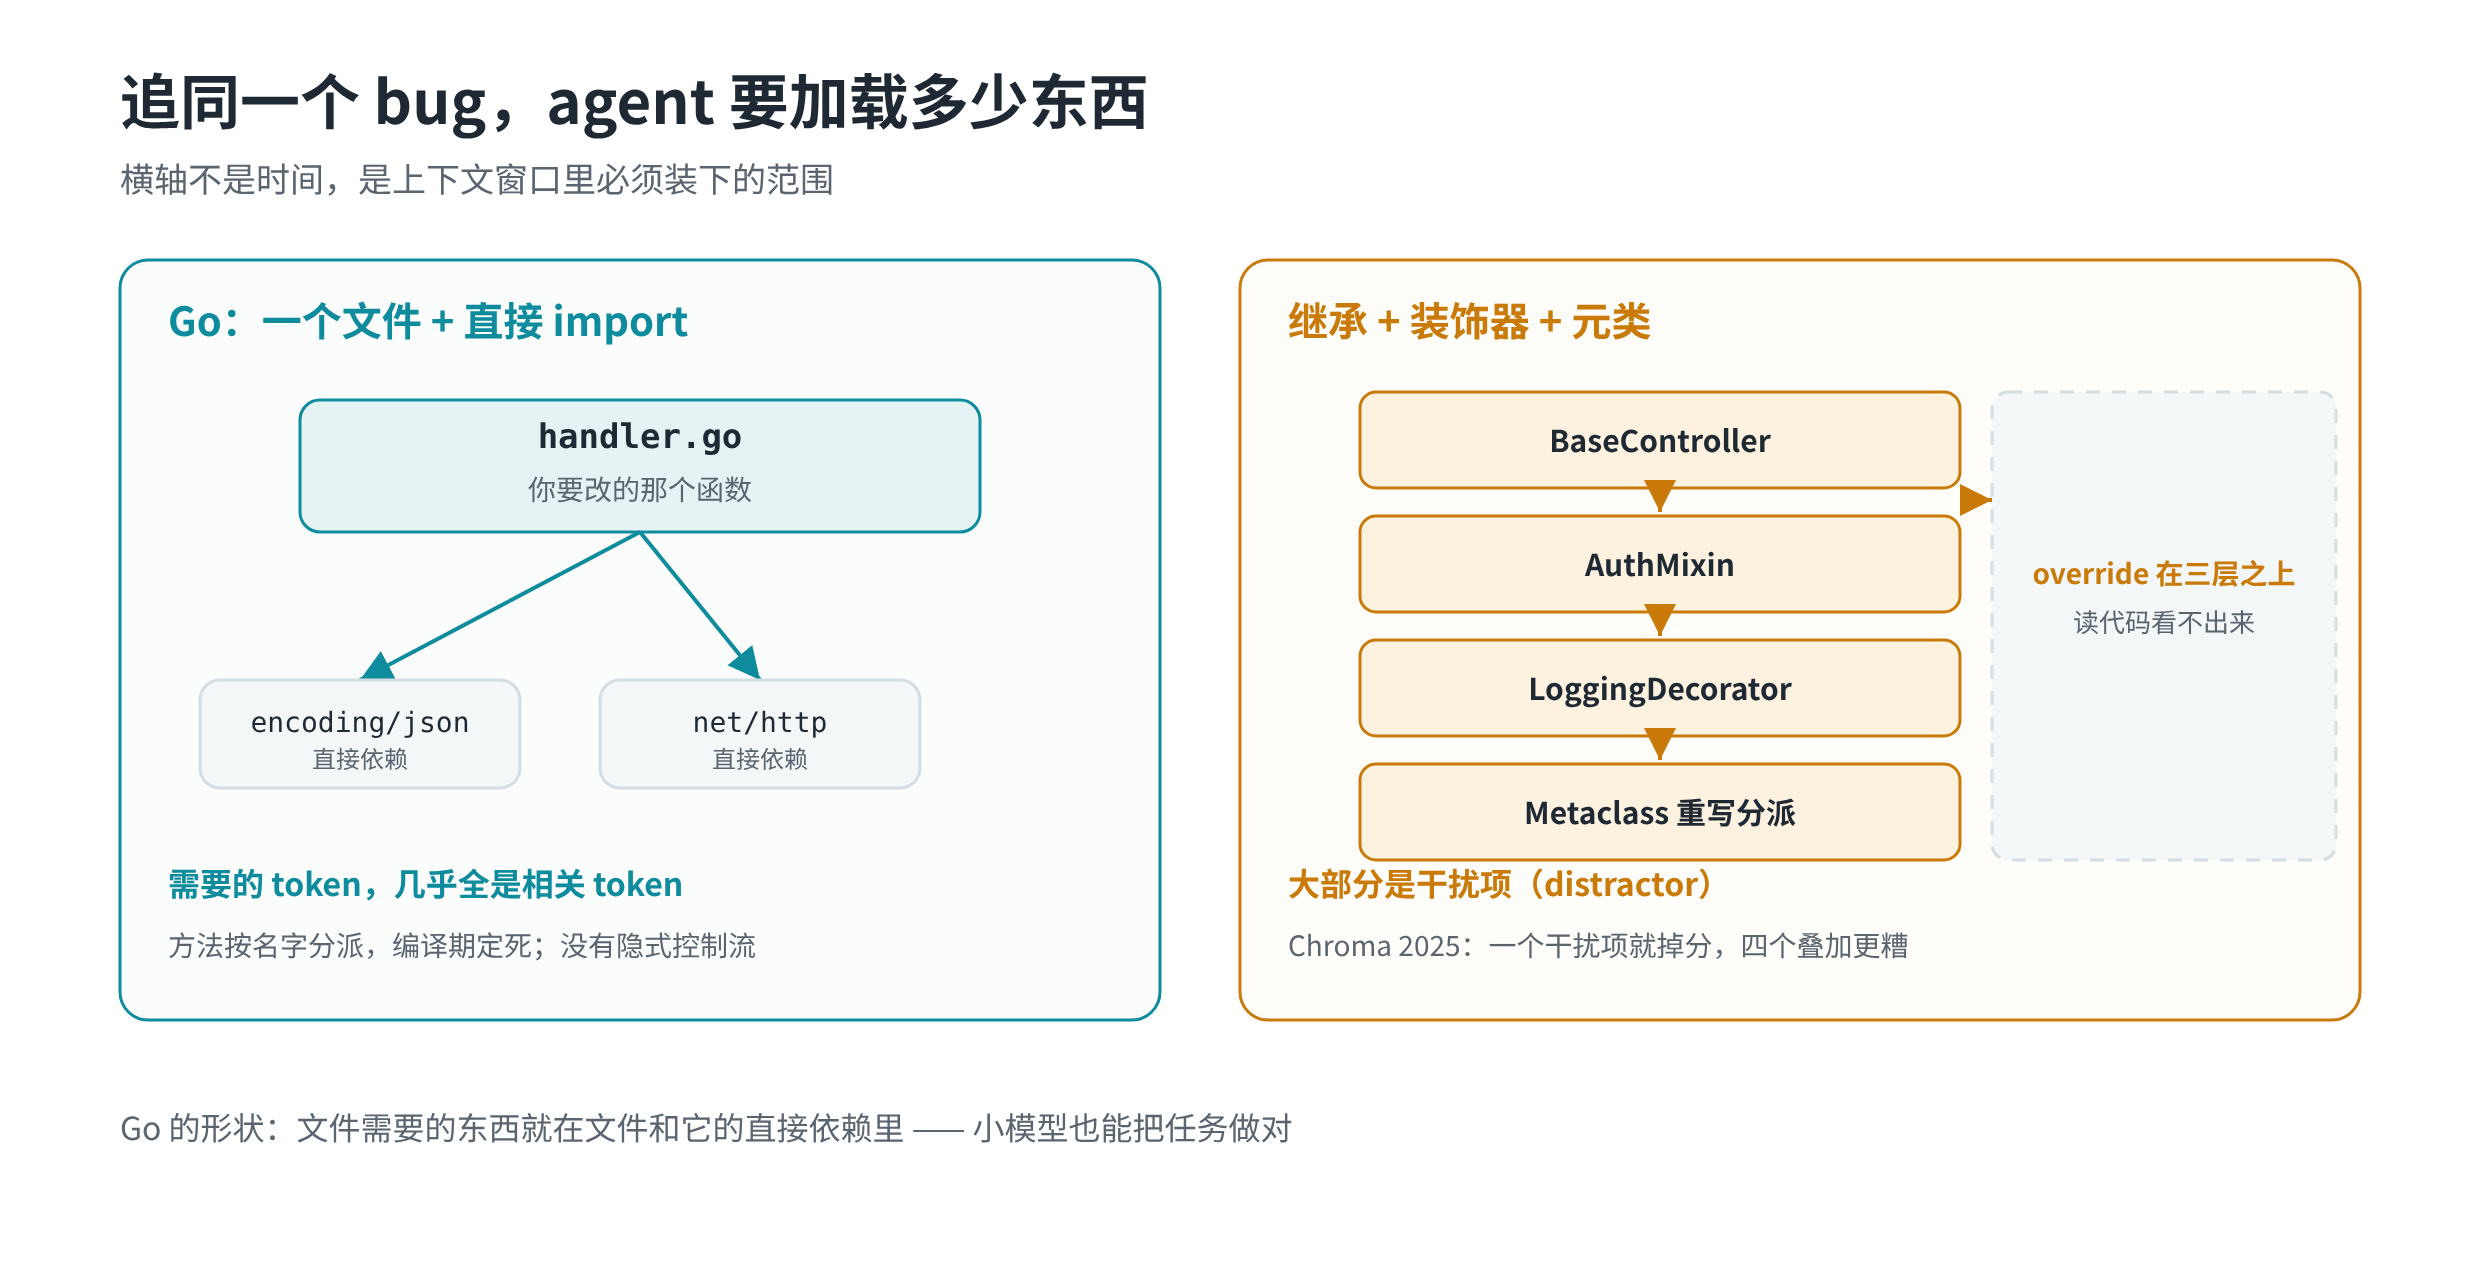
这还有一个副产品:任务需要的模型档位会降下来。两万干净 token 能装下的 bug,不需要靠最贵的前沿模型来推理;这也意味着任务补贴退坡之后,这套成本结构仍然成立。
4.3 一种格式,零个风格争论
gofmt 随 Go 发行,社区全员在用。于是每一个 Go 文件——人写的、机器生成的、十年前的、agent 今早写的——结构上完全一致。Simon Willison 在折腾 AI 辅助的 Go 工具时说过一句很到位的话:「通常只有一种显而易见的做法,产出的代码无聊而可读——而这正是 LLM 非常擅长写的。」
对 agent 来说,gofmt 还有第二重作用:它可以在开工前被「播种」。指向标准库(encoding/json、net/http、io),agent 直接产出惯用代码,不需要猜用 black 还是 yapf、isort 还是 ruff。审查时,注意力全在逻辑上,不在格式噪声上。
4.4 依赖、供应链与维护期
- 依赖:
go mod tidy是确定性的,笔记本、CI、容器解析结果一致;go.sum钉住校验和,全局校验和数据库挡住中间人替换;没有postinstall这类安装期执行钩子。 - 漏洞:
govulncheck只报你实际调用到的脆弱符号,噪声低——这一点对 agent 尤其重要,噪声高的告警会训练 agent 忽略告警。 - 测试:
go test ./...不需要选框架,_test.go放在包边上,fuzz 是内建的。想让 agent 走 TDD,这条闸门是确定性的。 - 维护期:
go fix重写后带上了 modernizer——几十个预置转换,把旧 idiom 确定性地升级到新写法。加上gopls,agent 可以安全地重构包、清理技术债,而不是靠「看起来对」。
五、取舍与代价
这些好处都不是免费的,代价写在下面这张表里:
| 决策 | 备选 | 理由 | 代价 |
|---|---|---|---|
| 静态类型 + 编译闸门 | Python / TypeScript | 错误在编译期被发现,不留到生产 | 写起来更啰嗦;泛型表达力明显弱于 Rust(没有高阶类型、没有生命周期) |
| 一种写法 | 多范式语言 | 审查成本最低,人和机器读的是同一个形状 | 换掉了表达力:类型级编程、DSL、宏,基本做不了 |
| 内建工具链 | 自由选生态 | 循环里少一批失败点 | 生态创新空间被收窄,框架风格单一 |
| 兼容承诺 | 大版本演进 | 训练快照不过期,旧代码不会坏 | 语言演进慢,历史包袱只能一直背着(Go 不会再有 2.0) |
| 系统层默认 | Rust | 编译快、重构改动局部化 | 需要极致性能、无 GC、或把内核嵌进 Python 包时,Rust 更对;Go 1.26 把 cgo 调用基线开销降了约 30%,仍不如 PyO3 那条路 |
| 上下文友好 | Java / TS 的抽象层 | 相关 token 比例高,小模型也能写对 | 失去了继承与 mixin 带来的代码复用,样板更多 |
有一个反例必须留着,否则上面整张表都不可信:Rust 的位置没有被 Go 抢走。 pydantic 的校验核心、Polars、HuggingFace tokenizers、Astral 的 uv,全都是 Rust——因为它们要的是零成本 C ABI、无 GC、可嵌入 Python 轮子,这恰好是 Go 历史上最弱的一格。Rust 的编译器报错还特别有教育意义,对 agent 来说是真正有用的信号。分歧出现在代价上:Rust 编译慢、生命周期与 trait bound 让「一处改动」在重构时向外扩散,而重构频率正是 agent 时代被放大最多的变量。
六、现在到哪一步
证据是分层的,按可验证程度排:
- 已被第三方对照过的:TypeScript 7.0 的 Go 重写,构建时间约一个数量级(微软公布)。
- 已经发生在生产里的:上面那张平台层清单——Ollama、Weaviate、Temporal、Crush、github-mcp-server。
- 只在这一年里出现、还没有独立复测的:
go fix的 modernizers、go-skills这类给 agent 预置 Go 知识的仓库。 - 一个诚实的反直觉案例:PayPal 有个团队用大约十名工程师把一套 C++ 数据库重写成 Go,生产性能超过原系统、维护成本低得多。Go 并不比 C++ 快,所以赢的不是代码速度,而是团队能读懂、能改、能扩——也就是「实现的性能」压过了「理论的性能」。
分工的形状大概是这样:
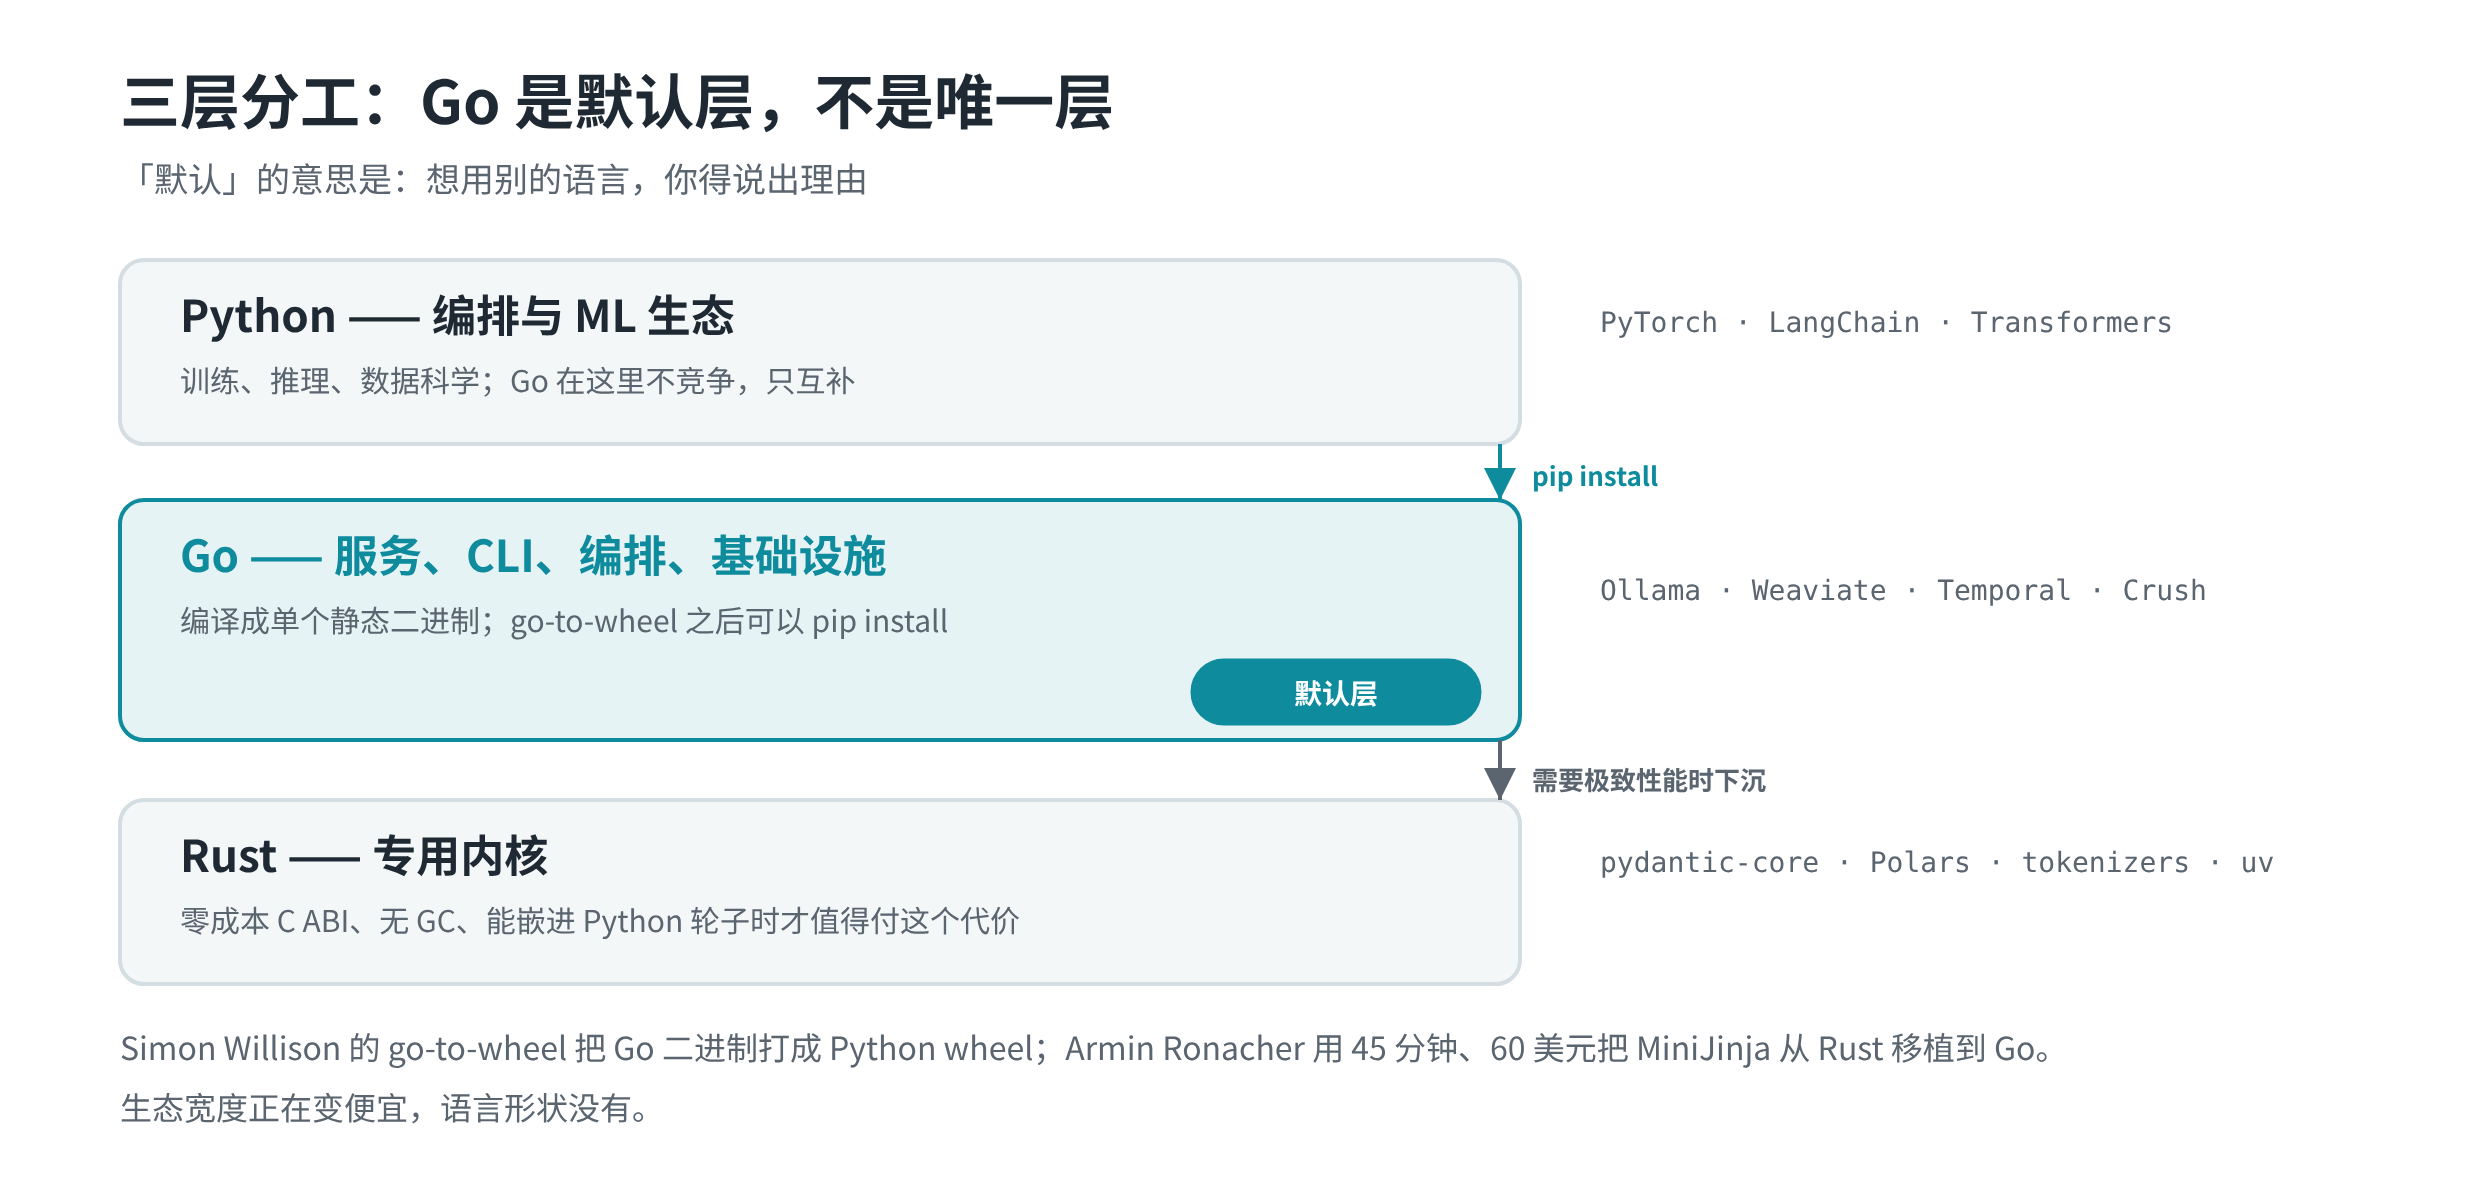
Python 编排,Go 在下面执行,两者不是二选一。Simon Willison 的 go-to-wheel 把编译好的 Go 二进制打包成 Python wheel,pip install 或 uvx 一行装走;他自己的 sqlite-scanner 就是这么发的。Armin Ronacher 从另一个方向给了同一个结论:把 MiniJinja 从 Rust 移植到 Go 花了 45 分钟、60 美元 API 调用,所以他主张「写代码的成本正在急剧下降,生态的宽度就没那么重要了」。
七、数据(分清来源)
| 指标 | 值 | 来源 |
|---|---|---|
| TypeScript 7.0 构建时间 | 约 10 倍提升 | 微软公布,未复测 |
| Go 1.26 cgo 调用基线开销 | 降低约 30% | go.dev 发布说明,官网公布 |
| Go 编译器速度 | 比 Java、C#、Rust 快若干数量级 | Google 博客表述,未给基准 |
| Chroma 上下文实验 | 18 个模型;输入越长越差;1 个干扰项即掉分,4 个叠加更差 | Chroma 2025 研究,第三方公布 |
| Go 1.0 代码 | 最新工具链可直接编译 | 兼容承诺,官网公布 |
| PayPal C++ → Go 重写 | 约 10 名工程师;生产性能超过原系统 | spf13 文中转述的团队案例 |
| MiniJinja Rust → Go 移植 | 45 分钟,60 美元 API | 作者公布 |
| Octoverse 2025 | TypeScript 月贡献者超 Python/JS;JS 新建仓库仍约为 TS 的两倍 | GitHub 公布 |
| agent 单任务迭代次数 | 数十次;人一小时十余次 | 量级估计,示意 |
八、读者能自己验证什么
把「闸门」这件事变成一条命令,扔进 agent 的循环里,每一轮都必须过:
1# 四道闸门串成一条命令:格式 → 静态检查 → 测试 → 漏洞
2gofmt -l . | (! grep .) && go vet ./... && go test -count=1 ./... && govulncheck ./...
然后做一个 15 分钟的对照实验,别信任何人的结论,包括这两篇原文:
- 同一个 agent、同一个任务:「读 10 万行 JSON、聚合、写 CSV」的 CLI。
- 分别用 Go 和 Python(或 TypeScript)实现,两个语言各跑三次。
- 记录三个数:iterations-to-green(到第一次测试全绿用了几轮)、总 token 消耗、人工审查时长。
- 把
-count=1加上,否则go test的缓存会把你骗过去。
你大概率会看到:Go 那边轮数少、单轮 token 少、审查快;Python 那边第一轮出代码更快,但轮数多。如果你的任务里有大量 ML 库调用,结论会反过来——那就说明它属于 Python 那一层,不属于系统层。
九、路线图与开放问题
两个我现在答不上来的问题:
- Go 的「少表达力」会不会反而更费 token? 没有继承、没有 mixin、泛型也克制,意味着同样的功能要写更多样板。样板是确定的、好读的,但它是真实的 token。目前没有公开的「同一任务、两种语言、token 总量」的对照数据,这恰恰是上面第八节那个实验该测的东西。
- 兼容承诺和 modernizer 会不会互相抵消? 兼容承诺让旧代码永远能编,于是旧 idiom 也永远能编;agent 的训练快照里对旧写法的偏好,可能让
go fix从「可选的美化」变成「必须的清理步骤」。如果真是这样,「工具链一致性」这项优势的维护成本,比 Google 原文描述的更高。
还有一个更基础的问题:我们是不是在用语言补偿模型能力的不足? 如果三年后模型的自我验证能力足够强,静态度量带来的收益会收窄,那么「为审查而设计」的语言优势也会收窄。反过来说,如果模型的迭代次数继续涨,闸门的价值只会更高。这两种未来对应两种完全不同的语言策略,而现在没有人有数据能分辨。
参考
- Google Developers Blog, Why Go is an Ideal Language for AI-Assisted Software Engineering(2026-08-11)
- Steve Francia, Why TypeScript 7.0 Was Rewritten in Go(spf13.com,标题即《Go: the agentic language》)
- Microsoft, A 10x faster TypeScript
- Chroma, Context Rot: How Increasing Input Tokens Impacts LLM Performance
- Wes McKinney, Agent ergonomics
- Jesse Vincent, Rules and gates
- go.dev, Go 1 compatibility promise / Go 1.26 release notes
- Armin Ronacher, A language for agents